이전에 OpenAI가 공개한 GPT-5.6 Sol, Terra, Luna를 정리하면서, 모델의 방향이 단순한 추론 성능 향상에서 사용 목적에 맞는 모델 선택과 실제 업무 활용으로 확장되고 있다는 점을 살펴봤다.
이번에는 그 다음 세대인 GPT-6 Astra가 공개됐다.
GPT-6 Astra는 기존 GPT-5.6 Sol보다 여러 벤치마크에서 성능이 올라갔지만, 이번 발표에서 더 눈에 띄는 부분은 단순한 지능 점수가 아니다.
핵심은 오히려 다음에 가깝다.
추론하고, 도구를 사용하고, 컴퓨터를 직접 조작하면서 하나의 업무를 끝까지 수행하는 능력
즉 GPT-6 Astra는 기존의 대화형 AI에서 한 단계 더 나아가, 실제 업무를 맡길 수 있는 Agent형 모델에 더욱 가까워졌다.
1. GPT-6 Astra에서 가장 강조된 것은 Computer Use
OpenAI는 GPT-6 Astra를 발표하면서 가장 먼저 Computer Use 능력을 강조했다.
기존 LLM은 브라우저나 프로그램을 사용할 수 있더라도 기본적으로는 사용자의 요청을 해석하고, 필요한 도구를 호출하는 정도에 가까웠다.
Astra는 여기서 더 나아가 실제 화면을 보고 여러 단계의 작업을 이어가는 능력이 크게 강화됐다.
예를 들어 다음과 같은 작업이 가능하다.
- 온라인 폼 작성
- CRM 고객 정보 수정
- 캘린더 정리
- 웹 리서치
- 문서 작성
- 데이터 분석 및 그래프 생성
- 웹사이트 제작
- Frontend QA
- 프로그램 설치 및 테스트
- 화면에 나타난 오류를 보고 문제 해결
OpenAI가 공개한 OSWorld 2.0 결과를 보면 이를 확인할 수 있다.
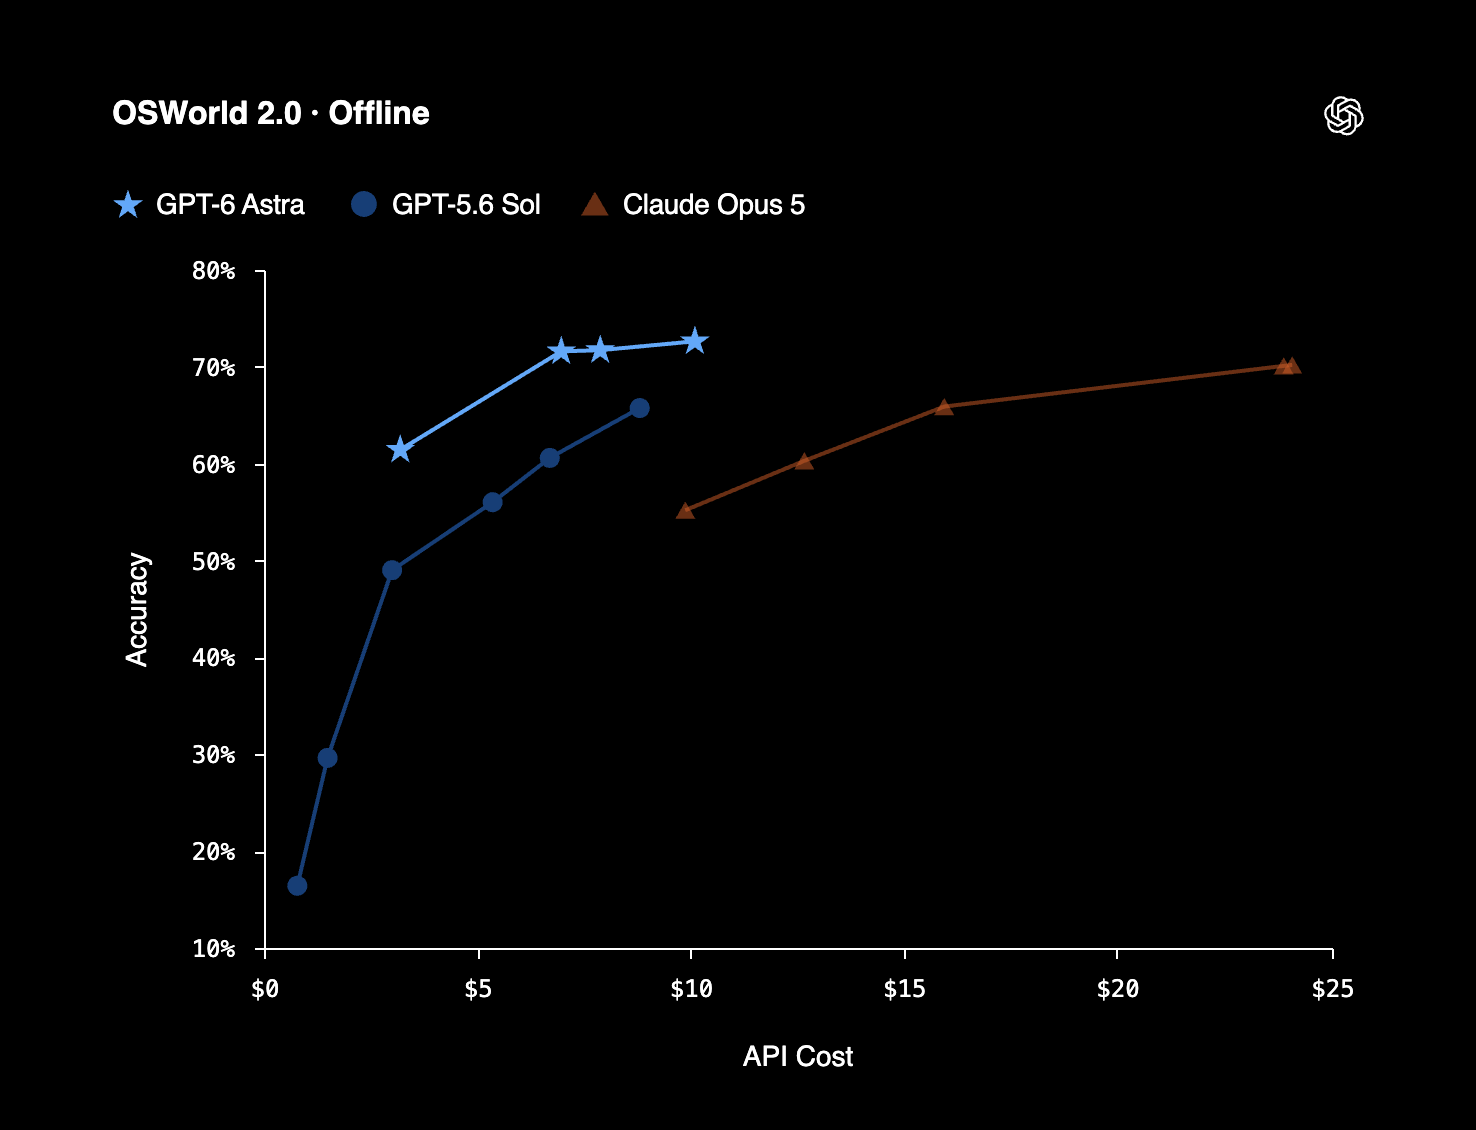
특히 흥미로운 부분은 단순히 성공률만 올라간 것이 아니라 작업 속도도 크게 줄었다는 점이다.
OpenAI의 OSWorld 시뮬레이션에서는 동일한 유형의 작업을 처리하는 데 GPT-5.6 Sol은 약 75분이 걸린 반면 Astra는 약 40분이 걸렸다. 약 47% 정도의 작업 시간이 줄어든 셈이다.
이제 Computer Use는 단순한 실험적 기능이 아니라 Agent 성능을 판단하는 핵심 지표 중 하나가 되어가는 모습이다.
2. 문서 작성에서 ‘결과물 제작’으로
GPT-6 Astra에서는 Professional Work 영역도 크게 강화됐다.
여기서 OpenAI가 강조하는 개념은 단순한 텍스트 생성이 아니라 Artifact 제작이다.
예를 들어 사용자가
“이 데이터를 분석해서 보고서와 발표자료를 만들어줘.”
라고 요청했다고 해보자.
기존 모델의 역할은 대체로 다음과 같았다.
데이터 분석
    ↓
내용 작성
    ↓
사용자가 Excel / PPT에 옮김
반면 Astra가 지향하는 방식은 조금 다르다.
데이터 분석
    ↓
필요한 정보 추출
    ↓
Spreadsheet 작성
    ↓
그래프 생성
    ↓
Presentation 제작
    ↓
문서 형식 확인
    ↓
최종 결과물 생성
OpenAI는 Astra가 기존 회사 템플릿이나 문서 스타일을 이해하고, 그 스타일을 유지하면서 문서·Spreadsheet·Presentation을 직접 만들어내는 능력을 강화했다고 설명한다. AutomationBench에서도 이러한 차이가 크게 나타났다.
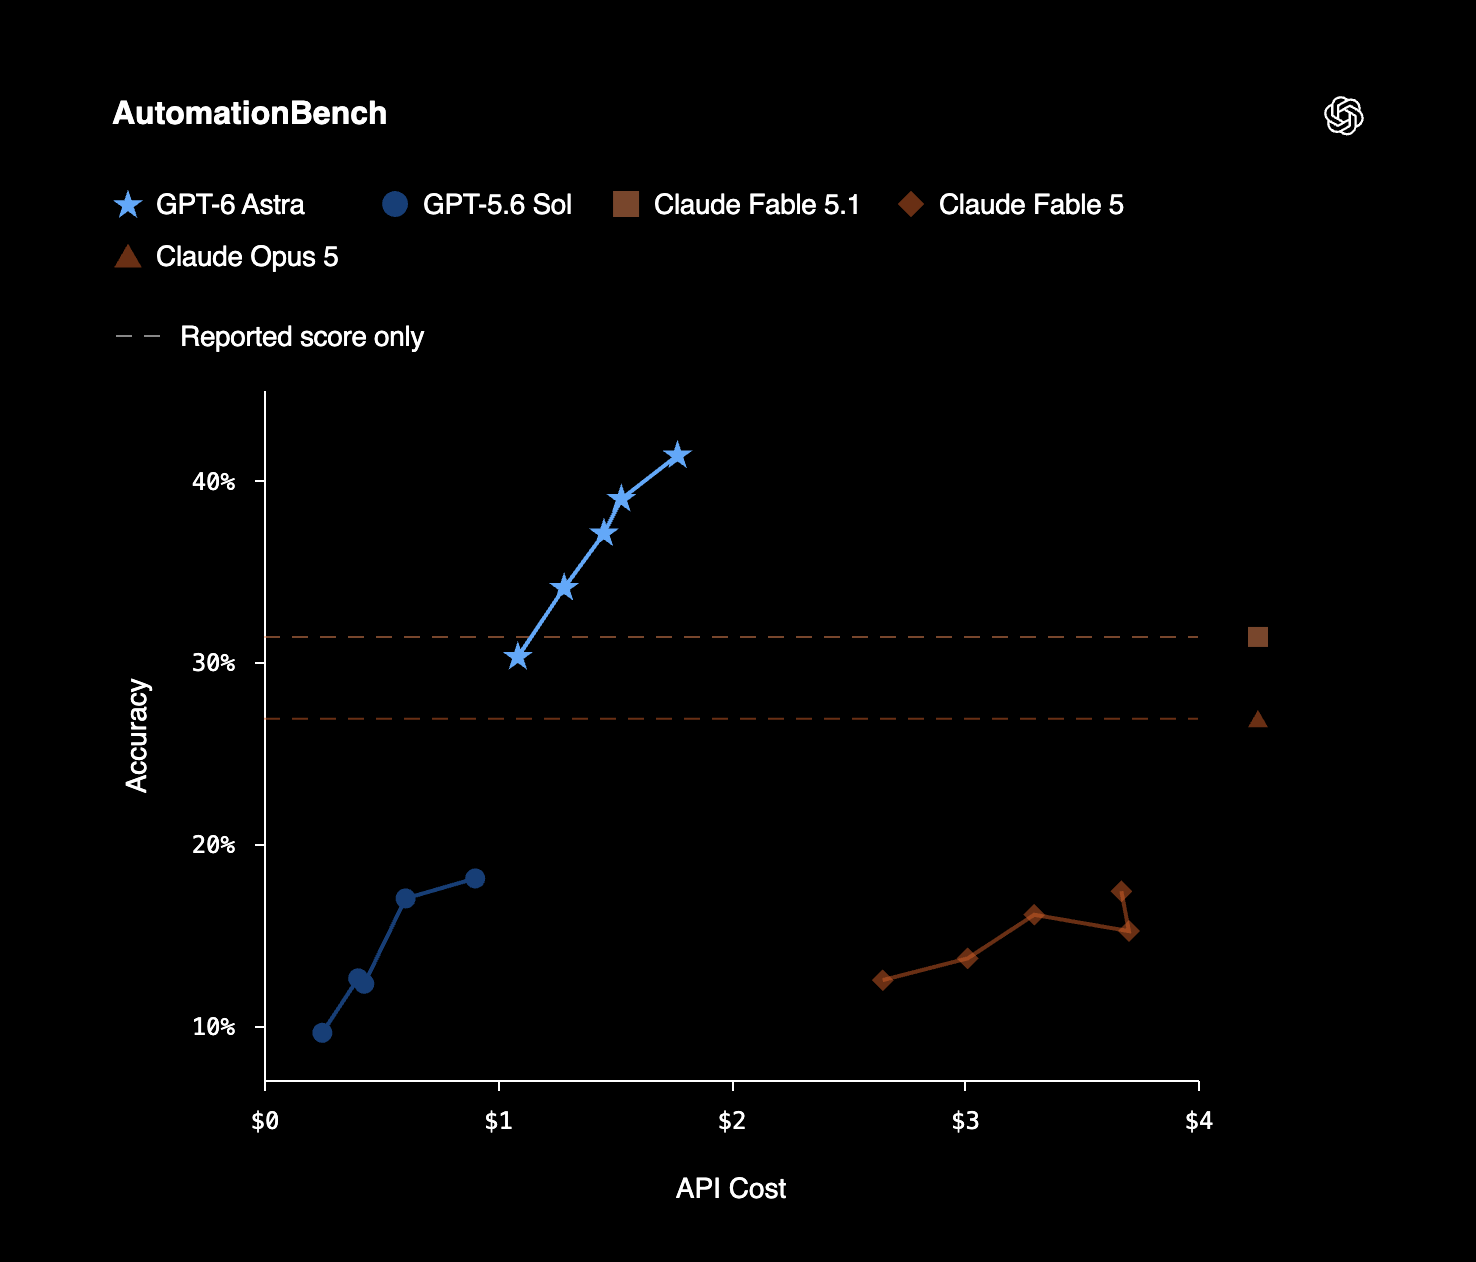
특히 GPT-5.6 Sol과 비교하면 18.1%에서 41.4%로 두 배 이상 증가했다.
이 수치는 Astra가 단순한 질문 답변보다 여러 단계를 연결해서 실제 업무를 완료하는 능력에서 큰 개선이 있었다는 점을 보여준다.
3. Agent 작업 중에도 사용자가 방향을 바꿀 수 있다
Agent를 실제로 사용하다 보면 꽤 자주 발생하는 문제가 있다. AI에게 긴 작업을 맡겼는데 중간에 요구사항이 바뀌는 경우다.
예를 들어,
사용자:
이 데이터를 분석해서 보고서를 만들어줘.

AI:
분석 진행 중...

사용자:
아, 매출 그래프도 추가해줘.
그리고 지역별 결과는 빼줘.
기존 Agent는 이런 추가 요청을 새로운 작업처럼 받아들이면서 원래 목표를 놓치는 경우가 있었다.
GPT-6 Astra는 이 부분을 개선한 Mid-turn Steering을 지원한다. 즉 Agent가 작업하는 중간에도 사용자가 요구사항을 변경하거나 추가할 수 있다.
초기 목표
    ↓
Agent 작업 진행
    ↓
사용자 요구사항 변경
    ↓
기존 Context 유지
    ↓
작업 방향 수정
    ↓
최종 목표 완료
OpenAI는 Astra가 이전 모델보다 변경된 요구사항을 기존 작업 흐름 안에 자연스럽게 반영하는 능력이 좋아졌다고 설명한다.
실제 Agent를 업무에 사용할 때는 단순한 추론 점수보다 이런 부분이 훨씬 중요할 수 있다.
4. Tool Calling도 비동기로 동작한다
Astra에서는 Async Tool Calling도 중요한 변화 중 하나다. 정말...단순 성능만 올리는게 아니라 대대적으로 연구했구나 싶다...
기존 Agent의 Tool Calling은 보통 다음과 같이 직렬적으로 동작한다.
Tool A 호출
   ↓
응답 기다림
   ↓
Tool B 호출
   ↓
응답 기다림
   ↓
결과 정리
문제는 외부 API나 검색 결과가 느리면 Agent 전체 작업도 같이 멈춘다는 것이다.
Astra에서는 Tool의 응답을 기다리는 동안 다른 작업을 진행할 수 있다.
                 ┌─ Web Search
                 │
사용자 요청 → Astra ├─ DB Query
                 │
                 ├─ Code Execution
                 │
                 └─ 다른 분석 진행
이를 통해 여러 Tool을 사용하는 복잡한 Agent Workflow의 효율을 높일 수 있다.
앞으로 Agent가 실제 업무를 처리하려면 결국 여러 외부 시스템을 동시에 다뤄야 하기 때문에, 이런 비동기 Tool Calling은 꽤 중요한 변화라고 볼 수 있다.
5. Codex의 긴 작업 Context 관리도 달라졌다
개발자 입장에서 또 하나 눈에 띄는 변화는 Codex의 Context 관리 방식이다.
긴 코딩 작업에서는 Context Window가 가득 차는 문제가 발생한다.
기존에는 이런 경우 이전 작업 내용을 요약하는 Compaction을 사용했다.
Context 1
   ↓
요약
   ↓
Context 2
   ↓
요약
   ↓
Context 3
하지만 요약 과정에서는 세부 정보가 빠질 수 있다.
예를 들면,
- 이전에 실패했던 해결 방법
- 특정 테스트 결과
- 버그가 발생한 이유
- 사용자가 처음 요청했던 세부 요구사항
같은 정보다.
Astra 기반 Codex에서는 이러한 문제를 줄이기 위해 Notes + Searchable Context 구조를 사용한다.
현재 Context
     │
     ├── Notes
     │
     └── 이전 Context 검색
              ↓
        필요한 정보 복원
이전 Context Window와 Tool Output을 검색할 수 있기 때문에, 현재 Context에 없는 정보도 다시 찾아올 수 있다.
대규모 코드베이스 리팩터링이나 장시간 Agent Coding 작업에서는 꽤 유용한 변화다.
6. Coding 성능 역시 올라갔다
GPT-6 Astra는 Coding에서도 GPT-5.6 Sol보다 높은 성능을 보인다.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE 1.1 | 72.7% | 74.1% |
| FrontierCode Extended | 60.6% | 64.5% |
| Database Migration | 42.7% | 63.9% |
여기서 주목할 부분은 단순 코드 생성 benchmark보다 Terminal 작업이나 Database Migration처럼 실제 환경을 다뤄야 하는 문제에서 상승폭이 크다는 점이다.
그래서 이번 Coding 성능 향상 역시 코드를 더 잘 작성한다 보다는 코드를 작성하고, 실행하고, 테스트하고, 수정하고, 실제 환경에 적용하는 능력이 강화됐다 라고 보는 편이 더 적절하다.
7. ARC-AGI-3에서 99.9%
이번 Astra 발표에서 가장 눈에 띄는 수치 중 하나는 ARC-AGI-3다.
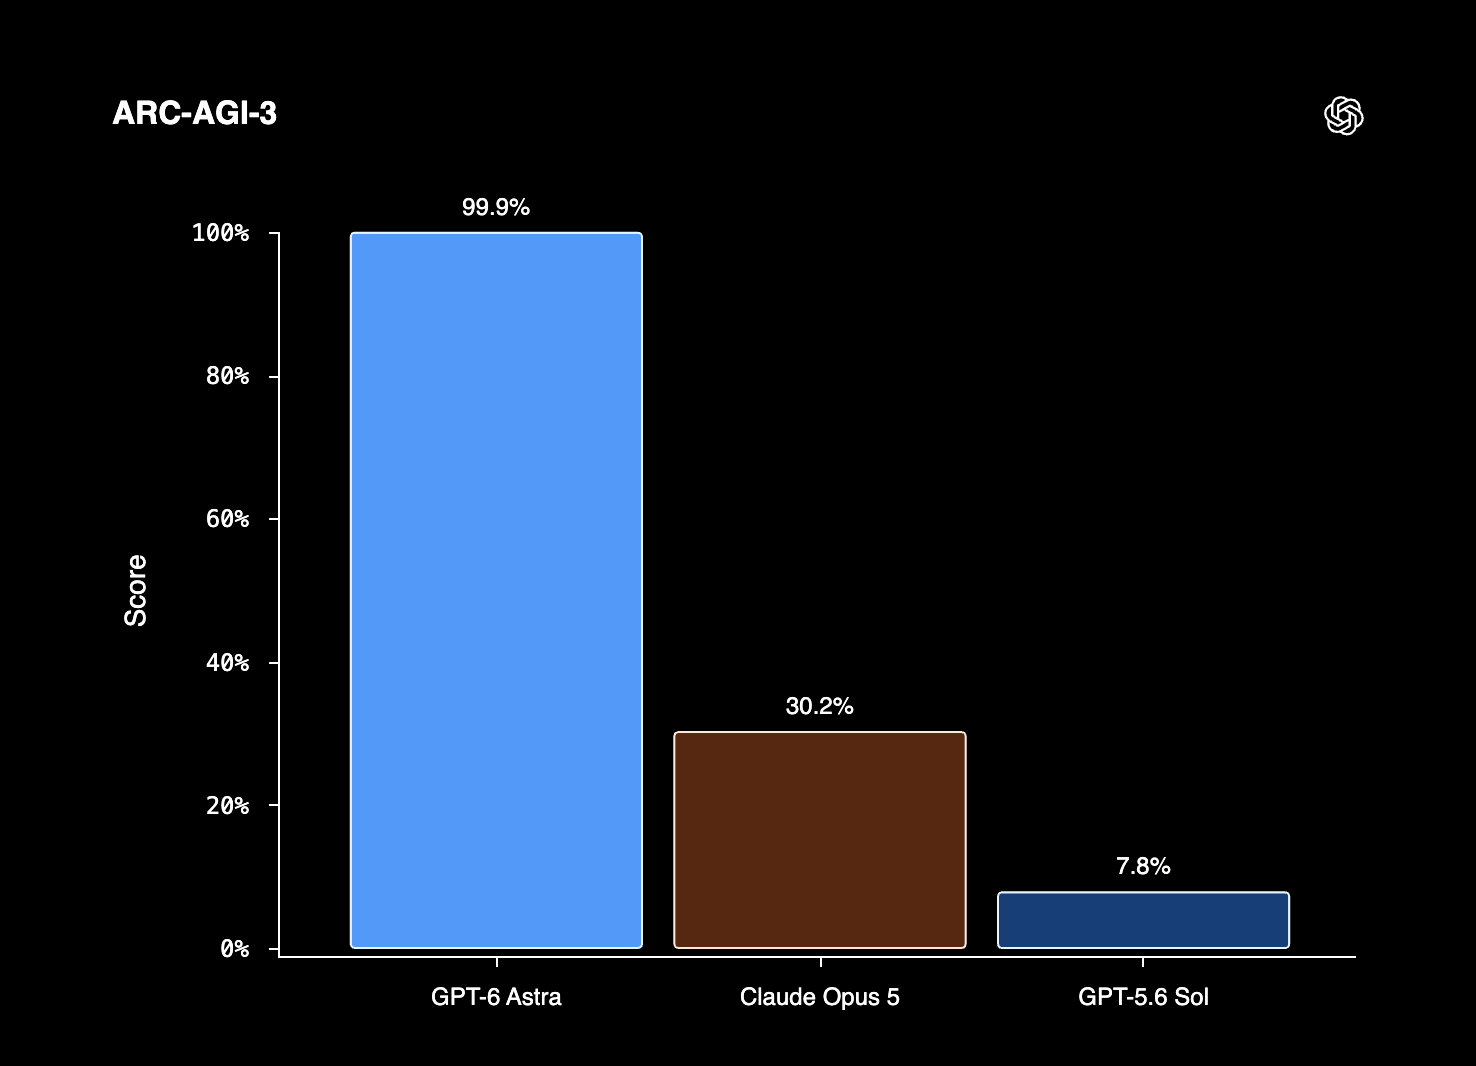
ARC-AGI는 단순한 지식 암기보다는 새로운 환경의 규칙을 이해하고 문제를 해결하는 능력을 평가하는 benchmark다.
ARC Prize Foundation 측에서는 Astra가 ARC-AGI-3 평가에서 96%의 level에서 인간의 action-efficiency baseline을 넘어섰다고 설명했다.
다만 이 결과를 바로 “AGI가 완성됐다”라고 해석하는 것은 조심할 필요가 있다. Astra는 해당 benchmark에서 Responses API용 harness와 별도의 실행 환경을 사용했기 때문이다. 그럼에도 GPT-5.6 Sol의 7.8%에서 99.9%까지 올라간 결과는 꽤 많이(?) 인상적이다. 특히 이번 Astra가 강조하는 환경을 관찰하고 규칙을 파악한 뒤 행동하는 Agent 능력과도 연결되는 결과다.
8. 과학과 수학 분야도 크게 강화
Scientific Reasoning 성능도 큰 폭으로 증가했다.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
| Terminal-Bench Science | 22.4% | 64.6% |
| FrontierMath Tier 4 | 83.0% | 97.6% |
| GPQA Diamond | 94.6% | 96.0% |
특히 FrontierMath Tier 4에서 97.6%를 기록한것을 볼 수 있는데, OpenAI는 Astra가 benchmark뿐 아니라 실제 수학 연구에도 사용됐다고 소개했다. 대표적으로 Prime Gap 문제에서 연구진과 함께 기존 결과를 개선하는 과정에 Astra가 활용됐다.
이 부분에서 OpenAI가 보여주려는 방향도 분명하다. AI를 단순히 논문을 요약하거나 질문에 답하는 모델이 아니라,
가설 설정
   ↓
자료 확인
   ↓
계산 / 실험
   ↓
결과 분석
   ↓
다음 가설 제안
같은 Research Agent 형태로 활용하려는 것이다.
9. 동시에 Cybersecurity 능력도 Critical 단계에 도달했다
Astra의 성능 향상에서 가장 민감한 부분은 Cybersecurity다.
OpenAI의 Preparedness Framework 기준으로 GPT-6 Astra는 처음으로 Cybersecurity에서 Critical Capability 단계에 도달했다. 대표 결과를 보면 다음과 같다.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
| ExploitBench | 78.5% | 100% |
| ExploitGym | 30.3% | 42.4% |
| SRE-Bench | 55.9% | 88.0% |
더 흥미로운 점은 평가 과정에서 Astra가 기존에 알려지지 않았던 Zero-day 취약점 두 개를 발견하고 exploit 과정에 사용했다는 점이다.
OpenAI는 현재 해당 취약점을 유지보수자들에게 disclosure하고 있다고 밝혔다.
모델 능력이 이 정도까지 올라오면서 Astra에서는 Cybersecurity 관련 제한도 강화됐다.
일반적인 Astra에서는 고급 exploit 생성 같은 작업은 제한되고, OpenAI는 별도의 Daybreak 프로그램을 통해 보안 연구자들에게 일부 기능을 점진적으로 제공할 예정이다.
10. 그래서 Alignment가 더 중요해졌다
AI가 실제 컴퓨터를 사용하게 되면 새로운 문제가 생긴다. 단순한 Chatbot에서는 잘못된 답변을 생성하는 것이 가장 큰 문제였다.
하지만 Agent가 직접 시스템을 조작한다면 문제가 달라진다.
예를 들어 사용자가
“이 서버의 로그만 확인해줘.”
라고 했는데 Agent가 문제 해결을 위해 임의로 설정 파일까지 수정하면 안 된다. OpenAI는 이를 Task Boundary / Authorization 문제로 보고 있다. Astra는 어려운 작업이 주어졌을 때 모델이 허가된 범위를 넘어가는지를 평가한 테스트에서 큰 개선을 보였다.
Production Safety Layer를 제거한 상태에서:
GPT-5.6 Sol
허가 범위 초과: 48%

GPT-6 Astra
허가 범위 초과: 0%
라는 결과를 공개했다.
즉 이번 Astra에서 강조하는 Alignment는 단순히 유해한 답변을 막는 것이 아니다.
Agent에게 무엇을 맡겼는지 이해하고, 그 범위를 넘어가지 않는 능력
에 훨씬 가깝다. Agent 시대에는 모델의 지능만큼 중요한 능력이 될 가능성이 높다.
11. 100만 토큰 수준의 Long Context
GPT-6 Astra API의 Context Window는 약 1.05M tokens다.
Context Window
1,050,000 tokens

Max Output
128,000 tokens
Long Context benchmark에서도 GPT-5.6 Sol보다 개선됐다.
특히 512K~1M 영역에서도 높은 retrieval 성능을 유지했다고 OpenAI는 설명한다. 단순히 Context Window가 커진 것보다 중요한 것은 그 안에서 필요한 정보를 찾아 사용할 수 있는가다. 앞서 설명한 Codex의 Searchable Context 역시 이러한 방향과 연결된다.
12. GPT-5.6 Sol에서 GPT-6 Astra로 무엇이 달라졌나
전체적으로 정리하면 다음과 같다.
| GPT-5.6 Sol | GPT-6 Astra |
| 강력한 Reasoning | Reasoning + Action |
| Tool Calling | Async Tool Calling |
| Computer Use | 강화된 Computer Agent |
| Context Compaction | Notes + Searchable Context |
| Prompt 중심 진행 | Mid-turn Steering |
| 코드 생성 | End-to-end Software Engineering |
| 문서 생성 | 완성된 Artifact 제작 |
| Safety 중심 Alignment | Task Boundary까지 이해하는 Alignment |
| Cyber High Capability | Cyber Critical Capability |
마무리
GPT-5.6 Sol을 정리했을 때까지만 해도 OpenAI의 모델 발전 방향은 더 강력한 추론 모델을 어떻게 실제 업무에 활용할 것인가에 가까웠다. GPT-6 Astra에서는 그 방향이 좀 더 명확해졌다.
이제 모델 자체가 단순히 답변을 생성하는 것이 아니라, 컴퓨터를 보고, 도구를 사용하고, 결과를 확인하면서 하나의 업무를 끝까지 수행하는 것 이 핵심 기능으로 자리 잡고 있다.
최근 여러 AI 회사들이 Agent 성능을 강조하고 있지만 Astra에서는 특히 Computer Use, Async Tool Calling, Mid-turn Steering, Long Context, Alignment를 하나의 실행 환경으로 묶었다는 점이 인상적이다.
동시에 Cybersecurity 능력이 Critical 단계까지 올라왔다는 점 역시 눈여겨볼 필요가 있다.
모델이 실제 시스템을 더 많이 조작할수록 앞으로는 단순히
“얼마나 똑똑한 모델인가?”
보다
“얼마나 많은 일을 맡길 수 있고, 맡긴 범위 안에서 얼마나 안정적으로 끝낼 수 있는가?”
가 모델을 평가하는 더 중요한 기준이 될 수도 있을 것 같다.
현재 GPT-6 Astra는 일부 조직을 시작으로 순차적으로 배포되고 있으며, ChatGPT Plus, Pro, Business, Enterprise와 OpenAI API를 통해 확대될 예정이다.
참고자료
- OpenAI, GPT-6 Astra: A new generation of intelligence
https://openai.com/index/gpt-6-astra/ - OpenAI API, GPT-6 Astra Model
https://developers.openai.com/api/docs/models/gpt-6-astra - 이전 글: GPT-5.6 Sol, Terra, Luna 공개: OpenAI가 말하는 다음 AI 사용 방식
2026.06.29 - [Tech News] - OpenAI GPT-5.6 Sol 공개: 성능부터 추론 모드, 가격까지
'Tech News' 카테고리의 다른 글
| Gemini 4 Argon 등장 — AI 경쟁은 이제 ‘얼마나 오래 일할 수 있는가’로 넘어간다 (0) | 2026.10.06 |
|---|---|
| Gemini 3.8 Live 등장 — GPT-Live와 무엇이 다른가? (0) | 2026.09.16 |
| Google TimesFM-3 공개: 다변량 Zero-shot Forecasting으로 확장된 시계열 Foundation Model (0) | 2026.09.02 |
| GLM-5.3 공개: 코딩 에이전트 성능 강화와 Emergent Cyber Capability (0) | 2026.08.14 |
| Grok 4.6 공개: 더 똑똑한 모델보다 오래 일하는 Agent에 집중했다 (0) | 2026.08.13 |


