Z.ai가 GLM-5.3을 공개했다.
https://z.ai/blog/glm-5.3
z.ai
이번 업데이트는 단순히 코딩 벤치마크 점수를 높인 모델이라기보다, 실제 개발 환경에서 장시간 작업을 수행하는 Coding Agent 성능을 크게 강화한 모델에 가깝다.
특히 흥미로운 부분은 코딩 성능 향상 과정에서 취약점 탐지, exploit reasoning, 공격 경로 분석 같은 사이버 보안 능력도 함께 크게 올라갔다는 점이다. Z.ai는 이를 발표 제목에서부터 “Emergent Cyber Capabilities”라고 표현했다.
1. GLM-5.3의 핵심은 Coding Agent 성능 강화
최근 코딩 모델의 경쟁은 단순히 코드를 얼마나 정확하게 생성하느냐에서 벗어나고 있다.
실제 개발 업무에서는 모델이 하나의 함수를 생성하는 것보다 다음과 같은 과정을 반복해서 수행할 수 있어야 한다.
Repository 탐색
    ↓
관련 코드 및 의존성 파악
    ↓
문제 원인 분석
    ↓
수정 계획 수립
    ↓
코드 변경
    ↓
Terminal / Tool 실행
    ↓
Test 결과 확인
    ↓
오류 분석
    ↓
재수정
이처럼 여러 단계가 연결된 작업을 보통 Long-horizon Software Engineering 또는 Agentic Coding 작업이라고 볼 수 있다.
GLM-5.3은 바로 이 부분에 초점을 맞췄다.
Z.ai는 자체적으로 구축한 Z.ai Code Bench에서 GLM-5.3이 GLM-5.2 대비 약 50% 향상된 성능을 기록했다고 밝혔다.
이 평가 역시 단순한 코드 생성 문제가 아니라, 실제 로컬 개발 환경에서 모델이 코드를 탐색하고 수정한 뒤 테스트까지 수행하는 과정을 포함한다.
2. 공개 벤치마크에서도 Long-horizon 성능 향상
GLM-5.3은 여러 Agent 및 Software Engineering 벤치마크에서도 GLM-5.2보다 큰 폭으로 성능이 향상됐다.
대표적인 결과는 다음과 같다.
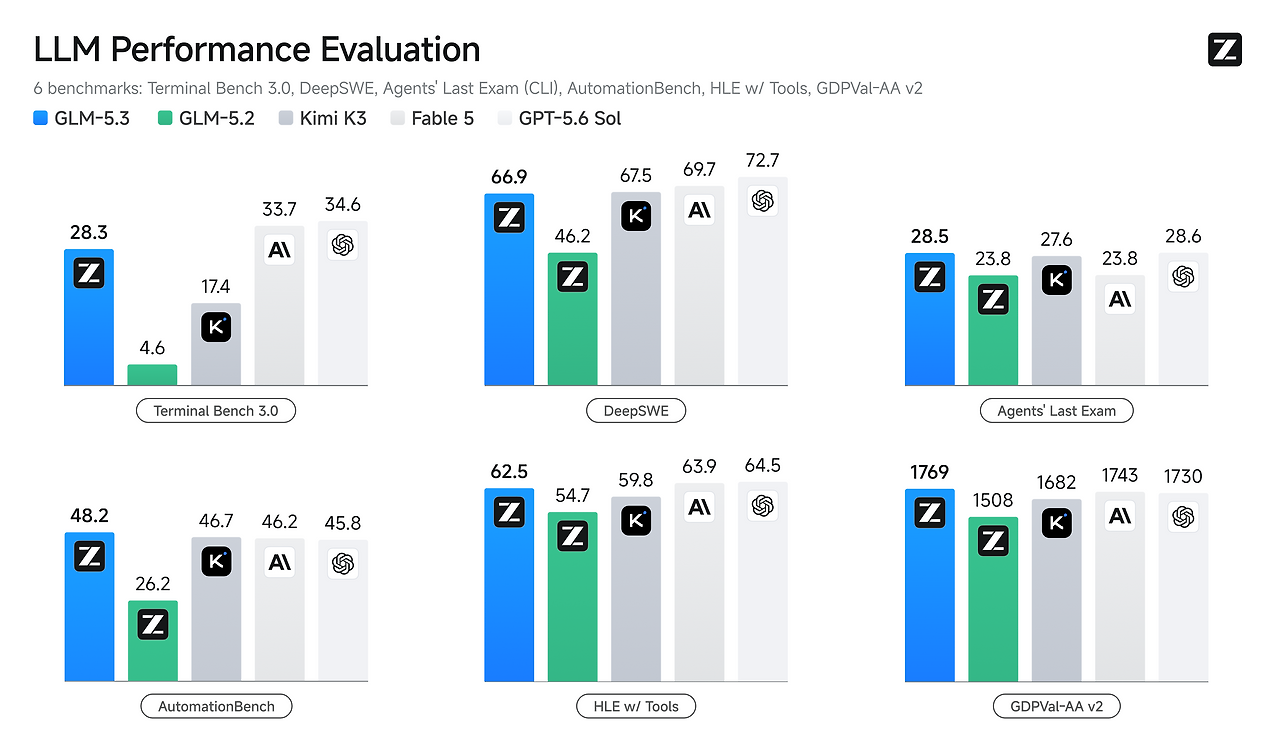
특히 DeepSWE v1.1 결과가 눈에 띈다. DeepSWE는 단순히 짧은 알고리즘 문제를 해결하는 평가가 아니라, 실제 소프트웨어 엔지니어링에 가까운 복잡한 작업을 수행하는 능력을 평가한다.
따라서 GLM-5.3에서 개선된 부분은 단순한 syntax 생성 능력보다는,
- 기존 코드 구조 이해
- 여러 파일 사이의 dependency 파악
- 변경에 따른 side effect 추론
- Terminal command 사용
- 테스트 실패 후 수정
- 긴 작업 흐름 유지
같은 능력이라고 볼 수 있다. 최근 Claude Code, Codex 같은 Coding Agent가 강조되는 이유도 결국 이 부분과 연결된다.
모델이 코드를 잘 생성하는 것보다 실제 Repository 안에서 개발 업무를 끝낼 수 있는가가 더 중요해지고 있기 때문이다.
3. 이번 발표에서 가장 흥미로운 부분: Cyber Capability
GLM-5.3 발표에서 가장 눈에 띄는 부분은 사실 Coding Benchmark보다 Cybersecurity 성능이다.
Z.ai는 GLM-5.3의 post-training 과정에 다음과 같은 데이터를 포함했다고 설명한다.
- Vulnerability discovery
- 실제 보안 환경
- 공격 가능한 코드 분석
- Software exploitation 관련 task
원래 목적은 모델이 코드 안에서 보안 취약점을 더 잘 발견하도록 만드는 것이었다.
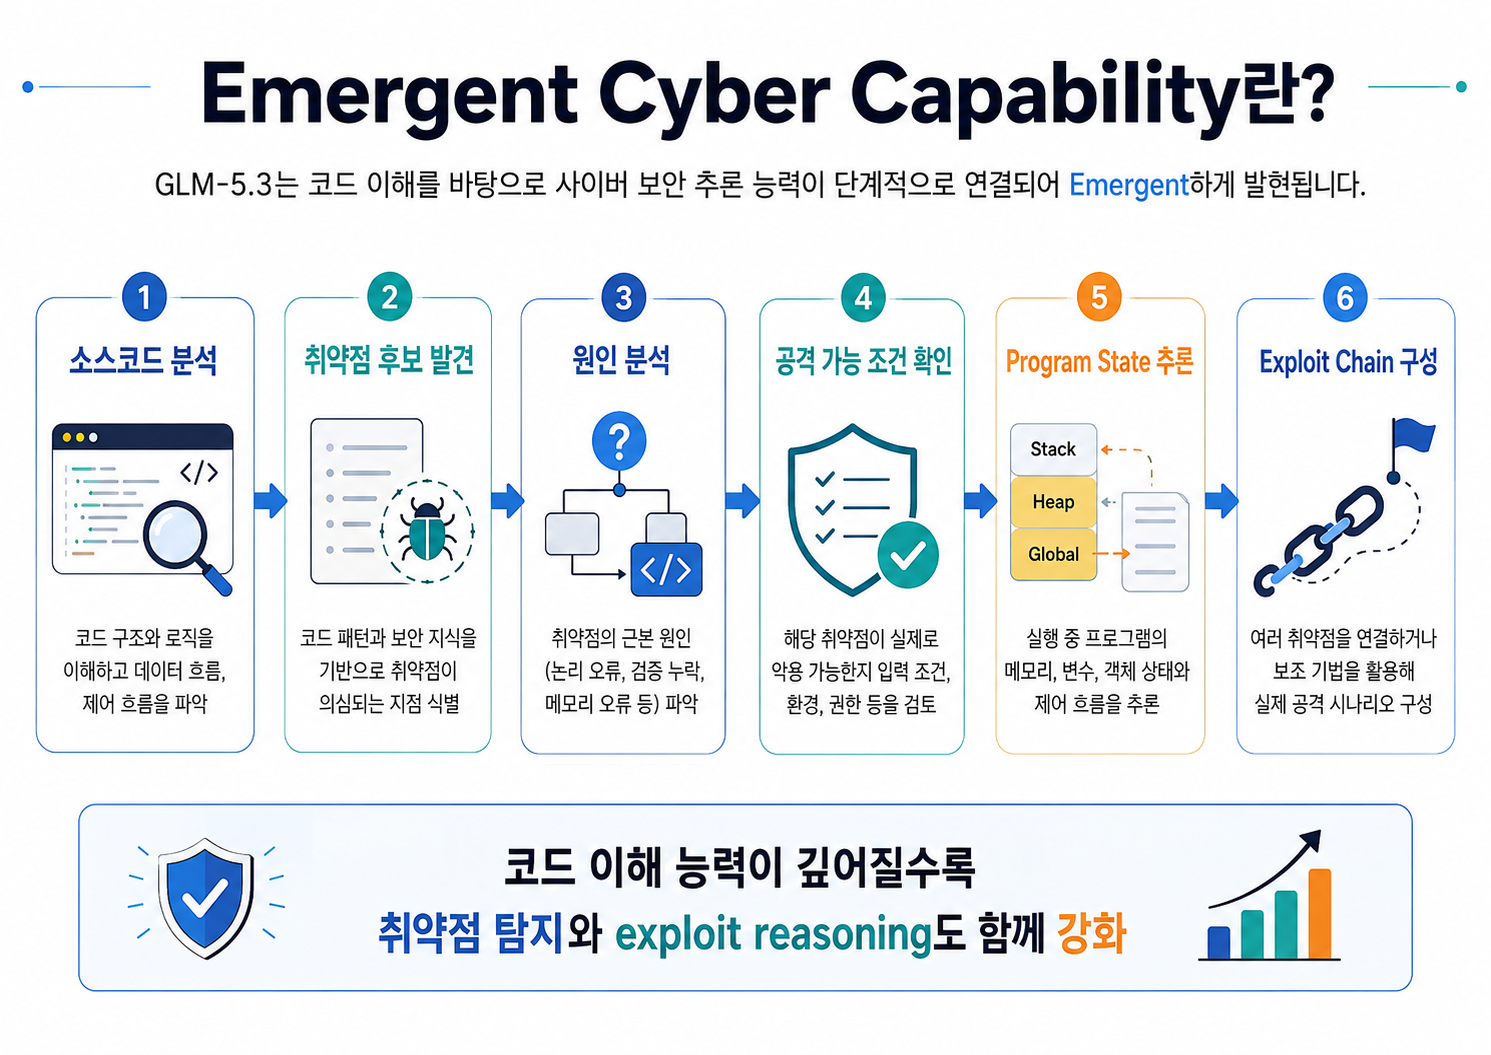
그런데 학습을 확장하면서 모델이 단순한 취약점 탐지를 넘어 취약점을 실제 exploit 가능한 경로로 연결하는 능력까지 보여주기 시작했다고 한다.
이를 구조적으로 보면 다음과 같다.
Source Code 분석
      ↓
취약점 후보 발견
      ↓
Root Cause 분석
      ↓
공격 가능 조건 확인
      ↓
Program State 추론
      ↓
여러 취약점 또는 조건 연결
      ↓
Exploit Chain 구성
단순히 "이 코드에는 메모리 관련 문제가 있다." 라고 찾는 수준이 아니라,
"이 취약점이 특정 상태에서 발생하며, 다른 조건과 결합하면 실제 공격 경로로 이어질 수 있다." 까지 추론하는 것이다.
Z.ai가 이를 Emergent Cyber Capability라고 표현한 이유다.
4. Cyber Benchmark 성능도 크게 상승
이 부분은 실제 벤치마크에서도 확인된다.
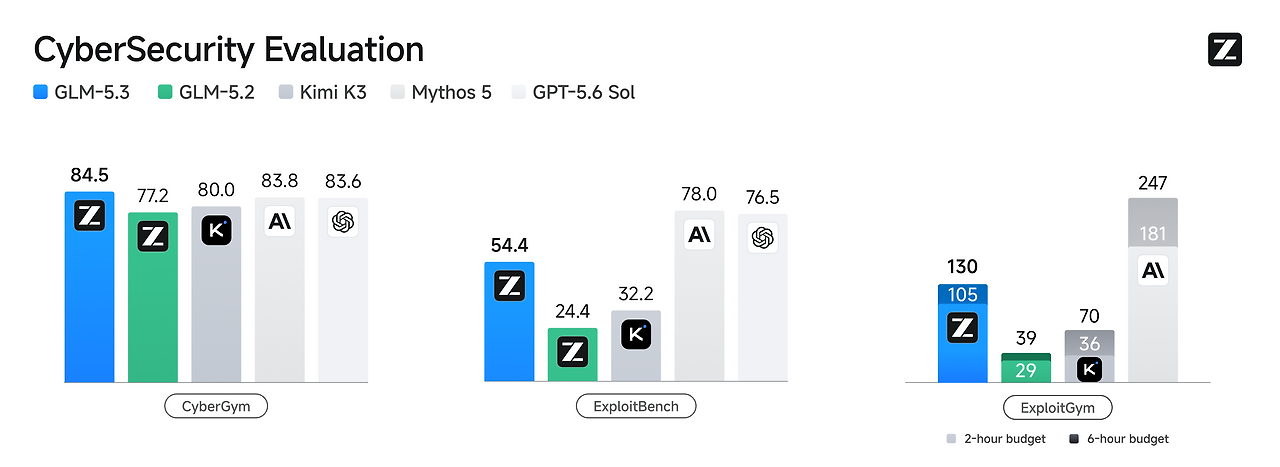
CyberGym
CyberGym은 소스코드가 주어진 상황에서 취약점을 발견하고 이를 실제 failure로 재현할 수 있는지 평가한다.
GLM-5.2는 77.2%, GLM-5.3은 84.5%를 기록했다.
취약점의 존재 여부를 단순 분류하는 것보다 실제 실행 환경에서 문제를 재현해야 하기 때문에, 코드 이해와 tool-use 능력이 동시에 필요하다.
ExploitBench
더 흥미로운 결과는 ExploitBench다.
- GLM-5.2: 24.4%
- GLM-5.3: 54.4%
정확도가 두배 이상 증가했는데, ExploitBench는 취약점을 찾는 것에서 끝나지 않고, 해당 취약점을 어떻게 실제 exploit할 수 있는지를 추론해야 한다. 따라서 이 결과는 GLM-5.3의 개선이 단순한 정적 코드 분석 능력에 그치지 않는다는 것을 보여준다.
ExploitGym
장시간 동안 여러 exploit task를 수행하는 ExploitGym에서도 차이가 크게 나타났다.
GLM-5.2는
- 2시간: 29개
- 6시간: 39개
를 해결한 반면 GLM-5.3은
- 2시간: 105개
- 6시간: 130개
를 완료했다고 Z.ai는 밝혔다. 여기서도 중요한 것은 단순한 reasoning 정확도보다 긴 시간 동안 반복적으로 도구를 사용하고 문제를 해결하는 Agent 성능이다.
5. 실제 오픈소스 프로젝트에서도 취약점을 발견
Z.ai는 벤치마크뿐 아니라 실제 오픈소스 코드베이스를 대상으로도 모델을 테스트했다.
발표에 따르면 전문가 검토와 중복 제거를 거쳐 269개 프로젝트에서 총 2,436개의 취약점 을 발견했다고 밝혔다. 이 중 1,097개가 Medium 또는 High Severity로 분류됐다.
분석 대상에는 다음과 같은 프로젝트가 포함됐다.
- Operating System / Kernel
- Browser Engine
- Infrastructure Software
- Web Application
- Network Protocol
즉 작은 테스트용 코드가 아니라 실제로 사용되는 비교적 복잡한 코드베이스에서도 취약점 탐지 성능을 검증한 것이다. Z.ai는 이렇게 발견한 취약점을 관리하기 위해 별도의 Security Disclosure Ledger도 운영한다고 설명했다.
6. 왜 Coding Agent가 좋아지면 Cyber 능력도 같이 좋아질까?
이 부분이 GLM-5.3에서 가장 재미있는 지점이다.
사실 고성능 Coding Agent와 보안 분석 Agent가 필요로 하는 기본 능력은 상당히 비슷하다. 일반적인 Coding Agent가 버그를 고치는 과정을 보면,
Repository 이해
→ 관련 함수 추적
→ 실행 흐름 분석
→ 오류 발생 조건 탐색
→ 문제 재현
→ 코드 수정
→ 테스트
과정을 거친다.
Cybersecurity Agent도 거의 같은 작업을 수행한다.
Repository 이해
→ 실행 흐름 분석
→ 비정상적인 상태 탐색
→ 취약 조건 발견
→ 재현
→ 공격 가능성 검증
차이는 마지막 목표가 Bug Fix인지 Exploit인지에 가깝다.
즉 Coding Agent가 발전하면서 다음 능력이 좋아지면,
- control flow 추론
- program state 이해
- edge case 탐색
- dependency 분석
- 실패 조건 재현
- tool 사용
- iterative reasoning
자연스럽게 보안 취약점을 찾는 능력도 같이 좋아질 가능성이 높다.
GLM-5.3은 여기에 vulnerability 관련 training environment까지 추가하면서 이러한 능력이 더 직접적으로 강화된 사례라고 볼 수 있다.
7. 새로운 Base Model보다는 Post-training 강화
GLM-5.3은 완전히 새로운 Foundation Model을 처음부터 다시 학습한 모델이라기보다는, 기존 GLM-5 계열 모델의 post-training을 강화한 업데이트에 가깝다. 개념적으로 보면 다음과 같다.
GLM-5 Base Model
      │
      ├─ Coding Agent Trajectory
      ├─ Long-horizon Task
      ├─ Terminal / Tool Use
      ├─ Software Engineering
      └─ Vulnerability / Cyber Environment
                 ↓
            Post-training
                 ↓
              GLM-5.3
여기서 중요한 것은 단순히 instruction-response 데이터를 많이 넣는 것이 아니다.
Agent 모델에서는 하나의 문제를 해결하기 위해 모델이
Think
 → Tool
 → Observe
 → Think
 → Tool
 → Observe
 → Final Result
과정을 반복한다.
따라서 어떤 Agent trajectory를 학습시키는가가 모델 성능에 큰 영향을 준다.
최근 Frontier 모델들이 단순한 언어모델 성능보다 Agent 성능 향상을 강조하는 이유도 여기에 있다.
8. GLM-5.2에서 GLM-5.3으로 무엇이 달라졌나
최근 GLM 계열의 발전 방향을 보면 비교적 명확하다.
- GLM-5.1: 장시간 작업과 Agent 성능을 본격적으로 강화.
- GLM-5.2: 1M context를 지원하면서 대규모 Repository나 장시간 Agent 작업에서 사용할 수 있는 context capacity를 확대.
- GLM-5.3: 긴 context를 제공하는 것에서 한 단계 더 나아가, Coding Agent의 실제 작업 성공률을 높이고, 코드 이해 능력을 Cybersecurity 영역까지 확장했다.
즉 GLM-5.2가
"더 많은 정보를 가지고 오래 작업할 수 있는 모델"
에 가까웠다면,
GLM-5.3은
"그 긴 작업 과정에서 실제 문제를 더 잘 해결하는 모델"
쪽으로 이동한 것으로 볼 수 있다.
마무리
GLM-5.3을 단순히 새로운 코딩 모델이라고만 보기에는 이번 발표에서 보여주는 변화가 꽤 흥미롭다.
최근 Coding Agent는 이제 단순 코드 자동완성 수준을 넘어,
- Repository 탐색
- Terminal 사용
- 테스트 실행
- 실패 분석
- 계획 수정
- 장시간 반복 작업
까지 수행하는 방향으로 발전하고 있다.
그리고 이러한 능력이 강화되면서 Software Engineering과 Cybersecurity 사이의 경계도 점점 가까워지고 있다.
좋은 Coding Agent가 되기 위해 필요한 프로그램 구조 이해, 실행 흐름 추적, edge case 탐색 능력이 그대로 취약점 분석에도 활용될 수 있기 때문이다.
GLM-5.3은 최근 AI 모델 경쟁이 단순한 benchmark score 경쟁에서 벗어나,
실제 컴퓨터 환경에서 얼마나 복잡한 작업을 스스로 수행하고 끝낼 수 있는가
를 경쟁하는 방향으로 이동하고 있다는 것을 보여주는 모델 중 하나다.
참고자료
- Z.ai, GLM-5.3: Frontier Coding with Emergent Cyber Capabilities
https://z.ai/blog/glm-5.3 - Z.ai, GLM-5.2
https://z.ai/blog/glm-5.2 - Z.ai Documentation
https://docs.z.ai/
'Tech News' 카테고리의 다른 글
| GPT-6 Astra 공개: 이제는 ‘답변하는 AI’보다 ‘직접 일하는 AI’에 가깝다 (0) | 2026.09.04 |
|---|---|
| Google TimesFM-3 공개: 다변량 Zero-shot Forecasting으로 확장된 시계열 Foundation Model (0) | 2026.09.02 |
| Grok 4.6 공개: 더 똑똑한 모델보다 오래 일하는 Agent에 집중했다 (0) | 2026.08.13 |
| Inkling-Small 공개: 4분의 1 크기로 대형 Inkling을 넘어선 모델 (0) | 2026.07.31 |
| Open Weight를 금지하지는 않지만 낙관하지도 않는다, Anthropic의 별도 입장 (0) | 2026.07.28 |


