xAI가 2026년 8월 12일 Grok 4.6을 공개했다.
Introducing Grok 4.6
Grok 4.6 builds on Grok 4.5 with a particular focus on long-running agents and more ambitious interactive and visual work.
x.ai
이번 업데이트에서 눈에 띄는 부분은 단순한 지식이나 추론 능력 향상보다 Long-running Agent, 즉 여러 단계를 거쳐 오랫동안 하나의 작업을 수행하는 에이전트 능력을 강화했다는 점이다.
xAI는 Grok 4.6이 리서치, 정보 분석, 코드베이스 작업, 애플리케이션 제작처럼 한 번의 답변으로 끝나지 않는 복잡한 작업을 더 안정적으로 수행하도록 개발했다고 설명했다.
Grok 4.6의 핵심은 Long-running Agent
일반적인 LLM은 질문을 받고 답변을 생성하는 형태에 가깝다.
질문 -> 추론 -> 답변반면 Agent가 수행하는 작업은 조금 다르다.
목표 확인
 ↓
계획 수립
 ↓
자료 또는 코드 탐색
 ↓
Tool 실행
 ↓
결과 확인
 ↓
문제 발견
 ↓
수정
 ↓
재실행
 ↓
최종 결과
중요한 것은 각각의 단계에서 좋은 답을 만드는 것뿐만 아니라, 앞에서 수행한 작업을 기억하면서 다음 행동을 결정하고 실패했을 때 다시 수정하는 능력이다.
Grok 4.6은 바로 이 부분에 초점을 맞췄다.
xAI에 따르면 Grok 4.6은 긴 작업 과정에서 모델이 자신의 결과를 직접 테스트하고 검증하는 Self-testing과 Verification 행동도 Grok 4.5보다 더 많이 나타났다.
예를 들어 개발 작업을 수행한다면 단순히 코드를 생성하고 끝나는 것이 아니라,
코드 작성
→ 실행
→ Test 실패 확인
→ 원인 분석
→ 코드 수정
→ 다시 Test
→ 정상 동작 확인
까지 이어지는 형태다.
최근 Claude Code나 Codex, Cursor 같은 Coding Agent에서 중요해지고 있는 능력과 비슷한 방향이라고 볼 수 있다.
실제 Agent 성능은 얼마나 올랐나
Agent 관련 벤치마크에서도 Grok 4.5 대비 상승 폭이 꽤 크다.
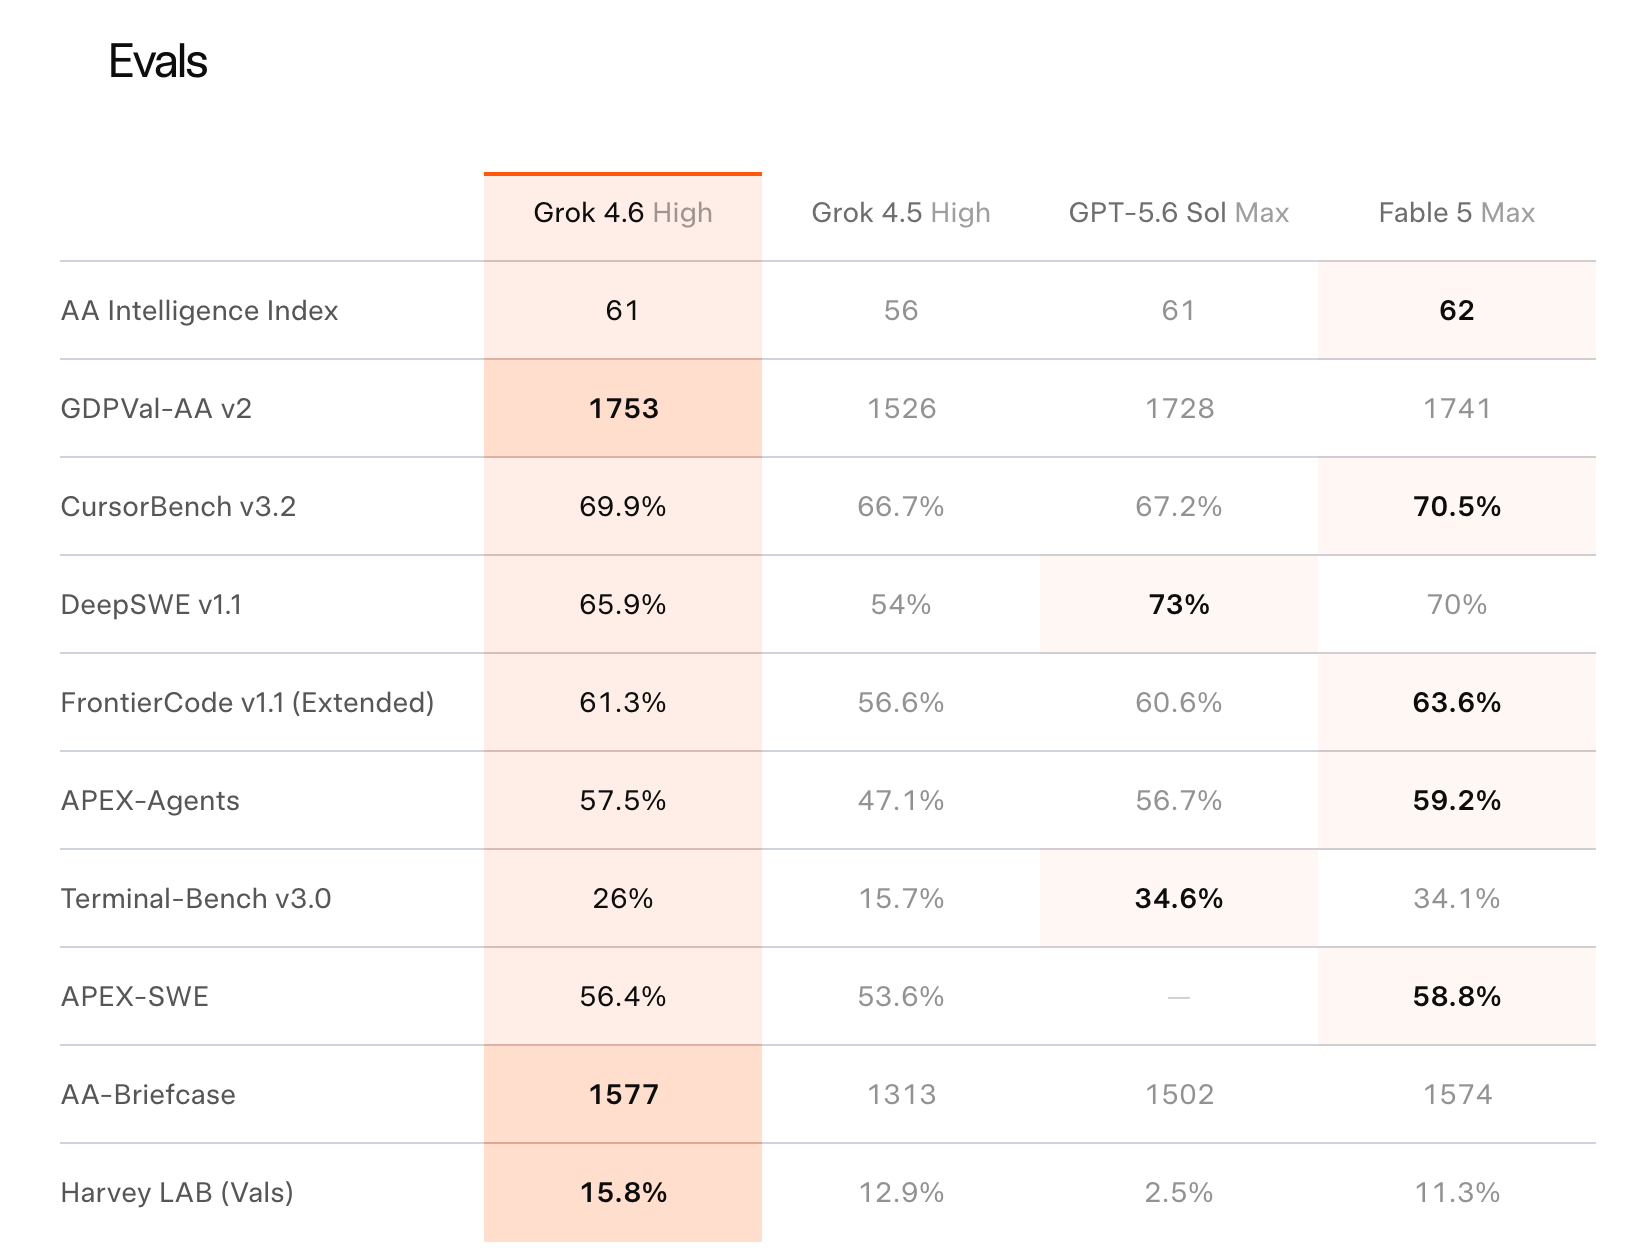
대표적으로 APEX-Agents는 다음과 같이 상승했다.
- APEX-Agents: 47.1% → 57.5%
터미널 환경에서 여러 명령과 도구를 사용해 문제를 해결하는 Terminal-Bench 3.0 역시 15.7%에서 26.0%로 크게 개선됐다.
Coding Agent 관련 평가에서도 개선이 나타났다.
- CursorBench 3.2: 66.7% → 69.9%
- DeepSWE 1.1: 54.0% → 65.9%
- FrontierCode 1.1: 56.6% → 61.3%
모든 벤치마크에서 경쟁 모델보다 높은 것은 아니지만, Grok 4.5와 비교하면 실제 환경에서 코드를 탐색하고 수정하고 실행하는 Agent 능력이 전반적으로 향상된 것을 확인할 수 있다.
Agent 성능을 어떻게 높였을까?
이번 발표에서 개인적으로 가장 흥미로운 부분은 성능 자체보다 어떻게 Agent 능력을 학습시켰는가이다.
xAI가 공개한 Grok 4.6 학습 과정을 단순화하면 다음과 같다.
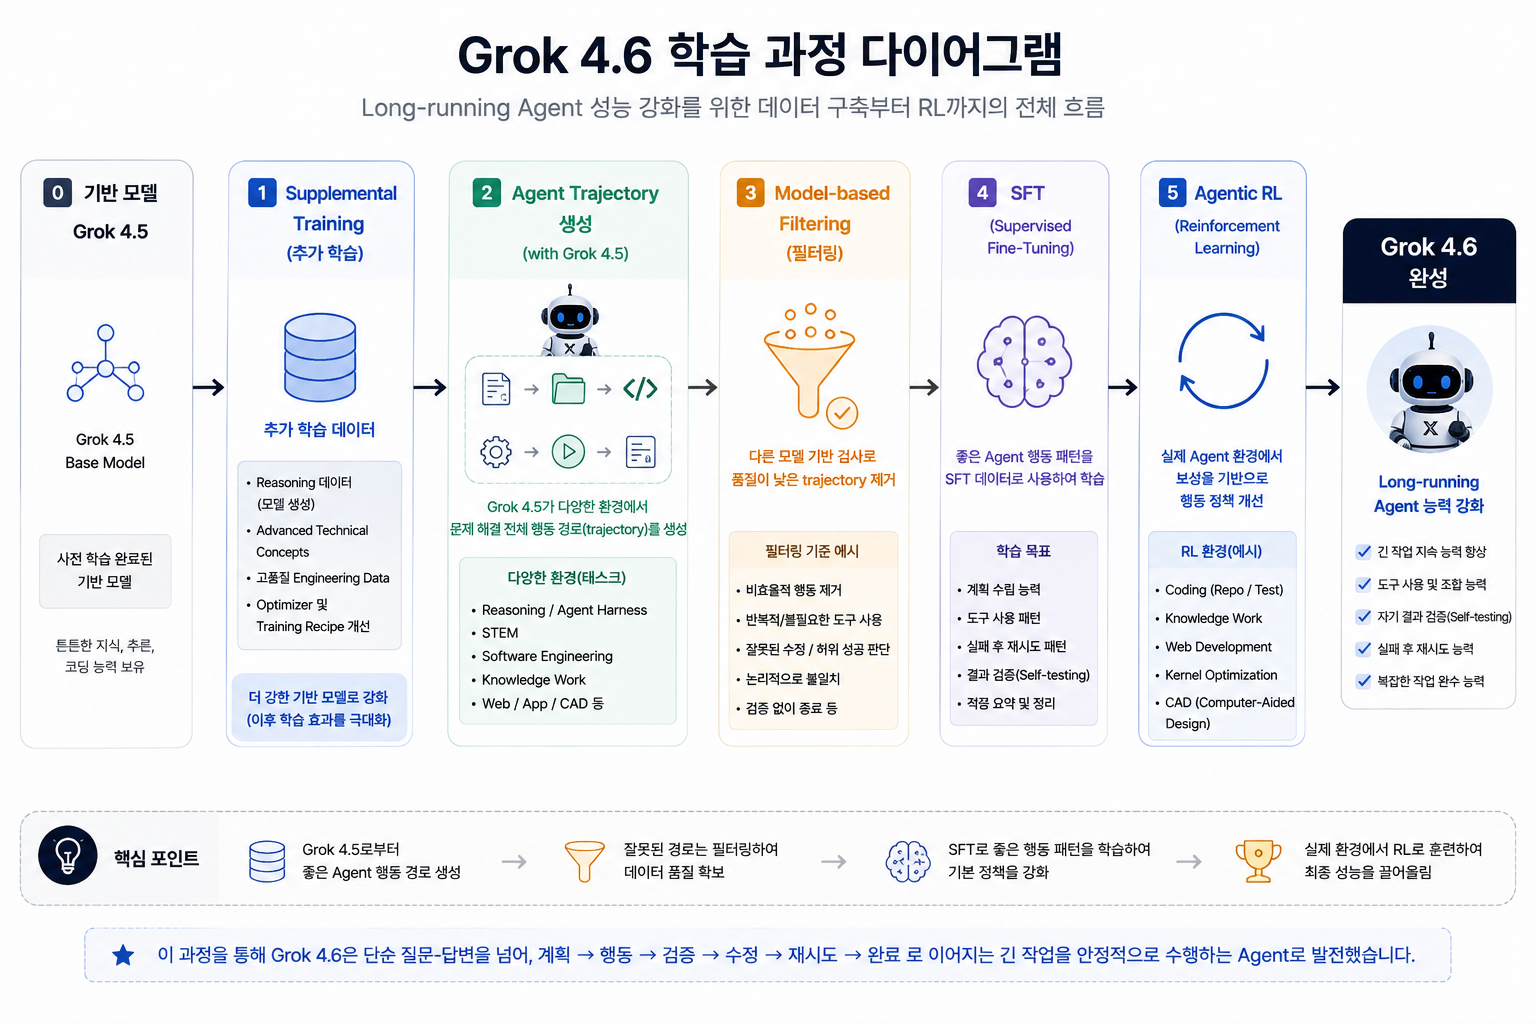
1. 먼저 기반 모델을 추가 학습
Grok 4.6은 Grok 4.5보다 더 긴 Supplemental Training을 진행했다.
여기에는 reasoning과 advanced technical concepts를 위한 모델 생성 데이터와 고품질 engineering data가 사용됐으며, optimizer와 training recipe도 개선됐다.
즉 바로 Agent RL을 시작한 것이 아니라, 먼저 이후 SFT와 RL을 수행할 수 있도록 기반 모델 자체를 강화했다.
2. Grok 4.5로 Agent의 작업 과정 자체를 생성
xAI는 Grok 4.5를 사용해 새로운 SFT trajectory를 생성했다. 여기서 trajectory는 단순히 질문과 정답 한 쌍이 아니라, Agent가 문제를 해결하면서 거치는 전체 행동 과정을 의미한다.
예를 들어 이런 형태다.
문제 확인
→ Repository 탐색
→ 관련 파일 발견
→ 코드 수정
→ Test 실행
→ 실패
→ 원인 분석
→ 다시 수정
→ Test 성공
이러한 trajectory를 reasoning, Agent harness, STEM, Software Engineering, Knowledge Work 등 다양한 환경에서 생성했다.
그리고 생성된 경로를 그대로 사용하는 것이 아니라 model-based checks를 이용해 문제가 있는 trajectory를 제거했다.
예를 들어
- 불필요하게 같은 Tool 반복 호출
- 잘못된 파일 수정
- 오류를 확인하지 않고 작업 종료
- Test가 실패했는데 성공했다고 판단
같은 행동을 포함한 데이터는 학습에서 제외할 수 있다.
결국 모델에게 단순히 "이 문제의 정답은 이것이다" 를 알려주는 것이 아니라,
"이런 순서로 행동하면 문제를 잘 해결할 수 있다"
라는 좋은 Agent 행동 패턴 자체를 학습시키는 것이다.
3. 실제 Agent 환경에서 강화학습
SFT 이후에는 Agentic Reinforcement Learning도 수행했다.
xAI가 공개한 RL 환경에는 다음과 같은 작업이 포함된다.
- Knowledge Work
- General Coding
- Kernel Optimization
- Web Development
- Computer-Aided Design(CAD)
일반적인 문제 풀이가
질문
→ 답변
→ 평가
라면 Agent RL은 조금 다르다.
목표
 ↓
행동
 ↓
Tool 실행
 ↓
환경의 결과 확인
 ↓
다음 행동 결정
 ↓
다시 Tool 실행
 ↓
최종 목표 달성
예를 들어 Coding Agent라면
코드 수정
 ↓
Test 실행
 ↓
실패
 ↓
다른 파일 확인
 ↓
재수정
 ↓
Test 성공
같은 과정 자체가 강화학습 대상이 된다.
특히 코딩이나 Kernel Optimization처럼 결과를 비교적 명확하게 검증할 수 있는 환경에서는 Test 통과 여부, 실행 성공 여부, 성능 개선 여부 등이 학습 신호로 활용될 수 있다.
다만 xAI는 Grok 4.6 발표에서 구체적인 RL 알고리즘이나 Reward Model의 구성, Human Feedback 사용 비율 등까지 공개하지는 않았다. 따라서 Grok 4.6이 완전히 자동화된 RL만 사용했다고 단정할 수는 없지만, 공개된 내용을 보면 사람이 모든 정답 경로를 직접 작성하는 방식보다는 모델이 Agent 환경에서 작업하고 결과를 검증하면서 행동 정책을 개선하는 방향에 가깝다.
단순 Coding Model에서 작업을 끝내는 Agent로
이번 Grok 4.6 발표를 보면 최근 Frontier Model 경쟁의 방향도 조금씩 달라지고 있다는 것을 확인할 수 있다.
과거에는
더 많은 지식
더 높은 수학 성능
더 높은 Coding Benchmark
가 모델 성능 비교의 중심이었다면, 최근에는
얼마나 오래 작업할 수 있는가
 ↓
Tool을 적절하게 사용할 수 있는가
 ↓
실패한 작업을 다시 수정할 수 있는가
 ↓
자신의 결과를 검증할 수 있는가
 ↓
결국 작업을 끝낼 수 있는가
가 점점 더 중요해지고 있다.
Grok 4.6 역시 이런 흐름을 잘 보여주는 모델이다.
xAI는 실제로 Grok 4.6을 넓은 제품 아이디어에서 시작해 생소한 분야를 조사하고, 애플리케이션 구조를 만들고, 핵심 기능을 구현한 뒤 여러 차례 피드백을 거쳐 결과를 개선하는 작업에 테스트했다고 설명한다.
즉 Grok 4.6의 핵심은 단순히 "Grok 4.5보다 더 똑똑하다"라기보다,
하나의 복잡한 목표를 받고, 여러 단계를 수행하며, 자신의 작업을 확인하고 수정하면서 끝까지 결과물을 만들어내는 능력을 강화했다
고 정리할 수 있다.
마무리
Grok 4.6은 Grok 4.5의 후속 모델이지만 이번 업데이트의 방향은 비교적 명확하다.
Long-running Agent 성능 강화다. 이를 위해 xAI는 기반 모델을 추가 학습한 뒤, Grok 4.5를 이용해 Agent가 문제를 해결하는 전체 trajectory를 다시 생성하고 이를 model-based check로 필터링해 SFT에 사용했다. 이후 Coding, Knowledge Work, Web Development, Kernel Optimization, CAD 등 다양한 실제 Agent 환경에서 강화학습을 수행했다.
그리고 그 결과 APEX-Agents나 Terminal-Bench 같은 Agent 관련 평가에서 Grok 4.5보다 큰 폭의 성능 향상을 보여줬다.
최근 AI 모델의 발전 방향이 단순한 질문-답변 모델에서 실제 작업을 수행하는 Agent로 이동하고 있다는 점을 생각하면, Grok 4.6 역시 그 흐름을 꽤 명확하게 보여주는 업데이트라고 볼 수 있다.
참고자료
- xAI, Introducing Grok 4.6
https://x.ai/news/grok-4-6 - xAI, Grok API Documentation
https://docs.x.ai/ - xAI, Grok Build
https://x.ai/build
'Tech News' 카테고리의 다른 글
| Google TimesFM-3 공개: 다변량 Zero-shot Forecasting으로 확장된 시계열 Foundation Model (0) | 2026.09.02 |
|---|---|
| GLM-5.3 공개: 코딩 에이전트 성능 강화와 Emergent Cyber Capability (0) | 2026.08.14 |
| Inkling-Small 공개: 4분의 1 크기로 대형 Inkling을 넘어선 모델 (0) | 2026.07.31 |
| Open Weight를 금지하지는 않지만 낙관하지도 않는다, Anthropic의 별도 입장 (0) | 2026.07.28 |
| Open Weight 논쟁, Microsoft·NVIDIA 등 공동 성명 발표 (0) | 2026.07.27 |


