Google이 차세대 frontier model인 Gemini 4 Argon을 공개했다.

최근 Gemini 3.8 Live가 실시간 음성·영상 interaction에 집중한 모델이었다면, 이번 Argon은 방향이 꽤 다르다.
Argon이 겨냥하는 것은 단순한 질문·답변이나 짧은 추론이 아니다.
복잡한 문제를 장시간 추론하고, 여러 도구를 사용하면서 실제 작업을 끝까지 수행하는 Agent
에 가깝다.
특히 Google은 이번 발표에서 소프트웨어 엔지니어링, 기업 업무 자동화, 금융·법률, 사이버보안과 같은 long-horizon workflow를 반복해서 강조했다.
이번 글에서는 Gemini 4 Argon이 어떤 모델인지 살펴보고, 현재 주요 경쟁 모델인 OpenAI GPT-6 Astra, Anthropic Claude Opus 5.5 / Fable 5.1과 비교해 어느 영역에서 강점을 보이는지도 살펴보려 한다.
1. Gemini 4 Argon은 무엇이 다른가?
기존 LLM의 사용 방식은 비교적 단순했다.
사용자 질문
   ↓
모델 추론
   ↓
답변 생성
Reasoning Model이 등장하면서 이 구조는 조금 길어졌다.
문제
 ↓
여러 단계 추론
 ↓
검증
 ↓
답변
하지만 Agent가 실제 업무를 수행하려면 이것만으로는 부족하다.
실제 개발 업무를 예로 들면 다음처럼 동작해야 한다.
요구사항 분석
 ↓
Repository 탐색
 ↓
관련 코드 검색
 ↓
수정 계획 수립
 ↓
코드 수정
 ↓
Build / Test
 ↓
오류 확인
 ↓
원인 분석
 ↓
코드 재수정
 ↓
Benchmark
 ↓
Regression Test
 ↓
최종 결과
중요한 것은 모델이 한 번 좋은 답을 만들어내는 것이 아니라,
이 긴 과정을 중간에 포기하지 않고 계속 수행할 수 있는가
이다.
Gemini 4 Argon은 바로 이 영역을 강화한 모델이다.
Google 역시 Argon을 복잡하고 긴 workflow에서 reasoning을 지속할 수 있도록 설계된 모델로 설명하고 있다.
2. 이제 중요한 것은 Context보다 ‘Trajectory’다
Gemini는 이전 세대부터 긴 Context Window를 강점으로 가지고 있었다.
따라서 단순히 입력 Context가 크다는 것만으로 Argon을 설명하기는 어렵다.
Argon에서 더 중요한 것은 긴 Agent Trajectory를 유지하는 능력이다.
예를 들어 Coding Agent라면,
Plan -> Search -> Code -> Run -> Observe -> Debug -> Re-plan -> Run -> Optimize -> Validate이 과정을 여러 번 반복한다.
Agent가 실제로 일을 수행할수록 Tool Call, 실행 결과, 오류 로그, 이전 판단 등 계속해서 새로운 정보가 쌓인다.
결국 앞으로의 Agent 모델에서는 단순히
Context Window가 얼마나 큰가?
보다
그 Context 안에서 얼마나 오랫동안 일관되게 Reasoning과 Action을 유지할 수 있는가?
가 더 중요한 기준이 될 가능성이 높다.
3. 가장 눈에 띄는 영역은 Agentic Coding
Gemini 4 Argon 발표에서 가장 먼저 눈에 띄는 부분은 Coding 성능이다.
특히 일반적인 알고리즘 문제보다 실제 Repository를 수정하고 테스트하는 Agentic Software Engineering 성능이 강조됐다.
Google이 공개한 주요 결과는 다음과 같다.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
결과를 보면 꽤 흥미롭다.
Argon은 DeepSWE와 Vibe Code Bench에서는 가장 높은 점수를 기록했다.
반면 FrontierSWE에서는 GPT-6 Astra가 더 높고, Terminal-bench와 ML Engineering 성격의 PostTrainBench에서는 Claude Opus 5.5가 우세하다.
즉,
Gemini 4 Argon이 모든 Coding Benchmark에서 압도적인 모델은 아니다.
오히려 각 모델의 특성이 나뉘는 모습이다.
- Gemini 4 Argon
Repository 수준의 장기 Software Engineering 작업에 강함 - GPT-6 Astra
FrontierSWE 및 일부 Science/technical reasoning에서 강점 - Claude Opus 5.5
Terminal 기반의 실제 도구 사용과 ML Engineering 작업에서 강함
특히 Terminal-bench 4.0에서는 Claude Opus 5.5가 66.4%로 Argon의 57.4%보다 상당히 높은 성능을 보였다.
따라서 단순히 “Argon이 가장 좋은 Coding 모델이다”라고 정리하는 것보다는,
Argon은 장기 Software Engineering Agent에 강한 모델
이라고 보는 편이 정확하다.
4. 오히려 더 강한 영역은 Knowledge Work
개인적으로 이번 발표에서 Coding보다 더 눈에 띄는 부분은 Enterprise Knowledge Work다.
Google이 공개한 주요 결과를 보면 다음과 같다.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% |
이 영역에서는 Argon이 비교적 명확하게 앞선다.
특히 AutomationBench 51.3%가 눈에 띈다.
AutomationBench는 단순한 QA 능력을 보는 것이 아니라 여러 애플리케이션과 작업을 연결해 business workflow를 실제로 완료할 수 있는지 평가하는 벤치마크다.
따라서 이 점수는 단순 지식량보다는
요청 이해
 ↓
작업 계획
 ↓
도구 선택
 ↓
도구 실행
 ↓
결과 확인
 ↓
다음 단계 수행
같은 Agent 실행 능력을 더 많이 반영한다.
Finance Agent에서도 Argon은 65.4%로 GPT-6 Astra의 53.5%, Claude Opus 5.5의 58.6%보다 높은 점수를 기록했다.
5. 독립 평가에서도 Argon이 1위
물론 제조사가 발표하는 Benchmark만 보고 판단하는 것은 조심할 필요가 있다.
Google의 발표 이후 독립 평가기관 Vals AI에서도 Argon을 평가했다.
2026년 10월 2일 기준 Vals Index 순위는 다음과 같다.
| Rank | Model | Accuracy | Cost / Test |
| 1 | Gemini 4 Argon | 68.90% | $15.68 |
| 2 | Claude Sonnet 5.5 | 67.04% | $21.34 |
| 3 | Claude Opus 5.5 | 66.97% | $32.14 |
| 4 | Claude Fable 5.1 | 65.83% | $28.71 |
| 6 | GPT-6 Astra | 63.13% | $18.46 |
Vals Index는 Finance, Coding, Legal, Tax 등의 Agent task를 미국 산업 비중에 맞춰 종합한 평가다.
여기서 Argon은 단순 Accuracy뿐 아니라 Cost per Test에서도 상당히 경쟁력 있는 결과를 보였다.
Claude Opus 5.5가 66.97%에 테스트당 평균 $32.14가 사용된 데 비해 Argon은 68.90%를 기록하면서 $15.68 수준이었다.
다만 여기서도 주의할 점이 있다. Agent workload가 길어지면 Argon 역시 비용이 크게 증가한다.
Vals의 별도 평가에서는 CUA-bench에서 테스트당 약 $193.78, Code Migration에서는 $57.82까지 비용이 올라갔다.
따라서 Agent에서는 앞으로
Token 가격
보다
업무 하나를 성공적으로 완료하는 데 필요한 총 비용
이 더 중요한 평가 기준이 될 가능성이 높다.
6. Argon이 압도적인 것은 아니다
Google 발표 결과를 전체적으로 보면 Argon이 공개 비교 19개 항목 중 13개에서 1위, 1개에서 공동 1위를 기록했다.
하지만 몇몇 영역에서는 GPT와 Claude가 여전히 강하다. 대표적으로 Science 관련 Terminal-Bench에서는 다음과 같다.
| Model | Terminal-Bench Science |
| GPT-6 Astra | 68.1% |
| Claude Opus 5.5 | 63.3% |
| Gemini 4 Argon | 57.6% |
| Claude Fable 5.1 | 52.6% |
즉 모델들의 포지션을 단순화하면 다음처럼 볼 수 있다.
Gemini 4 Argon
→ Long-horizon Agent
→ Enterprise workflow
→ Finance / Legal
→ Repository-level Software Engineering

GPT-6 Astra
→ Deep Reasoning
→ Science / Technical tasks
→ 일부 Software Engineering

Claude Opus 5.5
→ Terminal Agent
→ Coding Tool Use
→ ML Engineering
한 모델이 모든 영역을 압도한다기보다는 Agent가 어떤 환경에서 일하느냐에 따라 최적 모델이 달라지는 구조에 가까워지고 있다.
7. Google 내부에서도 이미 ‘Agent’로 사용하고 있다
이번 발표에서 Benchmark만큼 흥미로운 것은 Google이 Argon을 내부적으로 실제 업무에 활용하고 있다는 점이다.
공개된 사례에는 대규모 C/C++ → Rust migration, 데이터센터 메모리 최적화, Quantum Algorithm optimization 등이 포함된다.
이 사례들의 공통점은 단순 Code Generation이 아니라는 것이다.
예를 들어 코드 migration은
기존 Codebase 분석
 ↓
Dependency 파악
 ↓
코드 변환
 ↓
Build
 ↓
Compiler Error 분석
 ↓
수정
 ↓
Performance Profiling
 ↓
추가 최적화
와 같이 장기간 반복 작업이 필요하다.
즉 Argon은 Chatbot의 연장선이라기보다는
AI Software Engineer 또는 AI Knowledge Worker
에 가까운 방향으로 설계되고 있다는 의미다.
8. Cybersecurity를 별도로 강조한 이유
Argon 발표에서 상당한 비중을 차지하는 또 하나의 영역은 Cybersecurity다.
Google은 Argon이 취약점을 단순히 설명하는 수준이 아니라,
Attack Surface 탐색
 ↓
취약점 발견
 ↓
취약성 검증
 ↓
Patch 생성
 ↓
Patch 검증
까지 수행할 수 있다고 설명한다.
이러한 능력은 방어 측면에서는 굉장히 유용하지만 반대로 악용될 위험도 크다.
그래서 Google은 Argon을 바로 일반 사용자에게 공개하지 않고, 초기에는 Fairwind Program을 통해 신뢰할 수 있는 Cybersecurity 파트너에게 제한적으로 제공하고 있다.
AI Agent가 강력해질수록 모델 Safety에서 중요한 문제 역시
무엇을 말할 수 있는가?에서
무엇을 실제로 실행할 수 있는가?로 바뀌고 있다는 점을 보여주는 사례다.
9. LLM 경쟁의 기준이 바뀌고 있다
몇 년 전까지만 해도 AI 모델 경쟁의 핵심은 Benchmark 문제를 얼마나 잘 푸는지였다.
흐름을 단순화하면 다음과 같다.
2023~2024

LLM
"얼마나 잘 대답하는가?"

        ↓

2025

Reasoning Model
"얼마나 깊게 생각하는가?"

        ↓

2026

Agent Model
"얼마나 오래 일해서
실제로 작업을 끝낼 수 있는가?"
Gemini 4 Argon은 이 세 번째 단계에 상당히 명확하게 위치한다.
그리고 이번 Benchmark 결과에서도 재미있는 변화가 보인다.
이전에는 MMLU나 GPQA처럼 모델 자체의 문제 해결 능력을 비교했다면,
Argon 발표에서는
- DeepSWE
- FrontierSWE
- AutomationBench
- Finance Agent
- Legal Agent
- Terminal-bench
처럼 Agent가 실제 환경에서 일을 수행하는 능력을 측정하는 Benchmark의 비중이 훨씬 높아졌다.
이것 자체가 AI 모델 경쟁의 방향이 달라지고 있음을 보여준다.
마무리
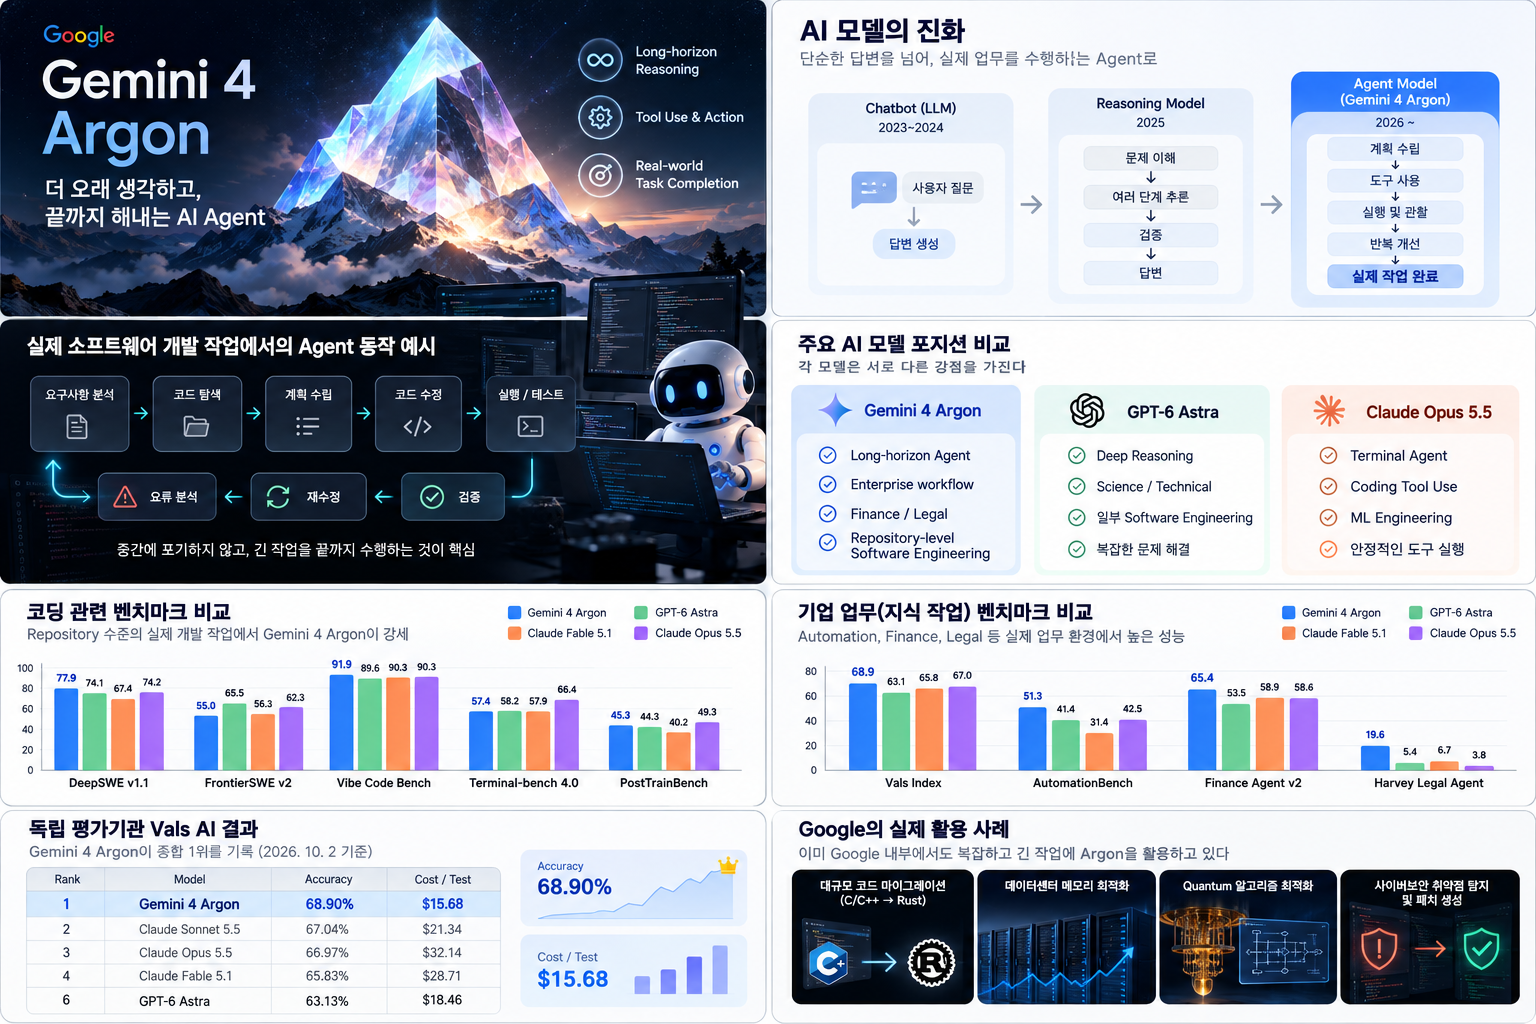
Gemini 4 Argon을 단순히 “Gemini 3보다 성능이 좋아진 Gemini 4”라고 보는 것은 이번 모델의 특징을 충분히 설명하지 못한다.
Argon의 가장 중요한 특징은
긴 시간 동안 Reasoning과 Tool Use를 유지하면서 실제 업무를 완료하는 능력
이다.
실제 Benchmark에서도 Enterprise Knowledge Work, Finance, Automation, Long-horizon Software Engineering에서 상당히 좋은 결과를 보였고, 독립 평가인 Vals Index에서도 현재 1위를 기록했다.
반면 FrontierSWE에서는 GPT-6 Astra, Terminal 작업에서는 Claude Opus 5.5가 더 좋은 결과를 보이는 만큼 “모든 영역에서 가장 뛰어난 모델”이라고 보기는 어렵다.
오히려 중요한 변화는 따로 있다.
앞으로 모델을 비교할 때
누가 더 똑똑한가?라는 질문보다
어떤 Agent가
어떤 환경에서
가장 안정적으로
끝까지 일을 수행하는가?
라는 질문이 더 중요해질 가능성이 높다.
그리고 Gemini 4 Argon은 Google이 그 경쟁에 본격적으로 들어갔다는 신호로 보인다.
참고자료
- Google DeepMind — Gemini 4 Argon / Gemini 모델 및 Benchmark
https://deepmind.google/models/gemini/ - Google — Gemini 4 Argon 공식 발표
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/ - Vals AI — Vals Index
https://www.vals.ai/benchmarks/vals_index - Vals AI — Gemini 4 Argon Evaluation
https://www.vals.ai/models/google_gemini-4-argon
'Tech News' 카테고리의 다른 글
| Microsoft Decision-1 등장 — LLM이 모든 결정을 내릴 필요는 없다 (0) | 2026.10.14 |
|---|---|
| EmbeddingGemma 2 공개 — 740M 모델 하나로 텍스트·이미지·영상·음성을 검색한다 (0) | 2026.10.07 |
| Gemini 3.8 Live 등장 — GPT-Live와 무엇이 다른가? (0) | 2026.09.16 |
| GPT-6 Astra 공개: 이제는 ‘답변하는 AI’보다 ‘직접 일하는 AI’에 가깝다 (0) | 2026.09.04 |
| Google TimesFM-3 공개: 다변량 Zero-shot Forecasting으로 확장된 시계열 Foundation Model (0) | 2026.09.02 |


