Google이 Gemini 3.8 Live와 Gemini 3.8 Live Extended Thinking을 공개했다.
이름에서 알 수 있듯 이번 모델은 텍스트 생성보다는 실시간 음성 대화(Real-time Voice Interaction)에 초점을 맞춘 Gemini 모델이다.
불과 얼마 전 OpenAI도 GPT-Live를 공개하면서 AI가 사용자의 말을 들으면서 동시에 말할 수 있는 Full-Duplex 구조를 강조했다.
그래서 Gemini 3.8 Live를 처음 보면 자연스럽게 이런 생각이 든다.
"이거 GPT-Live랑 비슷한 것 아닌가?"
큰 방향에서는 맞다.
(예전에 작성하였던 글 참고)
GPT-Live는 어떻게 동시에 듣고 말할까? OpenAI의 새로운 음성 AI 구조 분석
OpenAI가 2026년 7월 8일, 새로운 음성 모델 세대인 GPT-Live를 공개했다. 공식 설명에 따르면 GPT-Live는 ChatGPT Voice를 더 자연스럽고 지능적인 대화형 인터페이스로 만들기 위한 모델이다. 핵심 키워드
choiscoding.tistory.com
하지만 두 모델을 조금 더 살펴보면 접근 방식에서 꽤 흥미로운 차이가 있다.
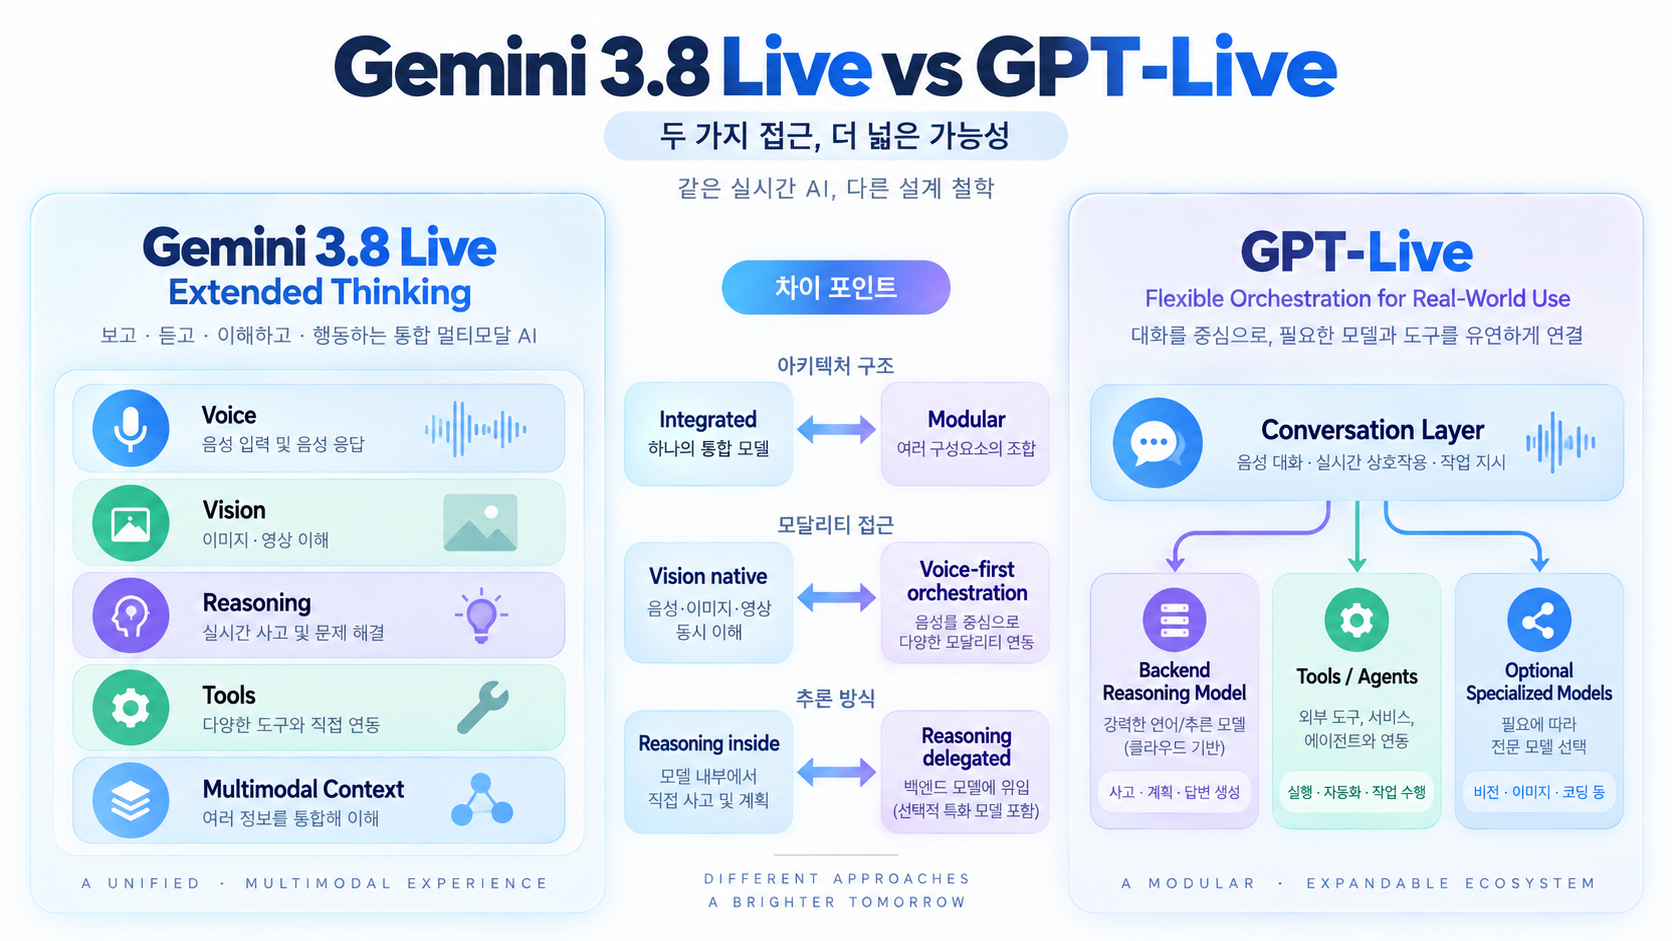
OpenAI가 자연스러운 실시간 대화를 담당하는 Voice Model과 깊은 추론을 담당하는 모델을 조합하는 구조를 강조한다면, Google은 Voice + Multimodal + Reasoning + Tool Use를 하나의 Live 경험 안에 통합하는 방향을 보여주고 있다.
이번 글에서는 Gemini 3.8 Live가 어떤 모델인지 살펴보고, GPT-Live와 무엇이 다른지 정리해본다.
1. Gemini 3.8 Live란?
Gemini 3.8 Live는 Google이 공개한 실시간 대화용 멀티모달 모델이다. 기반 모델은 Gemini 3 Pro이며 단순히 음성만 입력받는 모델은 아니다. 지원하는 입력은 다음과 같다.
- Text
- Audio
- Image
- Video
출력은
- Text
- Audio
를 지원한다.
입력 Context Window는 최대 128K tokens, 출력은 최대 64K tokens다. 즉 단순한 Speech-to-Speech 모델이라기보다,
Voice
  +
Image / Video
  +
Text
  ↓
Gemini 3.8 Live
  ↓
Reasoning
Tool Calling
Visual Understanding
  ↓
Voice / Text
형태의 실시간 Multimodal Agent 모델에 가깝다.
Google은 이번에 두 가지 모델을 공개했다.
Gemini 3.8 Live
낮은 latency와 비용 효율성을 중요하게 생각한 모델이다. 빠른 질의응답이나 고객지원, Voice Search, Language Tutor처럼 즉각적인 대화가 중요한 서비스에 적합하다.
Gemini 3.8 Live Extended Thinking
보다 복잡한 reasoning과 multi-step task 처리를 위한 모델이다. 단순히 질문에 바로 대답하는 것이 아니라,
Planning
↓
Reasoning
↓
Tool Calling
↓
결과 분석
↓
다음 Tool Calling
같은 여러 단계의 작업을 실시간 음성 대화와 함께 수행한다. 이번 발표에서 특히 관심 있게 볼 모델은 이 Extended Thinking이다.
2. Gemini 3.8 Live의 핵심은 단순한 '음성 대화'가 아니다
기존 Voice AI는 대체로 다음과 같은 구조였다.
사용자 음성
   ↓
Speech-to-Text
   ↓
LLM
   ↓
Text-to-Speech
   ↓
AI 음성
문제는 여러 단계가 순차적으로 실행되기 때문에 latency가 발생한다는 것이다. 최근 Voice AI 모델들은 이 구조를 하나의 모델로 통합하는 방향으로 발전하고 있는 것같음. Gemini 3.8 Live 역시 Native Audio 기반으로 사용자와 직접 음성으로 상호작용한다.
하지만 이번 발표에서 더 중요한 변화는 따로 있다.
AI가 대화하면서 동시에 일을 할 수 있다는 점이다.
3. Extended Thinking — AI가 말하면서 생각한다
Gemini 3.8 Live Extended Thinking의 가장 흥미로운 기능은 Background Reasoning이다. 기존 Voice Agent에게 시간이 걸리는 작업을 시키면 문제가 하나 발생한다.
예를 들어 다음과 같이 요청했다고 해보자.
"다음 주 서울에서 도쿄 가는 항공편을 찾아보고 가격과 시간을 비교해줘."
AI가 해야 하는 작업은 생각보다 많다.
요청 이해
↓
여행 일정 Planning
↓
항공편 Search API
↓
검색 결과 분석
↓
가격 비교
↓
조건 확인
↓
최종 답변
이 과정에 몇 초가 걸리면 기존 Voice AI는 그동안 아무 말도 하지 못하는 경우가 있다.
사람 입장에서는 AI가 멈춘 것처럼 느껴진다. Gemini 3.8 Live Extended Thinking은 이 문제를 다른 방식으로 해결한다.
사용자 요청
      │
      ├─────────────→ Background Reasoning
      │                     │
      │                     ├─ Planning
      │                     ├─ Tool A
      │                     ├─ Tool B
      │                     └─ 결과 분석
      │
      ↓
"확인해볼게요."
"몇 가지 옵션을 비교하고 있습니다."
      │
      ↓
대화 계속
즉 Reasoning과 Conversation을 동시에 진행한다. Google 문서에서는 이를 위해 모델이
"Checking flight options now."
같은 Conversational Filler를 말하면서 뒤에서는 계속 reasoning과 tool call을 실행할 수 있다고 설명한다.
여기서 단순한 filler 이상의 의미가 있다.
모델이 현재 작업 상태를 알고 있기 때문에
IN_PROGRESS
상태에서는 중간 진행 상황을 알려주고,
모든 reasoning과 tool execution이 끝나면
IDLE
상태로 전환된다.
기존의
Question
→ Thinking
→ Answer
에서
           ┌─ Conversation
Question ──┼─ Reasoning
           └─ Tool Execution

               ↓

             Answer
구조로 바뀌고 있는 것이다. 이 부분은 GPT-Live와도 비슷해보인다.
4. Tool Calling도 Background에서 실행한다
Extended Thinking에서는 Tool Calling 역시 중요한 역할을 한다. Google은 Extended Thinking에서 Asynchronous Tool Calling을 사용한다.
예를 들어 여행 Agent라면 동시에
Flight Search API
Hotel Search API
Weather API
Calendar API
등을 호출할 수 있다.
중요한 점은 그 과정에서 음성 interaction이 중단되지 않는다는 것이다.
따라서 앞으로 Voice Agent는 단순히
"오늘 날씨 알려줘."
같은 질문에 답하는 수준을 넘어
"다음 주 출장 일정 확인하고 항공편 몇 개 찾아서 회의 일정에 맞는 것으로 비교해줘."
같은 업무도 처리할 수 있게 된다.
Google은 실제 Extended Thinking 활용 사례로
- Multi-step technical support
- Travel / Booking Agent
- STEM Tutor
- Code Debugging
- 여러 API를 사용하는 Data Retrieval
등을 제시하고 있다.
5. 음성 모델인데 카메라도 볼 수 있다
Gemini 3.8 Live의 또 다른 특징은 Multimodal Input이다. (GPT-Live와 제일 큰 차별점이라 느껴지는 부분)
Gemini 3.8 Live는
Audio
Image
Video
Text
를 모두 입력으로 받을 수 있다.
따라서 Voice Agent가 단순히 사용자의 말을 듣는 것이 아니라 사용자가 보고 있는 환경까지 이해하는 구조를 만들 수 있다.
예를 들어 스마트폰 카메라를 보면서
"여기서 어떤 버튼을 눌러야 해?"
라고 물으면, AI가 화면을 보고
"오른쪽 위에 있는 Settings 버튼을 눌러보세요."
라고 안내하는 것이 가능하다.
구조를 단순화하면 다음과 같다.
Camera ─────┐
            │
Microphone ─┼─→ Gemini 3.8 Live
            │
Text ───────┘
                 │
                 ├─ Visual Understanding
                 ├─ Reasoning
                 └─ Tool Calling
                        │
                        ↓
                   Voice Response
Google이 Gemini에서 계속 강조해 온 Native Multimodal 전략이 Live 모델까지 확장된 셈이다.
6. 성능은 어느 정도일까?
Google이 공개한 평가 결과에서 특히 눈에 띄는 것은 Gemini 3.8 Live Extended Thinking이다.
공개된 주요 결과는 다음과 같다.
| Benchmark | Gemini 3.8 Live Extended Thinking |
| Speech-to-Speech Quality Index | 82.6 |
| τ-Voice | 68.6% |
| τ-Voice Banking | 35.1% |
| BIG-Bench Audio | 97.7% |
Speech-to-Speech Quality Index는 전체적인 Voice AI 품질을 평가하고, τ-Voice는 단순한 음성 품질이 아니라 Voice Agent가 실제 Tool을 사용하면서 task를 수행하는 능력을 평가한다.
즉 이번 모델에서 Google이 강조하는 것은 단순히
"목소리가 자연스러워졌다."
가 아니다.
오히려
"음성으로 대화하면서 실제 Agent Task를 얼마나 잘 수행할 수 있는가"
쪽에 더 가깝다.
다만 GPT-Live와 Gemini가 공개한 benchmark가 완전히 동일하지 않기 때문에 수치만 놓고 어느 모델이 더 좋다고 비교하는 것은 어렵다.
7. 그렇다면 GPT-Live와 무엇이 다른가?
여기서 자연스럽게 GPT-Live와 비교하게 된다.
OpenAI는 2026년 7월 GPT-Live를 공개했고, 9월에는 개발자가 사용할 수 있는 GPT-Live-1 API도 공개했다.
GPT-Live의 핵심은 Full-Duplex Conversation이다.
기존 Voice AI는 기본적으로
User Speaking
     ↓
AI Waiting

User Stop
     ↓
AI Speaking
처럼 turn을 번갈아가며 처리했다.
GPT-Live에서는
USER ──────────────────▶

       AI ──────────────────▶
처럼 AI가 듣고 말하는 것을 동시에 수행할 수 있다.
그래서 사용자가 AI의 말을 중간에 끊거나,
"아니 잠깐, 내가 말한 건 그게 아니라..."
라고 방향을 바꾸어도 훨씬 자연스럽게 대응할 수 있다.
OpenAI는 이를 위해 기존 Voice System의 Turn Detector를 Audio Path에서 제거했다.
GPT-Live 자체가 계속 들어오는 Audio Stream을 보면서
- 계속 들을지
- 말할지
- 기다릴지
- 끼어들지
- Tool을 호출할지
를 지속적으로 판단한다. Voice UX 관점에서 상당히 중요한 변화다.
8. GPT-Live는 '대화', Gemini는 '통합된 Reasoning'에 조금 더 무게가 있다
두 모델에서 가장 흥미로운 차이는 Deep Reasoning을 처리하는 방식이다.
GPT-Live는 복잡한 reasoning이 필요할 경우 다른 모델이나 Agent에게 작업을 Delegate할 수 있도록 설계되어 있다.
예를 들어
                GPT-Live
             Conversation
                  │
                  │
          Complex Request
                  │
                  ▼
          Backend Model
       GPT-6 Astra / etc.
                  │
             Reasoning
                  │
             Tool Use
                  │
                  ▼
               Result
                  │
                  ▼
              GPT-Live
같은 구조다.
즉 GPT-Live가 실시간 Conversation Layer 역할을 하고, 복잡한 작업은 뒤의 Reasoning Model이나 Agent가 담당한다.
이 구조의 장점은 상당히 명확하다. 업무 난이도에 따라 backend 모델을 바꿀 수 있다.
간단한 Task → 빠른 모델

복잡한 Task → 강한 Reasoning 모델

Coding Task → Coding Agent
처럼 구성할 수 있다. 상당히 Modular한 구조다.
9. Gemini는 조금 더 통합된 방향이다
반면 Gemini 3.8 Live Extended Thinking은 모델 자체가 Gemini 3 Pro 기반 Reasoning Model이다.
즉 제품 인터페이스 관점에서
Gemini 3.8 Live Extended Thinking

┌───────────────────────────┐
│ Voice Conversation        │
│                           │
│ Multimodal Understanding  │
│                           │
│ Background Reasoning      │
│                           │
│ Tool Calling              │
│                           │
│ Visual Understanding      │
└───────────────────────────┘
을 하나의 Live Model 경험으로 묶었다. 물론 Google 내부에서도 실제 inference 과정에 여러 시스템이 사용될 가능성이 있고, 세부 내부 구조까지 공개된 것은 아니다. 그래도 개발자 인터페이스 관점에서는
Gemini = Integrated Live Reasoning
GPT-Live = Modular Live Conversation + Backend Reasoning
이라는 차이가 보인다.
10. Gemini 3.8 Live vs GPT-Live
정리하면 다음과 같다.
| 모델 | Gemini 3.8 Live Extended Thinking | GPT-Live-1 |
| 핵심 목표 | Real-time Multimodal Agent | Natural Full-Duplex Voice Agent |
| 실시간 Voice | 지원 | 지원 |
| 듣기 + 말하기 | 지원 | Full-Duplex를 핵심으로 강조 |
| Interrupt 처리 | 지원 | 강하게 강조 |
| Vision | Image + Video 입력 지원 | ChatGPT Live 모델 자체는 현재 Video/Screen Share 미지원 |
| Reasoning | 모델 내부 Extended Thinking | Backend Reasoning Model에 Delegate 가능 |
| Tool Calling | Async Tool Calling | Tool / Agent delegation |
| Context | 128K | 세션/구성에 따라 관리 |
| Architecture 방향 | Integrated | Modular |
| 강점 | Voice + Vision + Reasoning + Tools | Natural Conversation + Flexible Agent Backend |
결국 두 회사가 해결하려는 문제는 비슷하지만 접근법은 조금 다르다.
OpenAI는
사람처럼 자연스럽게 대화하는 모델
을 중심에 두고 그 뒤에 여러 Reasoning Agent를 연결하려는 모습이고,
Google은
보고, 듣고, 생각하고, Tool을 실행하면서 대화하는 Multimodal Agent
를 하나의 모델 경험으로 묶으려는 방향에 조금 더 가깝다.
11. 결국 Voice AI에서 Voice Agent로
이번 Gemini 3.8 Live 발표에서 개인적으로 가장 흥미로운 부분은 모델의 음성 품질 자체보다 Voice Agent라는 방향이다.
Voice AI의 발전을 단순화하면 대략 다음과 같다.
1세대

Speech
 ↓
STT
 ↓
LLM
 ↓
TTS


2세대

Speech
 ↓
Native Audio Model
 ↓
Speech


3세대

                  ┌─ Reasoning
                  ├─ Search
                  ├─ Tools
Voice ────────────┼─ Agents
                  ├─ Vision
                  └─ External API

                       │
                       ↓

                Conversation 유지
이제 경쟁의 기준이
"AI의 목소리가 얼마나 자연스러운가?"
에서
"AI가 나와 계속 대화하면서 실제로 얼마나 많은 일을 처리할 수 있는가?"
로 이동하고 있는 것으로 보인다. GPT-Live와 Gemini 3.8 Live Extended Thinking 모두 결국 이 방향을 바라보고 있다.
12. 실제로 만들어볼 만한 것 — AI Meeting Agent
이번 발표를 보면서 개인적으로 가장 먼저 떠오른 활용 사례는 화상회의용 AI Agent다.
예를 들어 Zoom이나 Google Meet의 Audio Stream을 Gemini 3.8 Live에 연결하면 다음과 같은 구조를 생각해볼 수 있다.
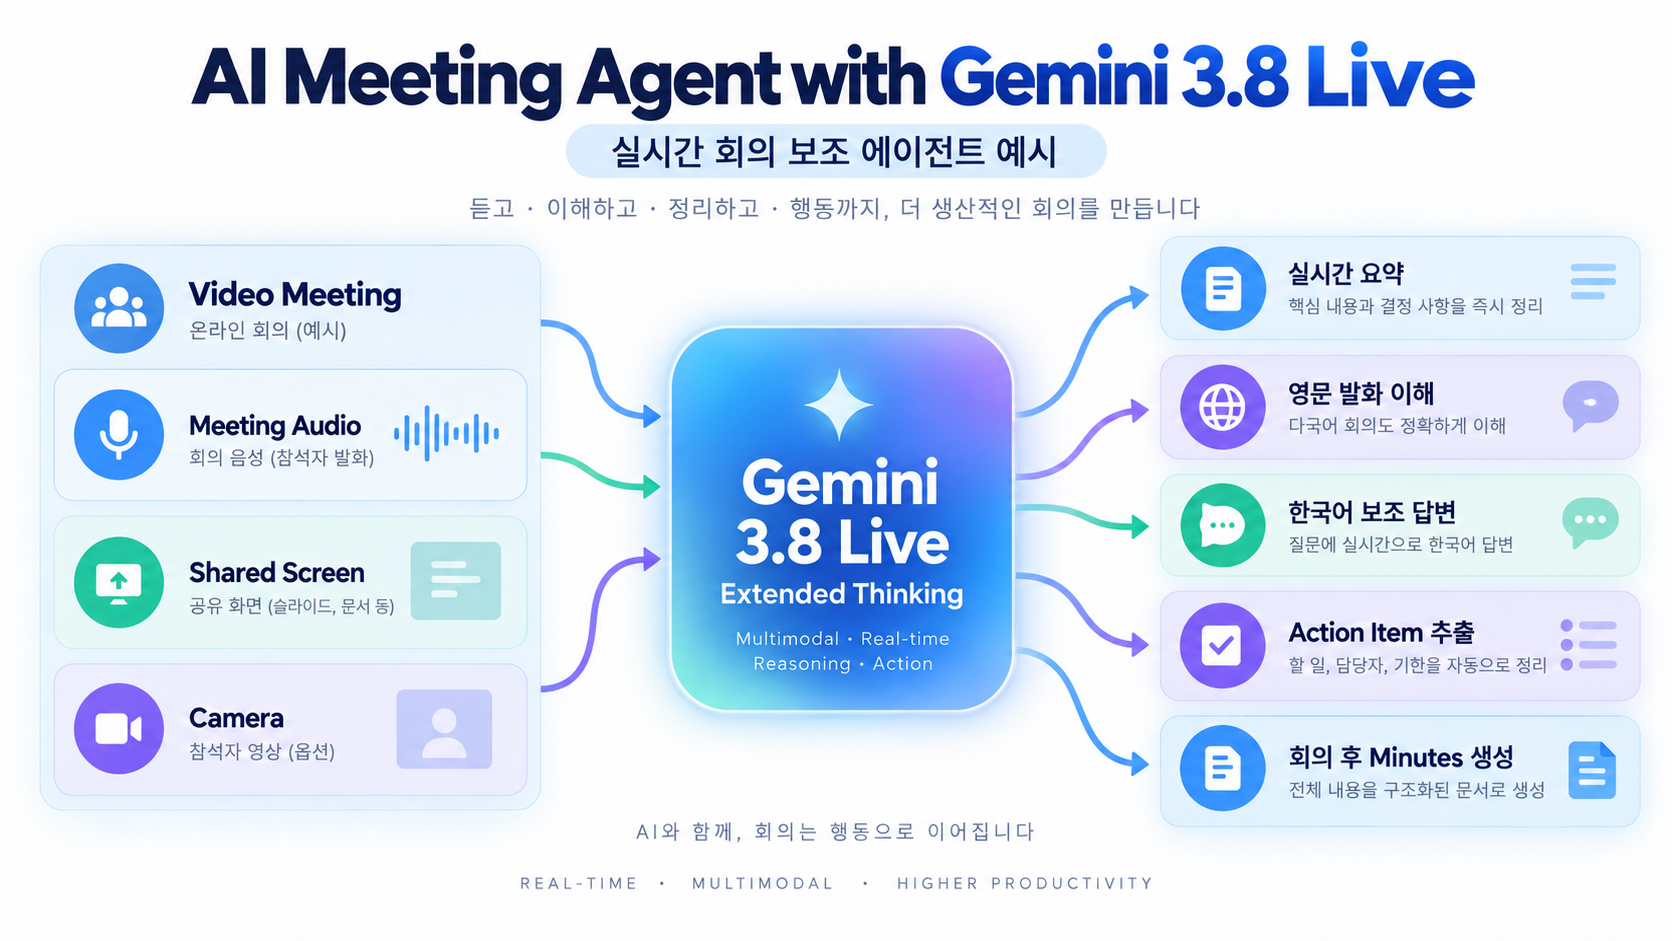
단순히 회의를 녹취하는 것이 아니라,
회의 도중
"방금 상대방이 요구한 내용이 기존 요구사항에 있었나?"
라고 물으면 관련 문서를 찾아보고,
"지난 문서에는 해당 요구사항이 없었고 이번 회의에서 처음 추가되었습니다."
처럼 알려주는 Agent도 생각해볼 수 있다.
또 회의가 끝난 뒤에는
Meeting Summary
Decision
Open Issue
Action Item
Owner
Deadline
까지 자동으로 정리할 수 있다.
Gemini 3.8 Live의 Multimodal Input + Extended Thinking + Async Tool Calling을 활용하기 좋은 사례다.
개인적으로도 API가 어느 정도 안정화되면 간단한 Meeting Agent 프로젝트로 한번 만들어볼 만해 보인다.
마무리
Gemini 3.8 Live만 놓고 보면 처음에는 GPT-Live와 상당히 비슷한 모델처럼 보인다.
실제로 두 모델 모두
- 실시간 음성 대화
- 자연스러운 Interaction
- Tool Calling
- Agent Workflow
를 목표로 하고 있다.
하지만 조금 더 살펴보면 방향에서 차이가 있다.
GPT-Live
Natural Conversation
        +
Backend Reasoning / Agent
Gemini 3.8 Live Extended Thinking
Voice
+
Vision
+
Reasoning
+
Tools
+
Multimodal Context
OpenAI가 Conversation Layer와 Reasoning Layer를 유연하게 조합하는 방향이라면 Google은 Multimodal Reasoning 자체를 Live Interaction 안으로 끌어들이는 방향에 조금 더 가깝다.
결국 두 접근법 모두 도착하려는 곳은 비슷해 보인다.
우리가 AI에게 명령을 입력하고 결과가 나올 때까지 기다리는 것이 아니라, 사람과 이야기하듯 대화를 계속하면서 뒤에서는 AI가 생각하고, 검색하고, 도구를 사용하고, 실제 업무까지 처리하는 환경이다. 이번 Gemini 3.8 Live Extended Thinking은 그 방향이 꽤 구체적인 형태로 나타난 모델이라고 볼 수 있다.
참고자료
- Google Blog — Introducing Gemini 3.8 Live and Gemini 3.8 Live Extended Thinking
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/ - Google DeepMind — Gemini 3.8 Audio Model Card
https://deepmind.google/models/model-cards/gemini-3-8-audio/ - Google AI for Developers — Live API Overview
https://ai.google.dev/gemini-api/docs/live - Google AI for Developers — Thinking in the Live API
https://ai.google.dev/gemini-api/docs/live-api/thinking - OpenAI — Introducing GPT-Live-1 in the API
https://openai.com/index/introducing-gpt-live-1-in-the-api/ - OpenAI — Continuous Voice Interaction with GPT-Live
https://openai.com/index/continuous-voice-interaction-with-gpt-live/
'Tech News' 카테고리의 다른 글
| GPT-6 Astra 공개: 이제는 ‘답변하는 AI’보다 ‘직접 일하는 AI’에 가깝다 (0) | 2026.09.04 |
|---|---|
| Google TimesFM-3 공개: 다변량 Zero-shot Forecasting으로 확장된 시계열 Foundation Model (0) | 2026.09.02 |
| GLM-5.3 공개: 코딩 에이전트 성능 강화와 Emergent Cyber Capability (0) | 2026.08.14 |
| Grok 4.6 공개: 더 똑똑한 모델보다 오래 일하는 Agent에 집중했다 (0) | 2026.08.13 |
| Inkling-Small 공개: 4분의 1 크기로 대형 Inkling을 넘어선 모델 (0) | 2026.07.31 |


