Google DeepMind가 2026년 10월 6일 새로운 임베딩 모델인 EmbeddingGemma 2를 공개했다.
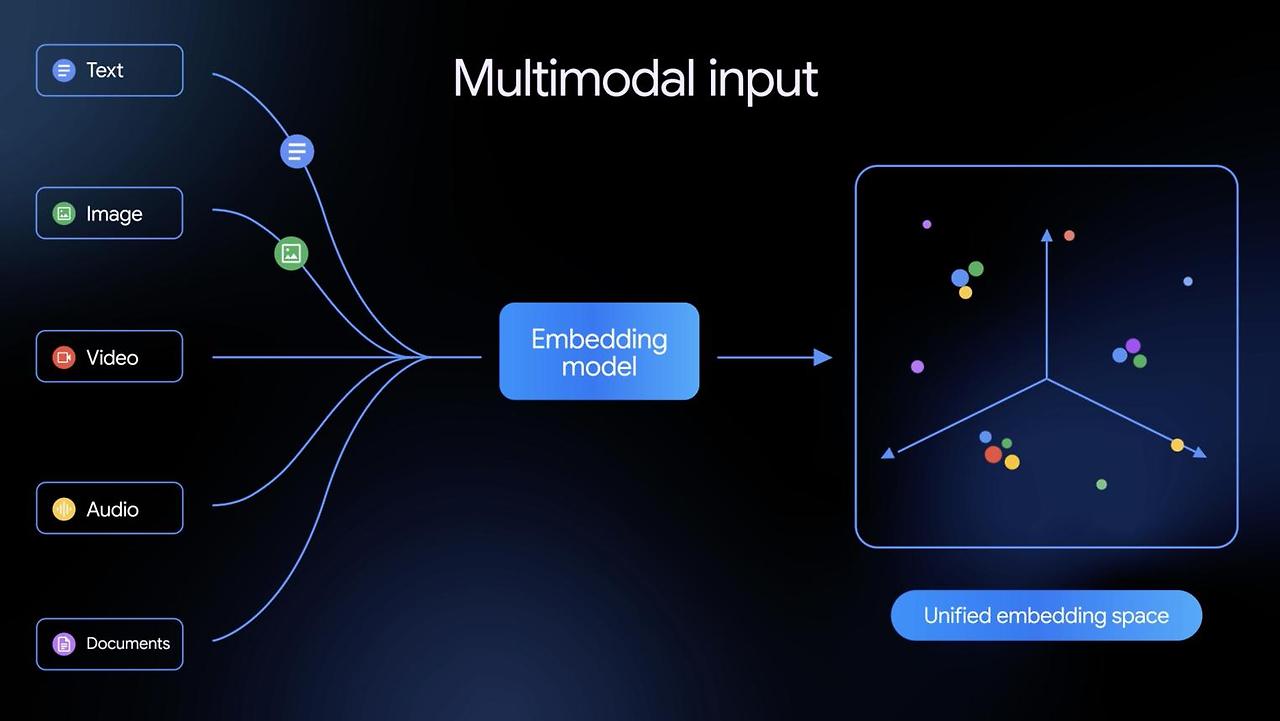
기존 임베딩 모델이 주로 텍스트를 벡터로 변환하는 데 집중했다면, 이번 EmbeddingGemma 2는 텍스트뿐 아니라 이미지, 영상, 음성까지 하나의 벡터 공간에 표현할 수 있는 Multimodal Embedding 모델이다.
특히 눈에 띄는 것은 전체 모델이 740M 파라미터로 구성되어 있다는 점이다.
최근 AI 모델이 점점 커지는 방향으로 발전하는 가운데, Google은 작은 모델로 다양한 모달리티를 처리하면서 스마트폰이나 로컬 환경에서도 활용할 수 있도록 설계했다.
이번 글에서는 EmbeddingGemma 2의 구조와 성능을 살펴보고, 텍스트가 아닌 이미지와 음성을 어떻게 임베딩할 수 있는지, 기존 CLIP과 어떤 차이가 있는지도 정리해 보려 한다.
1. EmbeddingGemma 2는 어떤 모델인가?
EmbeddingGemma 2는 Google DeepMind가 공개한 오픈 웨이트 멀티모달 임베딩 모델이다.
임베딩은 텍스트나 이미지 같은 데이터를 의미를 표현하는 숫자 벡터로 변환하는 기술이다.
예를 들어 다음 두 문장을 생각해 볼 수 있다.
-
"A dog running on the beach"
-
"해변에서 뛰어가는 강아지"
서로 다른 언어로 작성되었지만 의미는 거의 동일하다.
임베딩 모델은 이처럼 의미가 비슷한 문장들이 벡터 공간에서도 가까운 위치에 표현되도록 학습한다.
EmbeddingGemma 2는 이러한 원리를 이미지, 영상, 음성으로 확장한 모델이다.
| 항목 | EmbeddingGemma 2 |
| 개발사 | Google DeepMind |
| 기반 아키텍처 | Gemma 4 |
| 전체 파라미터 | 740M |
| 텍스트 전용 구성 | 270M |
| 지원 입력 | Text, Code, Image, Video, Audio |
| 최대 입력 | 8,192 Tokens |
| 임베딩 차원 | 768 / 512 / 256 / 128 |
| 언어 지원 | 100개 이상 |
| 라이선스 | Apache 2.0 |
핵심은 서로 다른 형식의 데이터를 하나의 공통 벡터 공간(Unified Embedding Space)에 표현한다는 것이다.
이를 활용하면 텍스트 질문으로 이미지를 검색하거나, 관련된 영상과 문서를 하나의 검색 시스템에서 다룰 수 있다.
2. 이미지도 그대로 검색할 수 있다는 것은 무슨 의미인가?
일반적인 텍스트 기반 RAG에서는 문서를 Chunk 단위로 나누고 각각을 임베딩한 뒤 Vector DB에 저장한다.
하지만 이미지 검색은 조금 다르다.
기존 텍스트 임베딩 모델만 사용하는 경우에는 이미지에 대한 설명문을 생성하거나 태그를 추가하는 과정이 필요하다.
예를 들어 강아지 사진이 있다면 다음과 같은 설명을 생성하는 방식이다.
이미지 → "해변에서 뛰어가는 강아지" → Text Embedding
반면 EmbeddingGemma 2는 이미지 자체를 입력받아 임베딩을 생성할 수 있다.
이미지 → Vision Encoder → Image Embedding
이미지 검색 예시
사용자가 다음과 같이 검색한다고 가정해 보자.
"해변에서 뛰어노는 강아지 사진을 찾아줘"

이미지 자체를 벡터로 저장하고 사용자의 텍스트 질문도 같은 벡터 공간으로 변환하므로, 두 데이터 사이의 의미적 유사도를 계산할 수 있다.
즉 별도의 이미지 설명문을 생성하지 않더라도 관련 이미지를 검색할 수 있다는 의미다.
다만 이미지 안의 작은 글씨나 정확한 수치까지 모두 인식한다는 뜻은 아니다. OCR이나 별도의 이미지 분석 모델이 필요한 경우도 있다.
3. 텍스트가 아닌 이미지는 어떻게 임베딩하는가?
이번 모델에서 가장 흥미로운 부분은 이미지나 음성과 같은 비정형 데이터를 어떻게 숫자 벡터로 변환하는지다.
사실 이러한 기술은 새롭게 등장한 것이 아니다.
대표적인 사례가 OpenAI가 2021년에 발표한 CLIP(Contrastive Language–Image Pre-training) 이다.
CLIP은 이미지와 텍스트를 각각의 Encoder로 처리하고, 서로 관련된 이미지와 문장이 벡터 공간에서 가까워지도록 학습하는 모델이다.
3.1 Vision Encoder — 이미지를 특징 벡터로 변환한다
이미지는 텍스트처럼 단어 단위로 구성되어 있지 않다.
따라서 일반적인 Vision Transformer에서는 이미지를 작은 Patch 단위로 나눈 뒤 각 Patch의 시각적 특징을 추출한다.
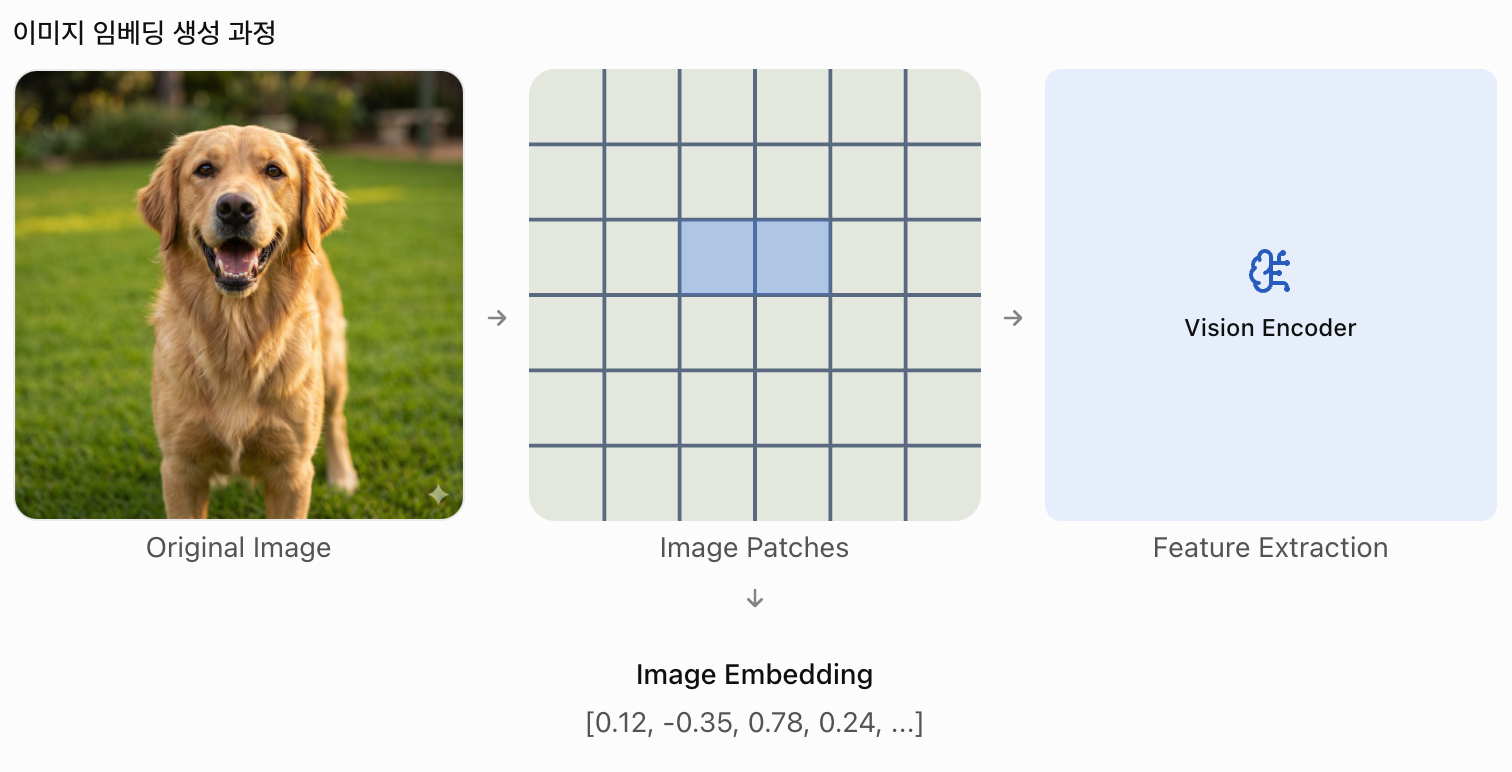
여기서 중요한 것은 단순히 픽셀을 숫자로 변환하는 것이 아니라는 점이다.
Vision Encoder는 학습을 통해 객체의 형태, 색상, 배경, 시각적 관계 등 의미 있는 특징을 추출한다.
이러한 특징을 이용해 이미지 전체를 하나의 벡터로 표현할 수 있다.
3.2 Contrastive Learning — 이미지와 텍스트를 연결하는 방법
그렇다면 이미지 Encoder와 텍스트 Encoder가 서로 다른 방식으로 생성한 벡터를 어떻게 비교할 수 있을까?
이때 중요한 기술이 Contrastive Learning(대조 학습) 이다.
대조 학습은 관련 있는 데이터 쌍은 가까워지고, 관련 없는 데이터 쌍은 멀어지도록 모델을 학습시키는 방식이다.
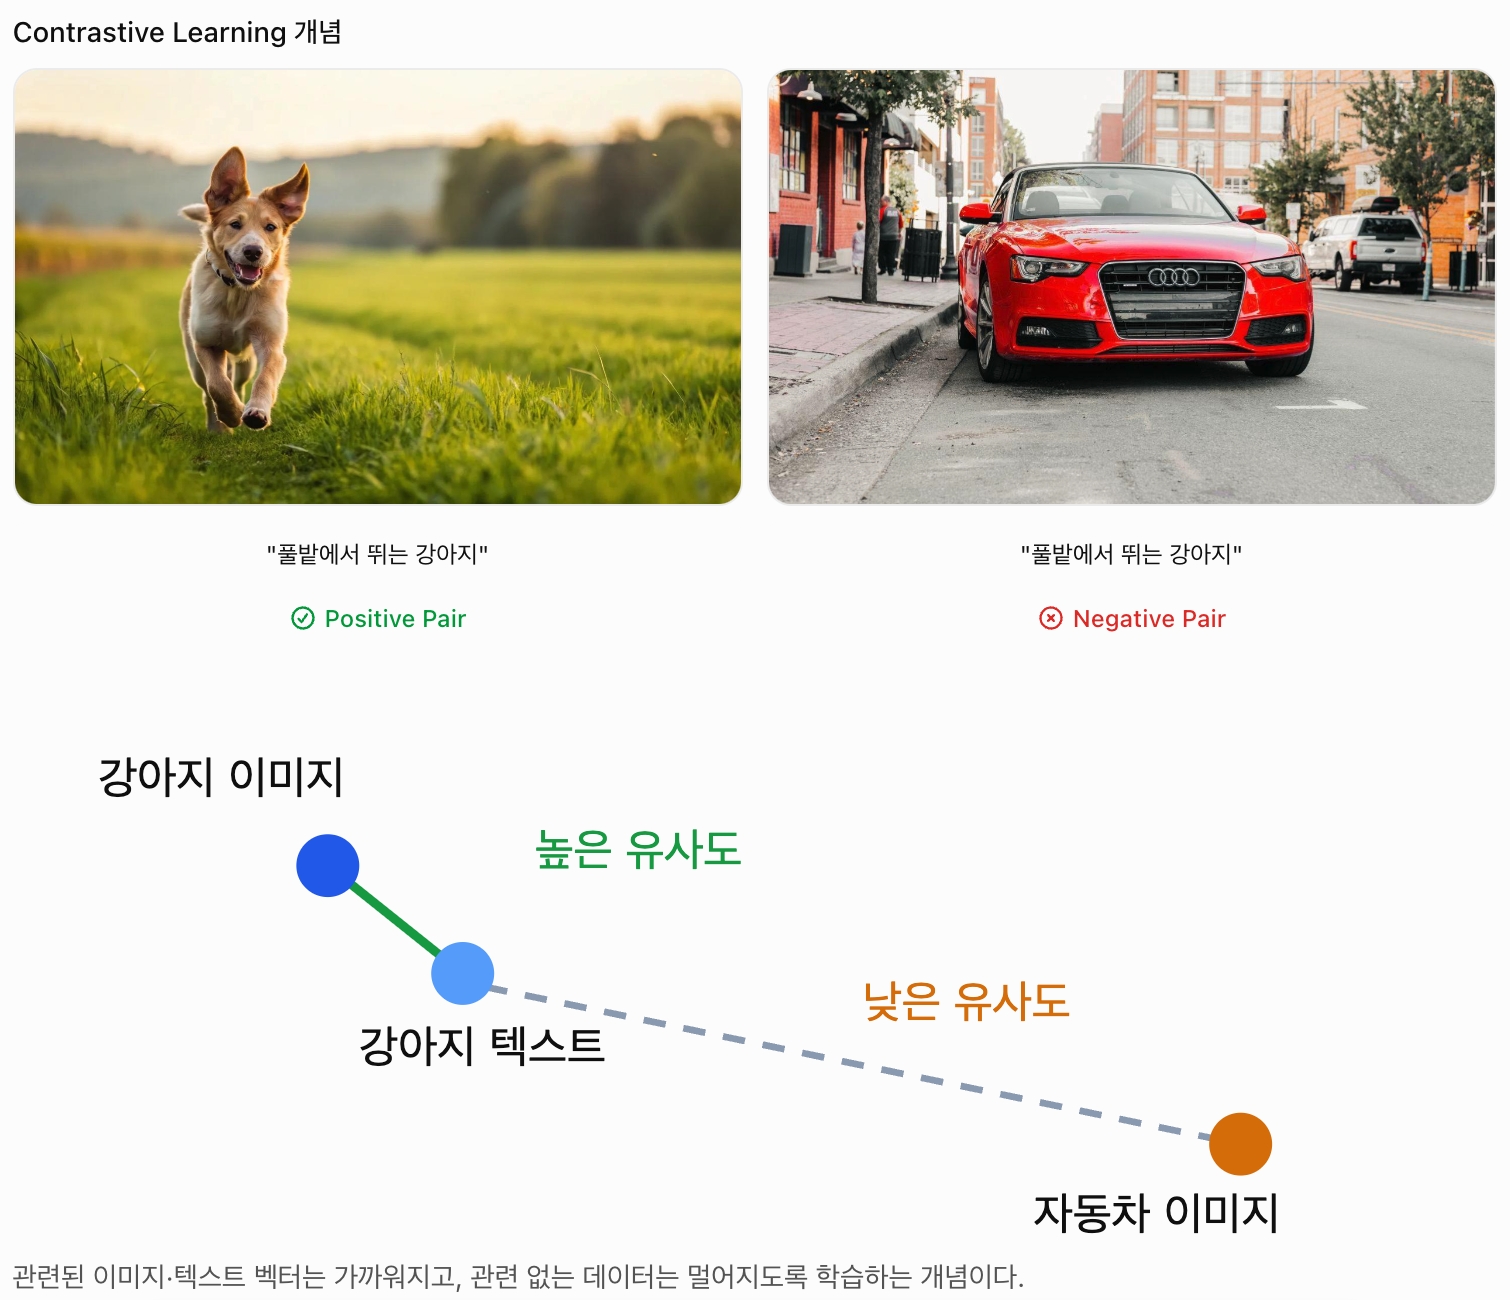
이러한 학습을 통해 서로 다른 모달리티라도 의미적으로 관련된 데이터는 비슷한 벡터로 표현할 수 있다.
실제 검색에서는 Cosine Similarity를 이용해 벡터 간 유사도를 계산할 수 있다.
다만 이 방식은 CLIP을 비롯한 멀티모달 임베딩 모델의 대표적인 학습 원리를 설명한 것으로, EmbeddingGemma 2가 CLIP과 완전히 동일한 학습 방식을 사용한다는 의미는 아니다.
4. EmbeddingGemma 2의 모델 구조
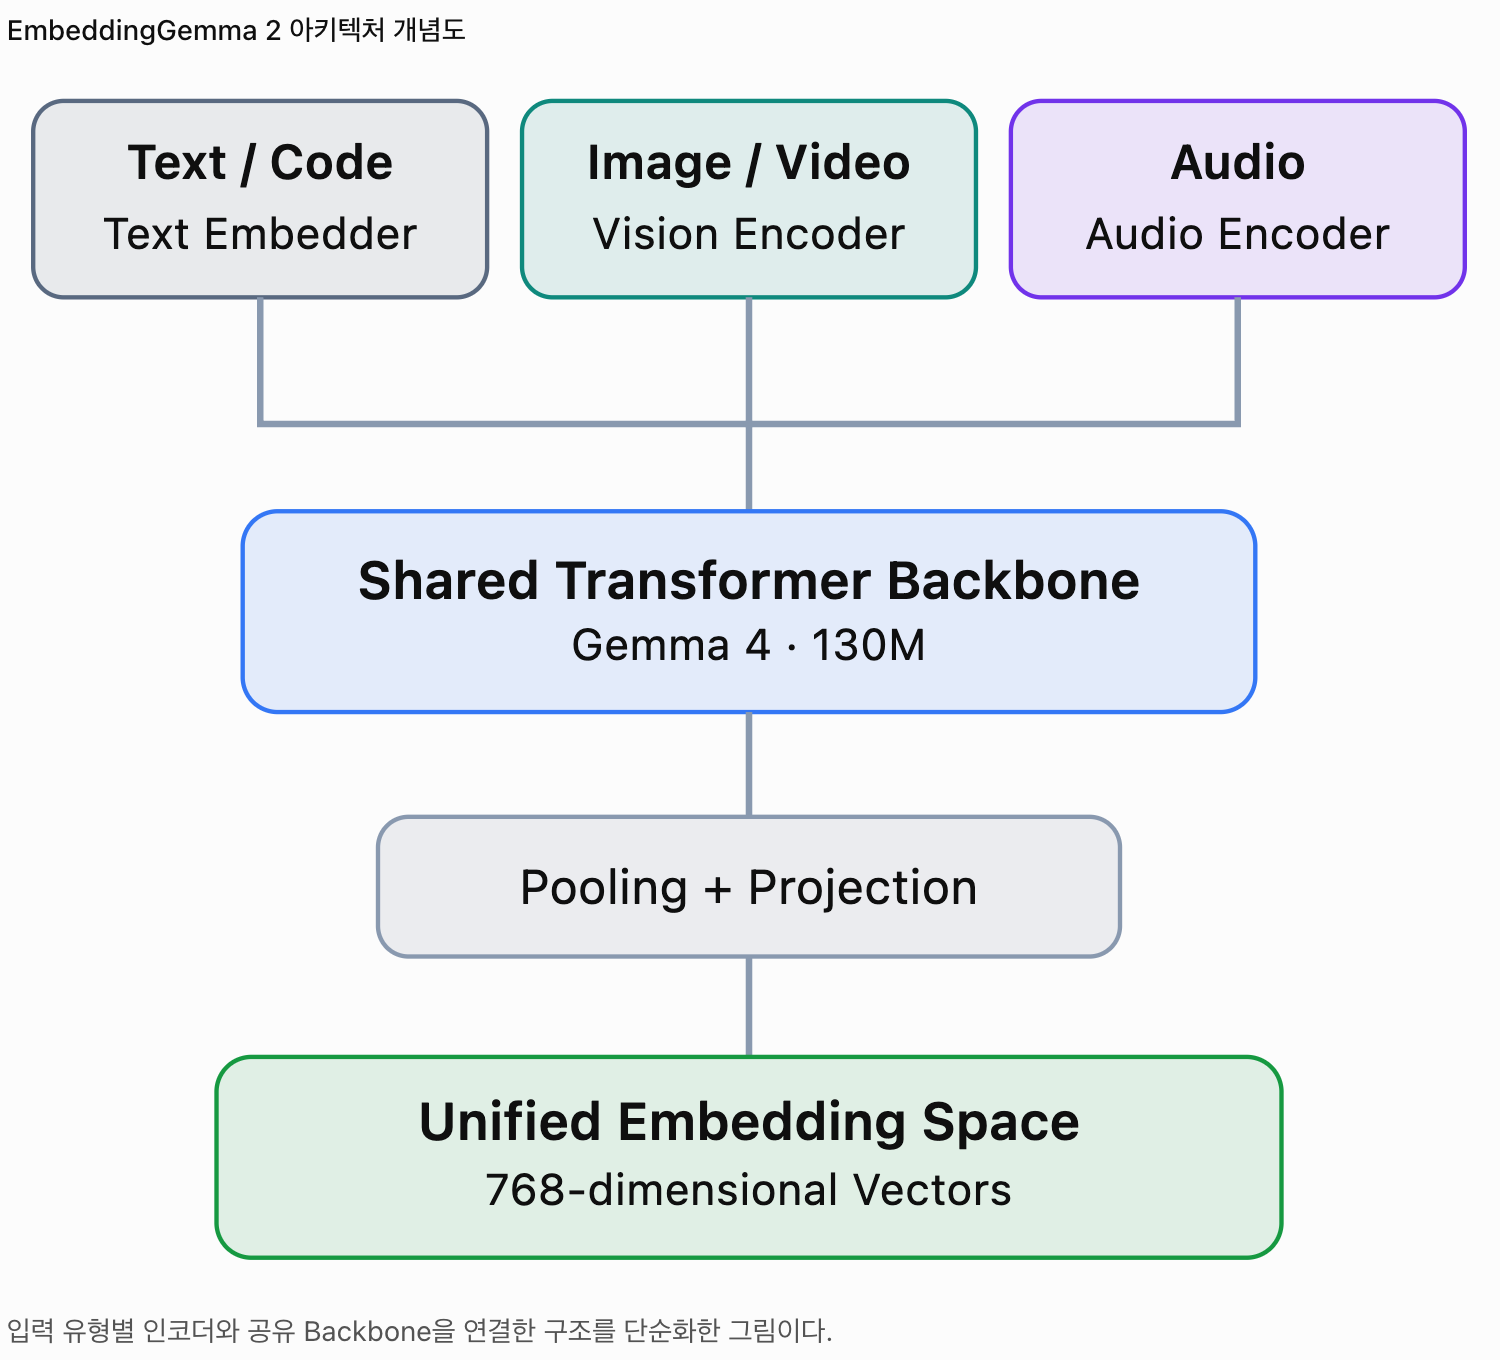
EmbeddingGemma 2는 Gemma 4를 기반으로 하며, 데이터 유형에 따라 서로 다른 Encoder를 사용한다.
텍스트와 코드는 Text Embedder, 이미지와 영상은 Vision Encoder, 음성은 Audio Encoder로 처리한다. 이렇게 추출한 특징을 공유 Transformer Backbone에 전달하고, 최종적으로 동일한 차원의 벡터로 변환한다.
전체 모델은 다음과 같이 구성된다.
| 구성 요소 | 파라미터 | 역할 |
| Transformer Backbone | 130M | 공통 특징 처리 |
| Text Embedder | 140M | 텍스트 및 코드 처리 |
| Vision Encoder | 170M | 이미지 및 영상 처리 |
| Audio Encoder | 300M | 음성 처리 |
| 합계 | 740M | 전체 멀티모달 처리 |
여기서 흥미로운 부분은 Modular Architecture다.
모든 모달리티를 사용하지 않더라도 필요한 Encoder만 선택적으로 로딩할 수 있다.
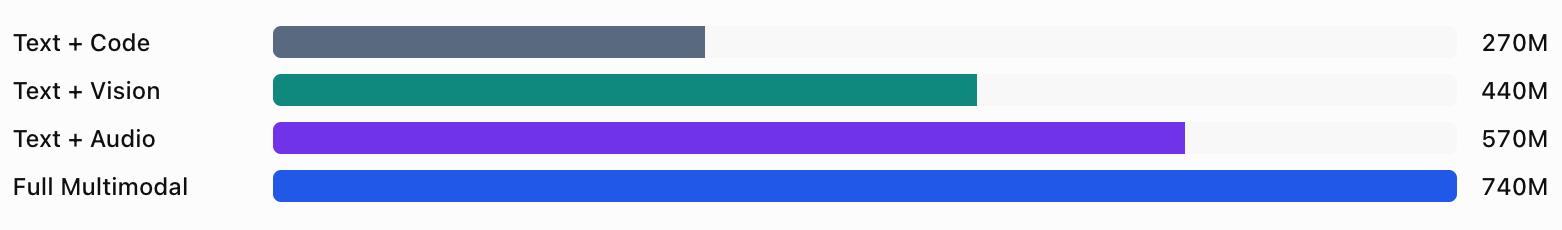
예를 들어 일반적인 RAG 시스템에서는 270M 텍스트 구성만 사용하고, 이미지 검색까지 필요하다면 Vision Encoder를 추가한 440M 구성을 사용할 수 있다.
또한 서로 다른 구성을 사용하더라도 동일한 의미 공간에서 벡터를 비교할 수 있도록 설계되었다. 이는 텍스트 기반 검색 시스템에서 멀티모달 검색으로 확장할 때 유용한 특징이다.
5. 기존 CLIP, ImageBind와의 차이점
멀티모달 임베딩 자체는 새로운 기술이 아니다. 대표적으로 OpenAI의 CLIP과 Meta의 ImageBind가 있다.
| 모델 |
발표 | 특징 |
| CLIP | 2021 | 이미지·텍스트 대조 학습 |
| ImageBind | 2023 | 이미지·텍스트·음성·깊이·열화상·IMU 통합 |
| EmbeddingGemma 1 | 2025 | 경량 텍스트 임베딩 |
| EmbeddingGemma 2 | 2026 | 텍스트·이미지·영상·음성 통합 및 온디바이스 최적화 |
CLIP은 이미지와 텍스트 사이의 의미적 관계를 학습하는 데 집중했다.
이후 Meta의 ImageBind는 이미지와 텍스트뿐 아니라 오디오, 열화상, IMU와 같은 다양한 센서 데이터도 공통 임베딩 공간에 표현할 수 있음을 보여줬다.
EmbeddingGemma 2 역시 이러한 멀티모달 표현 학습 기술의 연장선에 있다.
하지만 이번 모델은 연구 목적의 멀티모달 정렬뿐 아니라, 실제 검색 시스템이나 RAG 환경에서 사용하기 위한 경량화에 집중했다는 차이가 있다.
즉,
새로운 임베딩 원리를 발명했다기보다, 기존 멀티모달 임베딩 기술을 더 작고 실용적인 형태로 발전시킨 모델
이라고 이해하는 편이 적절하다.
6. 벤치마크 — 실제 성능은 얼마나 좋아졌을까?
Google이 공개한 모델 카드에는 텍스트, 코드, 이미지, 영상, 음성에 대한 벤치마크 결과가 포함되어 있다.
6.1 EmbeddingGemma 1과 비교
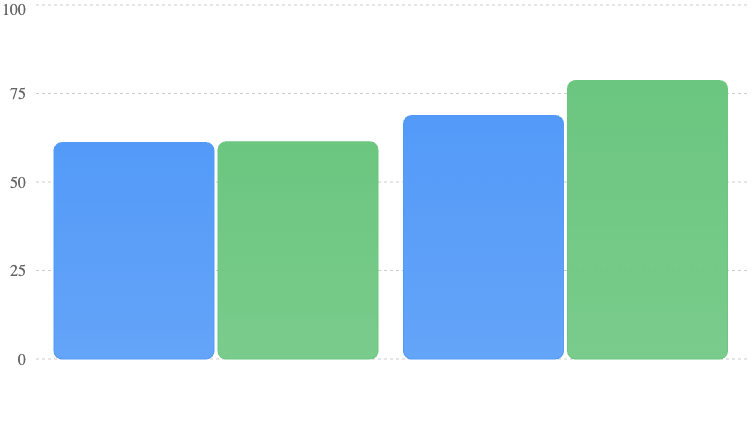
■ EmbeddingGemma 1
■ EmbeddingGemma 2
| Benchmark |
EmbeddingGemma 1 | EmbeddingGemma 2 |
| MTEB Multilingual v2 | 61.15 | 61.36 |
| MTEB Code v1 | 68.76 | 78.68 |
가장 눈에 띄는 부분은 코드 검색 성능이다.
MTEB Code 기준으로 68.76에서 78.68로 상승했으며, 기존 모델보다 약 14.4%의 상대적 개선을 보였다.
반면 다국어 텍스트 검색 성능은 거의 동일한 수준을 유지했다.
따라서 이번 버전은 텍스트 임베딩 성능 자체를 크게 향상시켰다기보다, 기존 성능을 유지하면서 코드 검색 및 멀티모달 지원을 확장한 모델이라고 볼 수 있다.
6.2 멀티모달 벤치마크
| Benchmark |
평가 분야 | 점수 |
| MIEB Lite | 이미지 임베딩 | 64.64 |
| MMEB v2 Image | 이미지 검색 | 57.28 |
| MMEB v2 Visual Document | 시각적 문서 검색 | 67.84 |
| MMEB v2 Video | 영상 검색 | 50.67 |
| MSEB Retrieval | 음성 검색 | 69.54 |
| MAEB | 오디오 임베딩 | 49.39 |
여기서 주의할 점은 각 벤치마크의 평가 데이터와 지표가 다르다는 것이다.
예를 들어 이미지 검색 점수가 57.28이고 오디오 검색 점수가 69.54라고 해서 음성 이해 성능이 이미지 이해 성능보다 뛰어나다고 해석할 수는 없다.
또한 이 수치만으로 모든 기존 멀티모달 임베딩 모델보다 우수하다고 결론 내리기도 어렵다.
이번 발표에서 중요한 것은 절대적인 최고 성능보다는 740M 이하의 모델에서 다양한 데이터 형식의 검색을 지원하면서 경쟁력 있는 성능을 보여준다는 점이다.
7. Matryoshka Representation Learning — 벡터 차원까지 줄인다
EmbeddingGemma 2는 MRL(Matryoshka Representation Learning)을 지원한다.
MRL은 벡터의 앞부분 차원만 사용하더라도 중요한 의미 정보를 최대한 유지하도록 학습하는 기술이다.
기본 임베딩 차원은 768이지만, 필요에 따라 512, 256, 128차원으로 축소할 수 있다.
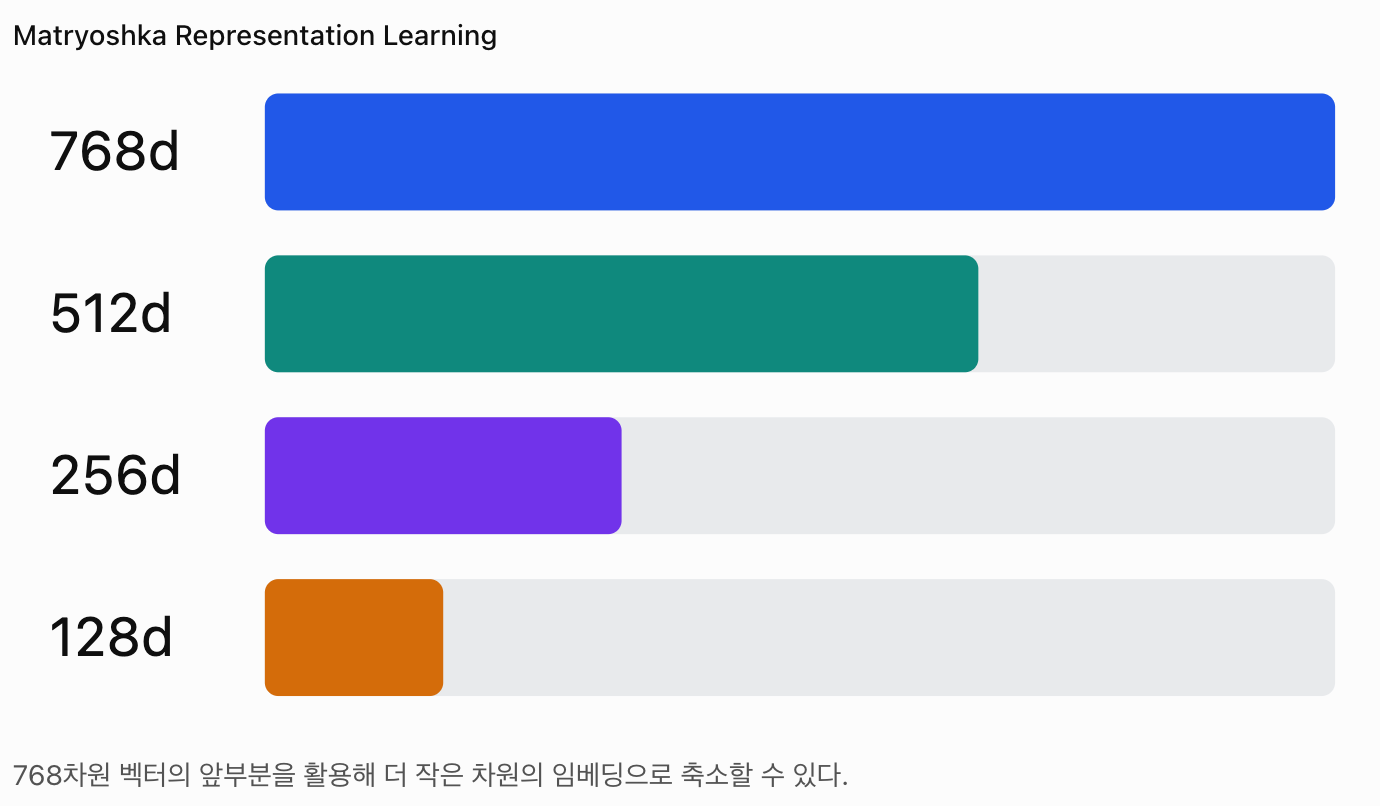
차원을 축소했을 때의 벤치마크 결과는 다음과 같다.
| 차원 |
MTEB Multilingual | MTEB Code | MIEB Lite |
| 768 | 61.36 | 78.68 | 64.64 |
| 512 | 61.17 | 77.24 | 64.32 |
| 256 | 60.41 | 76.18 | 63.13 |
| 128 | 57.89 | 71.41 | 59.06 |
256차원에서도 상당한 수준의 검색 성능을 유지한다.
이를 활용하면 Vector DB에 저장해야 하는 데이터 크기를 줄일 수 있다. 예를 들어 100만 개의 float32 벡터를 저장한다고 가정하면, 768차원에서는 순수 벡터 데이터만 약 3.07GB가 필요하다. 반면 256차원에서는 약 1.02GB로 줄어든다.
실제 DB에서는 인덱스와 메타데이터 등의 추가 저장 공간이 필요하지만, 대규모 검색 시스템에서 벡터 차원 축소는 상당한 이점이 될 수 있다. 다만 차원을 줄일수록 검색 정확도가 감소할 수 있으므로 실제 데이터에 맞춰 최적 차원을 선택해야 한다.
8. RAG에 적용하면 어떤 차이가 있을까?
개인적으로 이번 모델에서 가장 흥미로운 부분은 Multimodal RAG에 활용할 수 있다는 점이다.
기존 텍스트 기반 RAG는 일반적으로 다음과 같은 구조를 사용한다.
Document
   ↓
Chunking
   ↓
Text Embedding
   ↓
Vector DB
   ↓
Similarity Search
   ↓
LLM
   ↓
Answer
하지만 실제 기술 문서에는 텍스트뿐 아니라 이미지, 표, 그래프, 회로도 등이 함께 포함되어 있다.
이 경우 텍스트만 추출하면 중요한 정보가 검색 대상에서 누락될 수 있다.
EmbeddingGemma 2를 활용하면 이미지와 텍스트를 공통된 임베딩 공간에 저장하여 통합 검색하는 구조를 구현할 수 있다.
사용자가 다음과 같이 질문한다고 가정해 보자.
"카메라 전원 연결 방식이 나와 있는 자료를 찾아줘"
기존 텍스트 기반 RAG에서는 해당 문구가 포함된 문서 Chunk를 주로 검색한다.
반면 멀티모달 임베딩에서는 전원 연결을 보여주는 다이어그램이나 커넥터 이미지가 포함된 페이지도 검색 후보가 될 수 있다.
단, PDF나 Word 파일 자체를 별도 처리 없이 그대로 입력할 수 있는 것은 아니다. PDF의 텍스트를 추출하거나 페이지를 이미지로 변환하는 전처리가 필요하며, 긴 문서에서는 Chunking이나 페이지 단위 분할이 여전히 중요하다.
또한 EmbeddingGemma 2는 검색을 위한 모델이므로, 검색 결과를 분석해 자연어 답변을 생성하려면 별도의 LLM이 필요하다.
9. 실제 도입 시 고려해야 할 부분
이번 모델은 여러 데이터 형식을 통합 검색할 수 있다는 점에서 유용하지만, 몇 가지 한계도 있다.
첫 번째는 실제 검색 정확도다.
공식 벤치마크에서는 경쟁력 있는 성능을 보여주지만, 한국어 기술 문서나 복잡한 PDF에서도 동일한 성능이 나온다고 보장할 수는 없다.
특히 문서 내부의 작은 글씨나 표의 정확한 수치가 중요한 경우에는 OCR 및 문서 파싱을 병행하는 편이 적절하다.
두 번째는 실행 환경이다.
740M은 멀티모달 모델 중 비교적 작은 규모지만, 모든 디바이스에서 실시간으로 실행할 수 있다는 의미는 아니다.
모델 양자화 방식, 사용 가능한 메모리, CPU·GPU·NPU 성능 등에 따라 실제 추론 속도는 달라진다.
세 번째는 기존 벡터 DB와의 호환성이다.
기존에 다른 임베딩 모델로 생성한 벡터를 사용하고 있다면, EmbeddingGemma 2의 벡터와 직접 비교할 수 없다.
따라서 모델을 교체할 경우 기존 데이터를 다시 임베딩해야 할 수 있다.
마무리
EmbeddingGemma 2를 단순히 기존 EmbeddingGemma의 성능 개선 버전으로 보기에는 이번 모델의 변화가 꽤 크다.
가장 중요한 특징은
텍스트 중심의 임베딩을 이미지·영상·음성까지 확장하면서, 740M 규모의 모델로 온디바이스 환경에서도 활용할 수 있도록 설계했다는 점
이다.
실제 벤치마크에서도 다국어 텍스트 검색 성능을 유지하면서 코드 검색 성능이 개선되었고, 이미지와 음성, 영상에 대한 새로운 검색 기능도 추가되었다. 물론 이미지와 텍스트를 같은 벡터 공간으로 표현하는 기술 자체는 새로운 것이 아니다. 이미 CLIP과 ImageBind 같은 연구를 통해 가능성이 제시되었지만, 이번 발표에서 중요한 변화는 이러한 기술이 점차 작고 실용적인 모델로 발전하고 있다는 점이다.
개인적으로는 기존에 RAG와 GraphRAG 프로젝트를 진행하면서 텍스트 중심의 검색을 주로 활용했기 때문에, 이번 모델을 이용해 문서에 포함된 이미지나 그래프까지 검색 대상으로 확장해 보는 것도 흥미로울 것 같다.
특히 로컬 AI Agent나 온디바이스 RAG에서는 단순히 모델의 정확도뿐 아니라 메모리 사용량과 추론 속도도 중요한 요소다.
앞으로 임베딩 모델을 평가할 때는 텍스트 검색 정확도뿐 아니라,
얼마나 다양한 데이터를 하나의 의미 공간에 표현할 수 있는가?
그리고
이를 얼마나 적은 자원으로 실행할 수 있는가?
도 중요한 기준이 될 것으로 보인다.
참고자료
- Google 공식 발표 — EmbeddingGemma 2
https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/ - Google Developers — EmbeddingGemma 2 Developer Guide https://developers.googleblog.com/en/embeddinggemma-2-the-developer-guide/
- Google AI — EmbeddingGemma 2 Model Card https://ai.google.dev/gemma/docs/embeddinggemma/model_card_2
- Hugging Face — EmbeddingGemma 2 모델 및 사용 방법
https://huggingface.co/google/embeddinggemma-2 - OpenAI — CLIP: Connecting Text and Images
https://openai.com/index/clip/ - Meta AI — ImageBind: One Embedding Space to Bind Them All
https://imagebind.metademolab.com/ - Matryoshka Representation Learning (논문)
https://arxiv.org/abs/2205.13147
'Tech News' 카테고리의 다른 글
| Microsoft Decision-1 등장 — LLM이 모든 결정을 내릴 필요는 없다 (0) | 2026.10.14 |
|---|---|
| Gemini 4 Argon 등장 — AI 경쟁은 이제 ‘얼마나 오래 일할 수 있는가’로 넘어간다 (0) | 2026.10.06 |
| Gemini 3.8 Live 등장 — GPT-Live와 무엇이 다른가? (0) | 2026.09.16 |
| GPT-6 Astra 공개: 이제는 ‘답변하는 AI’보다 ‘직접 일하는 AI’에 가깝다 (0) | 2026.09.04 |
| Google TimesFM-3 공개: 다변량 Zero-shot Forecasting으로 확장된 시계열 Foundation Model (0) | 2026.09.02 |


