최근 AI Agent 연구는 단순히 더 뛰어난 LLM을 개발하는 것에서 벗어나, 기존 모델을 얼마나 효율적으로 활용할 수 있는지에 집중하는 추세다.
이전에 살펴본 JEV, Julia-1, Microsoft Decision-1 등이 Agent의 의사결정을 효율화하는 접근이었다면, 이번 IBM Research의 ALTK-Evolve는 조금 다른 방향을 제시한다.
바로 Agent가 과거 작업에서 겪은 성공과 실패를 학습하고, 이를 다음 작업에 활용하도록 만드는 것이다.
여기서 말하는 학습은 일반적인 Fine-tuning이나 모델 파라미터 업데이트를 의미하지 않는다. Agent의 실행 기록을 분석하고, 그 과정에서 추출한 행동 지침을 재사용하는 방식이다.
IBM은 이 접근법을 고객 서비스 Agent 벤치마크에 적용해 실제 성능 향상을 확인했다.
이번 글에서는 ALTK-Evolve가 어떤 구조로 동작하는지, 기존 RAG 및 Agent Memory와 무엇이 다른지, 그리고 실험 결과가 의미하는 바를 정리해 보려 한다.
1. 기존 LLM Agent의 문제점
일반적인 LLM Agent는 사용자 요청에 따라 필요한 도구를 호출하고, 결과를 확인하며 작업을 수행한다.
예를 들어 고객이 주문 취소를 요청하면 다음과 같은 과정이 필요하다.
- 고객 정보 확인
- 주문 내역 조회
- 취소 가능 여부 확인
- 고객에게 취소 의사 재확인
- 취소 API 실행 및 결과 안내
문제는 Agent가 이러한 절차를 항상 안정적으로 수행하지는 않는다는 점이다.
고객 확인을 누락하거나, 취소 가능 여부를 확인하지 않고 API를 호출할 수 있다. 같은 작업을 반복하더라도 성공과 실패가 달라질 수 있다.
이러한 문제를 해결하기 위해 Prompt Engineering, RAG, Fine-tuning 등의 방법을 사용할 수 있다.
하지만 각각 한계가 존재한다.
- Prompt Engineering: 필요한 업무 규칙을 사람이 직접 작성하고 유지해야 한다.
- RAG: 관련 지식을 검색할 수 있지만, 올바른 실행 절차까지 보장하지는 않는다.
- Fine-tuning: 모델의 행동을 학습시킬 수 있지만 별도의 데이터와 학습 비용이 발생한다.
IBM은 여기서 다른 질문을 던진다.
Agent가 이미 수행한 작업의 성공과 실패 기록을 활용해 스스로 행동 지침을 개선할 수는 없을까?
이 질문에서 출발한 것이 ALTK-Evolve다.
2. ALTK-Evolve란?
ALTK-Evolve는 IBM Research에서 공개한 오픈소스 Agent Memory 및 Self-Improvement 프레임워크다.
핵심 개념은 Agent의 실행 과정인 Trajectory에서 재사용 가능한 행동 규칙을 추출하는 것이다.
Trajectory는 단순한 채팅 기록이 아니라 Agent가 작업을 수행하는 전체 과정이다. 사용자 요청, 모델의 판단, Tool Call, 실행 결과 등이 포함된다.
ALTK-Evolve는 이러한 기록을 분석하여 새로운 작업에서도 활용할 수 있는 지침(Guidelines)을 생성한다.
동작 구조
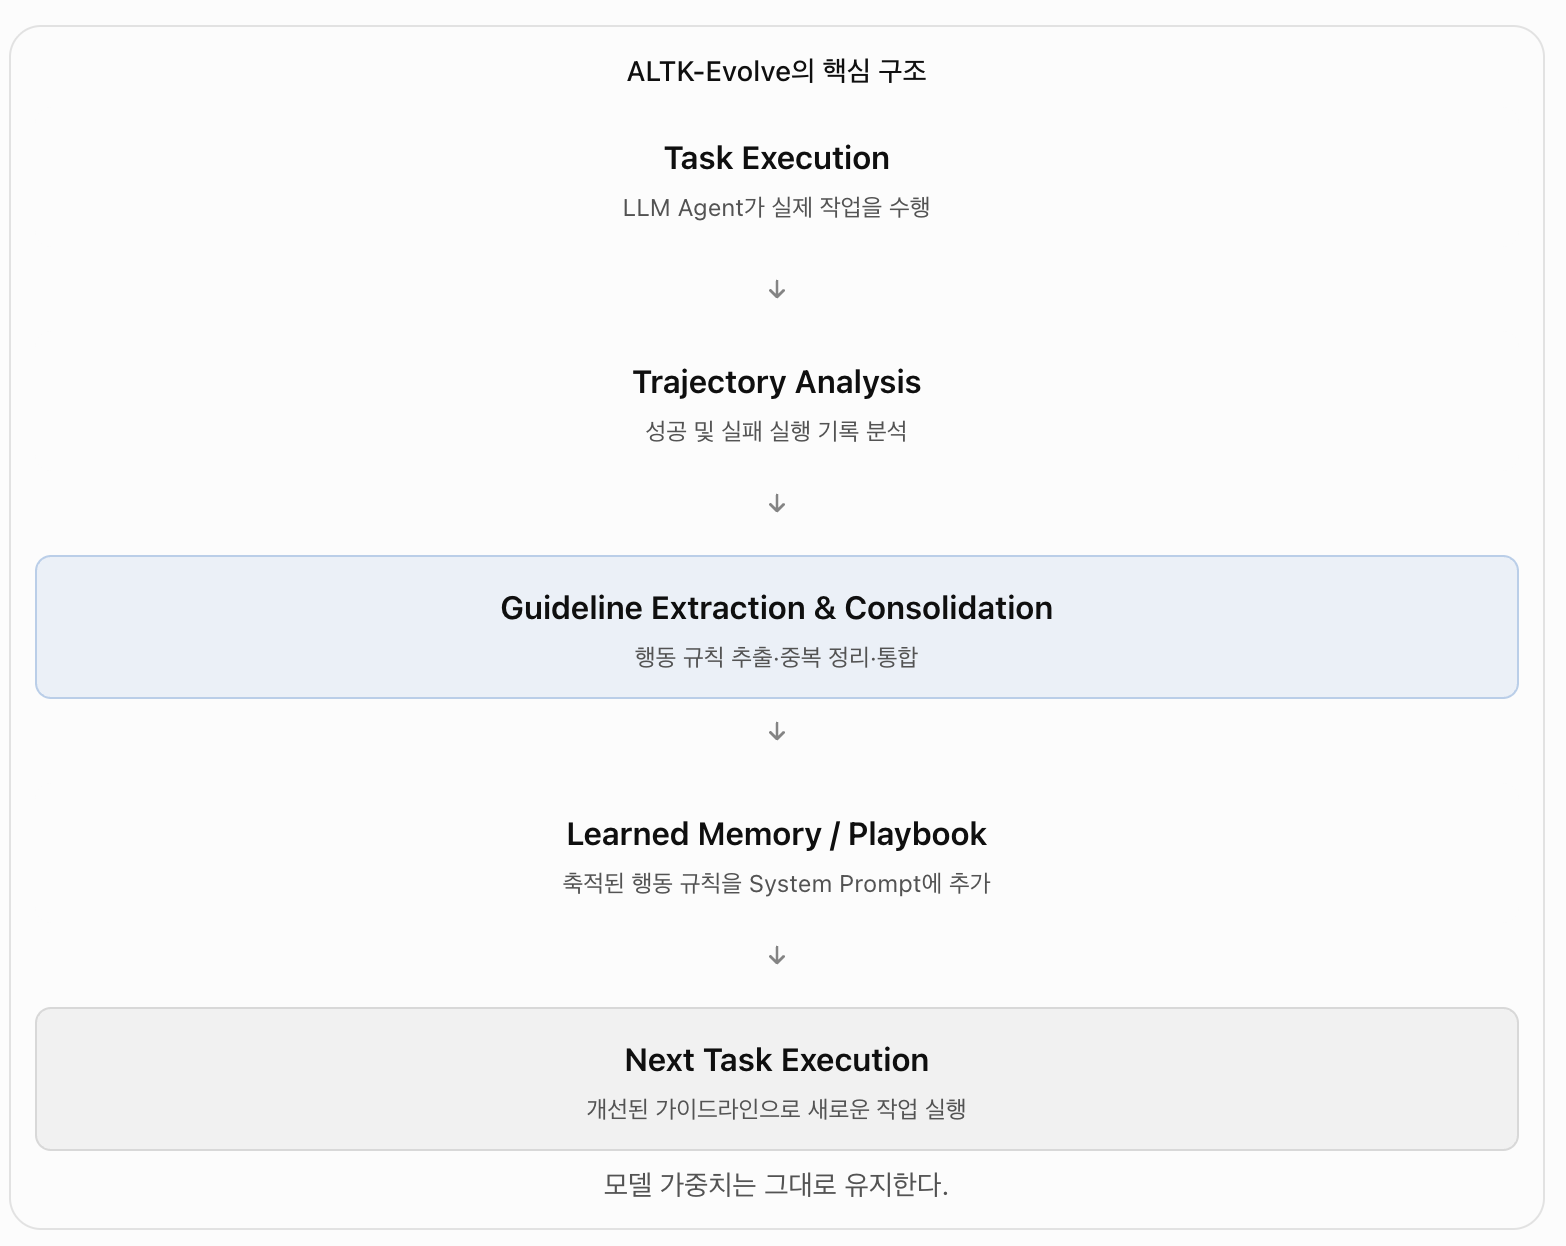
예를 들어 Agent가 환불 처리 과정에서 고객의 승인 없이 환불 API를 호출해 실패했다고 가정하자.
ALTK-Evolve는 해당 실행 기록을 분석해 다음과 같은 지침을 생성할 수 있다.
환불이나 주문 취소처럼 데이터를 변경하는 작업을 수행하기 전에는 고객의 명시적인 승인을 확인한다.
이 지침은 특정 고객에게만 적용되는 것이 아니라 이후 다른 환불 및 주문 취소 업무에서도 활용된다.
즉, 개별 실행 경험을 일반화된 업무 지식으로 변환하는 것이다.
3. 핵심 기술: 경험을 어떻게 학습하는가?
ALTK-Evolve의 핵심 과정은 크게 세 단계로 구분할 수 있다.
3.1 Trajectory 분석 및 Guideline 추출
Agent가 작업을 수행하면 실행 기록이 생성된다.
ALTK-Evolve는 LLM을 활용해 해당 기록을 분석하고, 성공에 기여했거나 실패를 방지할 수 있는 행동 지침을 추출한다.
여기서 중요한 것은 과거 실행 기록을 그대로 저장하는 것이 아니라는 점이다.
예를 들어 다음과 같은 기록이 있다고 가정하자.
실패한 실행 기록
User: 주문을 취소하고 싶습니다.

Agent: 주문 정보를 조회하겠습니다.
Tool: get_order(order_id=123)

Agent: 주문을 취소하겠습니다.
Tool: cancel_order(order_id=123)

Result: 실패
Reason: 고객 승인 확인 누락
이 기록을 통해 추출할 수 있는 지침은 다음과 같다.
Guideline:
Before executing an order cancellation,
obtain explicit confirmation from the user.
이처럼 개별 사례에서 공통적으로 적용할 수 있는 규칙을 추출한다.
3.2 Guideline 통합 및 선별
모든 실행 기록에서 규칙을 추출하면 유사하거나 중복된 지침이 쌓일 수 있다. 이를 그대로 Agent에게 전달하면 Context가 불필요하게 길어지고, 서로 충돌하는 규칙이 발생할 가능성도 있다.
ALTK-Evolve는 추출된 규칙을 통합하고 선별하는 과정을 거친다.
IBM 연구에서 사용한 개념 중 하나가 Support Count다. 이는 특정 지침이 서로 다른 학습 과제에서 몇 번 추출되었는지를 나타낸다.
예를 들어 다음과 같다.
| Guideline | Support Count |
| 작업 전 사용자 인증 확인 | 8 |
| 주문 변경 전 승인 요청 | 5 |
| API 호출 후 응답 상태 확인 | 3 |
| 특정 오류 발생 시 재시도 | 1 |
연구에서는 이러한 Support Count를 기준으로 핵심 규칙만 남기는 방법과 통합된 전체 규칙을 사용하는 방법을 비교했다.
다만 여러 번 등장한 규칙이 반드시 올바르다는 의미는 아니다. Support Count는 규칙의 반복성을 나타내는 지표다.
3.3 System Prompt에 반영
추출한 Guideline은 기존 Agent의 System Prompt에 추가된다.
System Prompt

You are a customer service agent.

Follow the company policy.

Learned Guidelines:
1. Verify customer identity before modifying orders.
2. Obtain confirmation before cancellation.
3. Validate tool responses before proceeding.
4. Explain refund details clearly.
이러한 지침을 통해 기존 Agent가 다음 작업에서 이전의 실수를 반복할 가능성을 낮추는 방식이다.
핵심은 모델의 가중치(Weights)를 변경하지 않는다는 점이다.
학습되는 대상이 모델 자체가 아니라 Agent가 참고하는 외부 실행 지침인 것이다.
4. 실제 성능은 얼마나 향상되었을까?
IBM은 고객 서비스 Agent 평가를 위한 τ²-bench(Tau-squared Bench)를 활용했다.
이 벤치마크는 Agent가 사용자와 대화하면서 실제 도구를 호출하고, 주어진 업무를 정상적으로 완료하는지 평가한다.
대표적으로 두 가지 환경이 사용되었다.
- Retail: 주문 조회, 반품, 환불 등의 고객 서비스
- Airline: 항공권 예약, 변경, 취소 등의 고객 서비스
GPT-4.1 실험 결과
| 환경 | Agent 설정 | 평균 성공률 | Pass⁴ |
| Retail | Baseline | 78.1% | 57.5% |
| Retail | ALTK-Evolve 전체 지침 | 82.5% | 67.5% |
| Airline | Baseline | 57.5% | 35.0% |
| Airline | 핵심 지침 선택 | 60.0% | 45.0% |
| Airline | 전체 지침 | 65.0% | 40.0% |
여기서 주목할 지표는 Pass⁴다.
일반적인 평균 성공률이 개별 실행의 성공 여부를 평가한다면, Pass⁴는 동일한 작업을 네 번 수행했을 때 네 번 모두 성공한 과제의 비율을 의미한다.
예를 들어 주문 취소 업무를 네 번 실행해서 세 번 성공하고 한 번 실패했다면 평균 성공률에는 성공한 세 번이 반영되지만 Pass⁴에서는 해당 과제가 실패로 처리된다.
실제 서비스 환경에서는 한 번의 성공보다 일관된 성공이 중요하므로 의미 있는 지표다.
Retail에서는 전체 지침을 추가했을 때 Pass⁴가 57.5%에서 67.5%로 10%p 향상되었다.
Airline에서는 전체 지침보다 핵심 규칙을 선별한 설정이 더 높은 Pass⁴를 기록했다.
이는 Agent에게 제공하는 규칙의 개수가 많다고 반드시 성능이 높아지는 것은 아니라는 점을 보여준다.
GPT-5.5에서도 성능이 향상될까?
IBM은 GPT-4.1뿐 아니라 더 강력한 GPT-5.5를 기반으로 추가 실험을 진행했다.
Airline 테스트에서 GPT-5.5의 Pass⁴는 기존 55%에서 70%로 향상되었다. 평균 성공률 역시 72.5%에서 82.5%로 증가했다.
즉, 성능이 높은 모델을 사용하더라도 업무별 행동 지침을 추가하면 성능을 더 개선할 여지가 있다는 것을 보여준다.
다만 평가한 과제의 규모가 비교적 작기 때문에 다양한 도메인에서도 동일한 효과가 발생하는지는 추가 검증이 필요하다.
5. 기존 RAG, Fine-tuning과 무엇이 다른가?
ALTK-Evolve를 이해할 때 가장 중요한 부분은 기존 Agent Memory나 RAG와의 차이점이다.
| 기술 | 목적 | 학습 또는 저장 대상 |
| RAG | 외부 지식 검색 | 문서 및 검색 데이터 |
| Fine-tuning | 모델 행동 및 성능 조정 | 모델 파라미터 |
| 일반 Agent Memory | 이전 대화 및 상태 기억 | 대화 기록, 사용자 정보 |
| ALTK-Evolve | 실행 경험을 활용한 성능 개선 | 행동 지침 및 절차적 지식 |
일반적인 RAG는 무엇을 알아야 하는가에 집중한다.
예를 들어 고객이 환불을 요청하면 관련 환불 정책을 검색해 제공한다.
반면 ALTK-Evolve는 어떻게 행동해야 하는가에 집중한다.
환불 정책을 확인한 뒤 어떤 순서로 도구를 호출해야 하는지, 어떤 조건에서 고객 승인을 요청해야 하는지 등을 지침으로 축적한다.
이러한 지식을 절차적 지식(Procedural Knowledge)이라고 할 수 있다.
물론 RAG와 ALTK-Evolve가 서로 배타적인 기술은 아니다.
실제 시스템에서는 RAG로 필요한 정보를 검색하고, ALTK-Evolve로 과거 경험에서 추출한 업무 지침을 제공하는 방식으로 결합할 수 있다.
6. 공개된 오픈소스와 실제 적용 방법
ALTK-Evolve는 IBM의 단일 실험에 한정된 코드가 아니라, 이전부터 개발해 온 오픈소스 Agent Memory 프로젝트다.
공식 저장소를 확인하면 2026년 3월 연구 논문, 4월 공개 발표, 이후 메모리 및 안정성 관련 연구를 거쳐 이번 고객 서비스 벤치마크까지 확장된 것을 확인할 수 있다.
주요 구성 요소에는 다음 기능이 포함된다.
-
실행 기록 저장 및 Guideline 생성
-
관련 Guideline 검색
-
중복 또는 충돌 규칙 정리
-
벡터 스토리지 연동
-
MCP 기반 Agent 통합
Claude Code, Codex와 연계할 수 있는 Lite 버전도 제공한다.
공개된 패키지는 Python 3.12 이상에서 설치할 수 있다.
pip install altk-evolve또한 MCP 서버를 실행해 Agent에 경험 기반 지침을 제공할 수 있다.
evolve-mcp --no-dashboard단, 이번 τ²-bench 연구는 학습된 Guideline을 System Prompt에 직접 추가하는 구성을 평가했다. 오픈소스의 동적 검색, MCP 연동, 벡터 메모리 기능 전체가 동일한 방식으로 벤치마크 검증을 받은 것은 아니다.
공식 저장소: AgentToolkit / altk-evolve
7. 실무 적용 시 고려할 점
ALTK-Evolve가 모든 문제를 해결하는 것은 아니다.
우선 Guideline이 증가하면 입력 Token 수도 늘어난다. IBM 실험에서 전체 지침을 적용했을 때 대화당 LLM 비용은 Retail에서 약 65%, Airline에서 약 32% 증가했다.
또한 추출한 지침이 항상 정확하거나 최신 상태를 유지하는 것도 아니다.
실제 기업 환경에서 활용하려면 다음 사항을 고려해야 한다.
- 잘못 추출된 Guideline을 검증하고 제거하는 기능
- 서로 충돌하는 규칙을 관리하는 기능
- 업무 정책이 변경되었을 때 기존 지침을 갱신하는 기능
- 필요한 규칙만 검색해 Context를 최소화하는 기능
특히 보안, 인증, 결제 등 중요한 정책은 학습된 Guideline만으로 강제해서는 안 된다. 별도의 권한 검증이나 프로그램 수준의 정책 제어가 필요하다.
8. 앞으로의 Agent 연구와 연결해서 생각해 보면
최근 살펴본 JEV, Julia-1, Decision-1은 Agent의 의사결정을 효율화하는 방향의 연구였다.
복잡한 판단을 매번 대규모 LLM이 수행하는 대신, 특정 의사결정을 작은 전용 모델에 맡기는 방식이다.
반면 ALTK-Evolve는 모델의 판단 속도를 직접 개선하기보다 Agent가 작업을 더 안정적으로 수행할 수 있도록 과거 경험을 활용하는 접근이다.
이를 조합하면 다음과 같은 구조도 생각해 볼 수 있다.
User Request
     ↓
Decision / Routing Model
     ↓
LLM Agent
     ↑
Experience-based Guidelines
(ALTK-Evolve)
     ↓
Tool Execution
     ↓
Result Evaluation
     ↓
Guideline Update
의사결정 모델이 적절한 작업을 선택하고, LLM Agent가 이를 수행하며, ALTK-Evolve가 실행 과정에서 학습한 지침을 제공하는 형태다.
실제로 이러한 통합 구조 전체를 IBM이 검증한 것은 아니지만, Agent 시스템을 효율화하기 위한 하나의 방향이 될 수 있다고 생각한다.
9. 마무리
이번 IBM의 ALTK-Evolve 연구는 새로운 LLM을 개발하거나 모델을 재학습하지 않고도 Agent 성능을 개선할 수 있다는 점에서 흥미롭다.
특히 Agent의 실행 기록을 단순한 로그로 남기는 것이 아니라, 다음 작업에서 재사용할 수 있는 행동 지침으로 변환한다는 점이 인상적이다.
기존 RAG가 외부 지식을 제공하는 데 집중했다면, ALTK-Evolve는 Agent의 실행 경험을 절차적 지식으로 축적하는 접근이라고 이해할 수 있다.
물론 평가 규모와 추가적인 Token 비용, Guideline의 정확성 및 유지보수 등의 문제가 남아 있다.
그럼에도 앞으로 Agent를 개발할 때 모델의 성능뿐 아니라, 과거 실행 경험을 어떻게 저장하고 평가하며 재활용할 것인가도 중요한 설계 요소가 될 것으로 보인다.
개인적으로도 RAG 기반 Agent나 반복적인 Tool Calling이 필요한 업무 자동화 프로젝트에 적용해 볼 만한 접근이라고 생각한다.
참고자료
'Tech Notes' 카테고리의 다른 글
| Jev 이후 등장한 Julia-1 — 거대한 LLM 대신 144M 모델이 Agent의 결정을 맡는다면 (0) | 2026.09.29 |
|---|---|
| LLM은 답을 만들고, Jev는 판단한다 — TypeSafe AI의 System One Model (0) | 2026.09.22 |
| AI는 너무 빠르게 발전하고 있는가? 다시 등장한 AI 속도 조절론 (0) | 2026.09.17 |
| Agent Lightning v1.0: 실제 AI Agent를 그대로 두고 RL로 학습시키는 방법 (0) | 2026.08.28 |
| LLM의 Router와 MoE는 어떻게 다를까? 모델 선택부터 Expert, Agent까지 (0) | 2026.08.19 |


