얼마 전 TypeSafe AI가 공개한 Jev를 정리하면서 흥미로웠던 부분은, AI 시스템에서 반드시 모든 판단을 거대한 LLM에게 맡길 필요가 있느냐는 문제였다.
LLM은 답을 만들고, Jev는 판단한다 — TypeSafe AI의 System One Model
최근 AI 모델 경쟁은 대부분 비슷한 방향으로 흘러가고 있다.더 오래 추론하고, 더 복잡한 문제를 해결하고, 여러 도구를 사용하며 긴 작업을 스스로 수행할 수 있는 Agent 능력을 높이는 것이다.Re
choiscoding.tistory.com
Jev는 일반적인 LLM처럼 문장을 길게 생성하는 대신,
주어진 상태(State)를 보고, 정해진 질문에 대해 빠르게 결정을 내리는 모델
이라는 방향을 제시했다.
그리고 Jev 공개 이후 얼마 지나지 않아 Supersonic Labs가 비슷한 문제를 훨씬 작은 규모의 오픈 모델로 접근한 Julia-1을 공개했다.
Julia-1은 약 144.3M(1억 4,430만) 파라미터의 작은 Decision Model이다. 기반 모델은 JHU CLSP의 mmBERT-small이며, Apache 2.0 라이선스로 weight와 inference 코드가 공개돼 있다.
이번 글에서는 Julia-1이 어떤 모델인지, Jev와 어떤 부분에서 연결되는지, 그리고 이런 작은 Decision Model이 Agent 시스템에서 어떤 역할을 할 수 있는지 살펴본다.
1. Julia-1은 무엇을 하는 모델인가?
Julia-1의 슬로건은 간단하다.
From context to decisions.
일반적인 LLM은 입력을 받아 새로운 텍스트를 생성한다.
User Input
    ↓
   LLM
    ↓
Reasoning / Generation
    ↓
Text Response
반면 Julia-1은 텍스트를 생성하는 모델이 아니다.
기본 구조는 다음과 같다.
State + Question + Possible Answers
              ↓
           Julia-1
              ↓
           Decision
예를 들어 고객이 다음과 같은 문의를 했다고 하자.
State:
"I was charged twice for the same order."

Question:
"Which department should handle this request?"

Options:
- Billing
- Shipping
- Account
Julia-1은 문장을 생성하는 대신 주어진 후보 중 가장 적절한 Billing을 선택한다.
즉 Julia-1의 역할은 Generation이 아니라 Decision이다. Supersonic Labs는 같은 인터페이스를 classification, routing, ordered score, Boolean decision 등에 사용할 수 있도록 설계했다.
2. 그렇다면 그냥 BERT 분류 모델 아닌가?
처음 보면 그렇게 보일 수 있다.
실제로 Julia-1은 Llama나 Qwen 같은 Decoder 기반 생성 모델이 아니라 mmBERT-small이라는 Encoder 모델을 기반으로 한다.
하지만 일반적인 BERT classification과는 중요한 차이가 있다.
전통적인 분류 모델은 보통 다음처럼 동작한다.
Text
 ↓
BERT
 ↓
Classification Head
 ↓
Class 0 / Class 1 / Class 2
예를 들어 고객 문의를 분류하도록 학습했다면 처음부터
0 = Billing
1 = Shipping
2 = Account
처럼 class가 모델의 classifier에 고정되어 있다.
새로운 카테고리를 추가하거나 전혀 다른 업무에 활용하려면 classifier를 다시 학습해야 할 가능성이 크다.
Julia는 다르다.
State
 ↓
Question
 ↓
Options
 ↓
Julia
 ↓
Best Option
Option 자체가 모델 입력으로 들어간다.
따라서 오늘은
Billing
Shipping
Account
중 하나를 선택하게 만들고,
다른 workflow에서는
Search Agent
Code Agent
Database Agent
Document Agent
를 넣어 사용할 수도 있다.
즉 Julia는 고정된 label classifier라기보다, 주어진 후보의 의미를 비교해서 decision을 내리는 작은 범용 Decision Model에 가깝다.
3. Jev와 상당히 닮아 있다
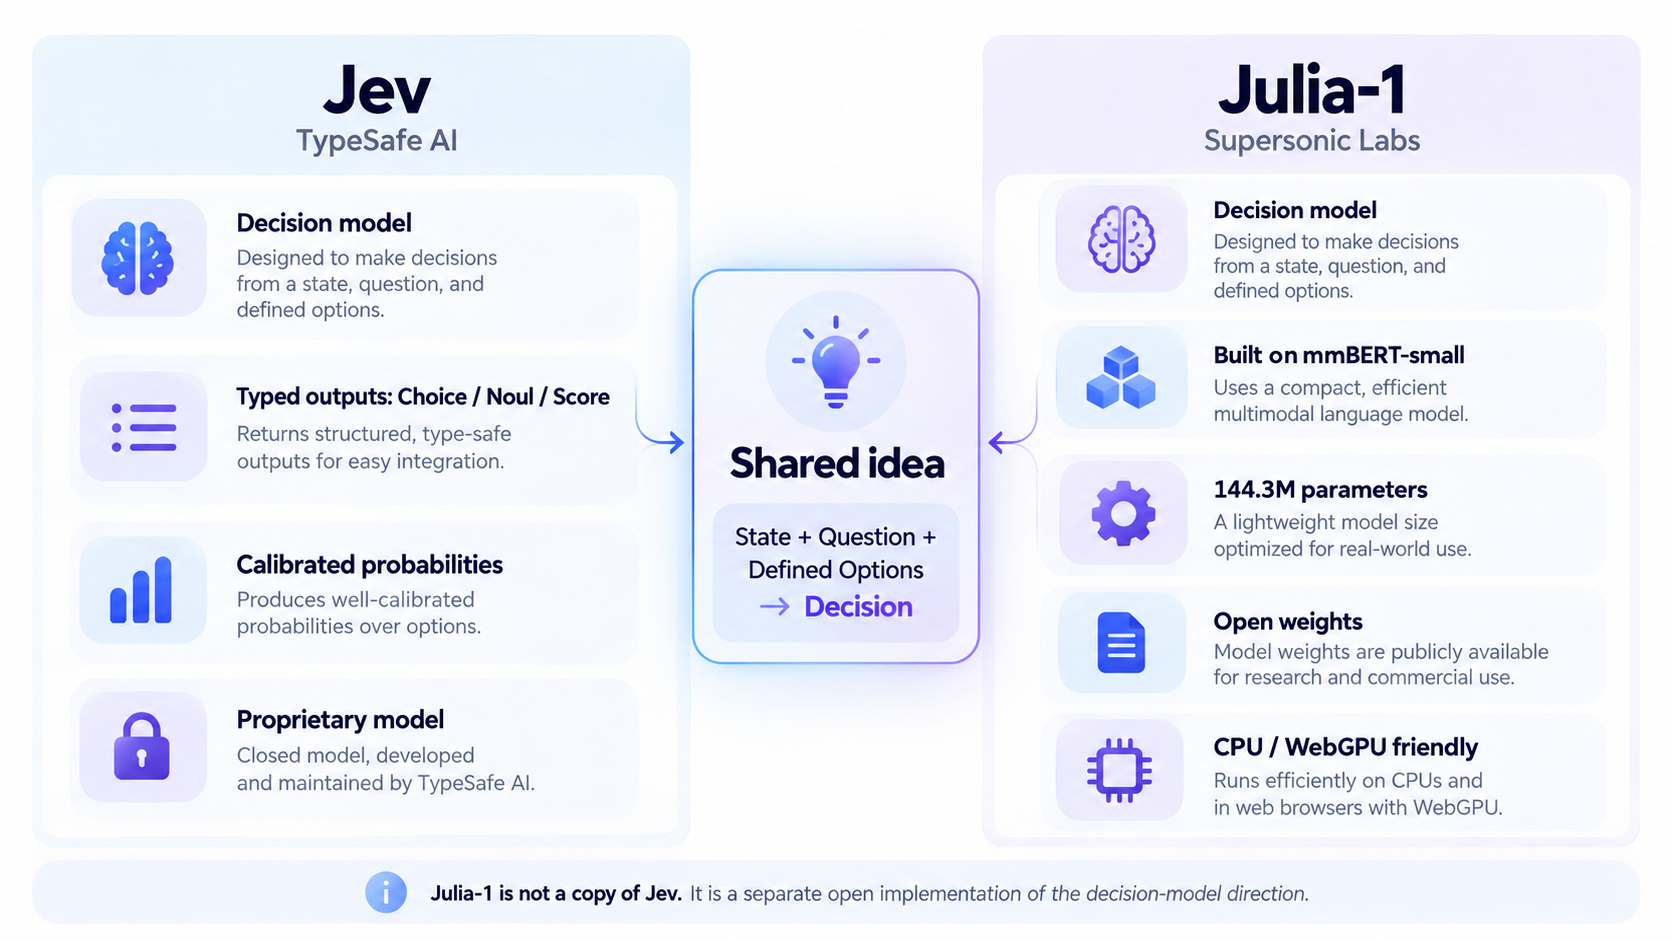
이 부분에서 Julia-1과 TypeSafe AI의 Jev가 연결된다.
Jev 역시 일반적인 LLM처럼 자유롭게 텍스트를 생성하기보다,
State + Structured Question
          ↓
         Jev
          ↓
Typed Decision + Probability
라는 구조를 갖는다.
TypeSafe는 이를 System One Model이라고 부른다.
Jev는 Choice, Noul(Boolean), Score 등의 typed decision을 반환하고, 여기에 calibrated probability를 함께 제공한다. TypeSafe는 이를 위해 RLCD(Reinforcement Learning for Calibrated Decisions)라는 별도의 학습 방식까지 제시했다.
Julia 역시 본질적인 문제 설정은 매우 비슷하다.
다만 중요한 차이가 있다.
Julia-1은 Jev를 그대로 복제한 모델은 아니다.
Jev의 architecture나 weight를 가져온 것도 아니다.
Julia는 공개된 mmBERT-small Encoder 위에 decision component를 추가하고, decision-format 데이터를 이용해 학습한 별도의 모델이다. 공개된 Julia artifact에는 학습된 weight와 inference code가 포함되지만 전체 training pipeline은 공개되지 않았다.
즉 Julia는 이렇게 보는 것이 적절하다.
Jev가 보여준 Decision Model이라는 방향을, 훨씬 작고 공개된 Encoder 모델로 구현해본 사례
4. 144M이라는 작은 크기가 중요한 이유
Julia-1의 파라미터 수는 144.3M이다.
최근 사용하는 LLM들과 비교하면 매우 작은 모델이다.
Large LLM
수십억 ~ 수천억 Parameters

        vs

Julia-1
144.3M Parameters
FP32 weight의 크기도 약 550.5 MiB 정도다.
GPU가 반드시 필요한 것도 아니며 CPU inference도 지원한다. ONNX 버전까지 공개되어 WebGPU를 이용한 브라우저 실행도 가능하다.
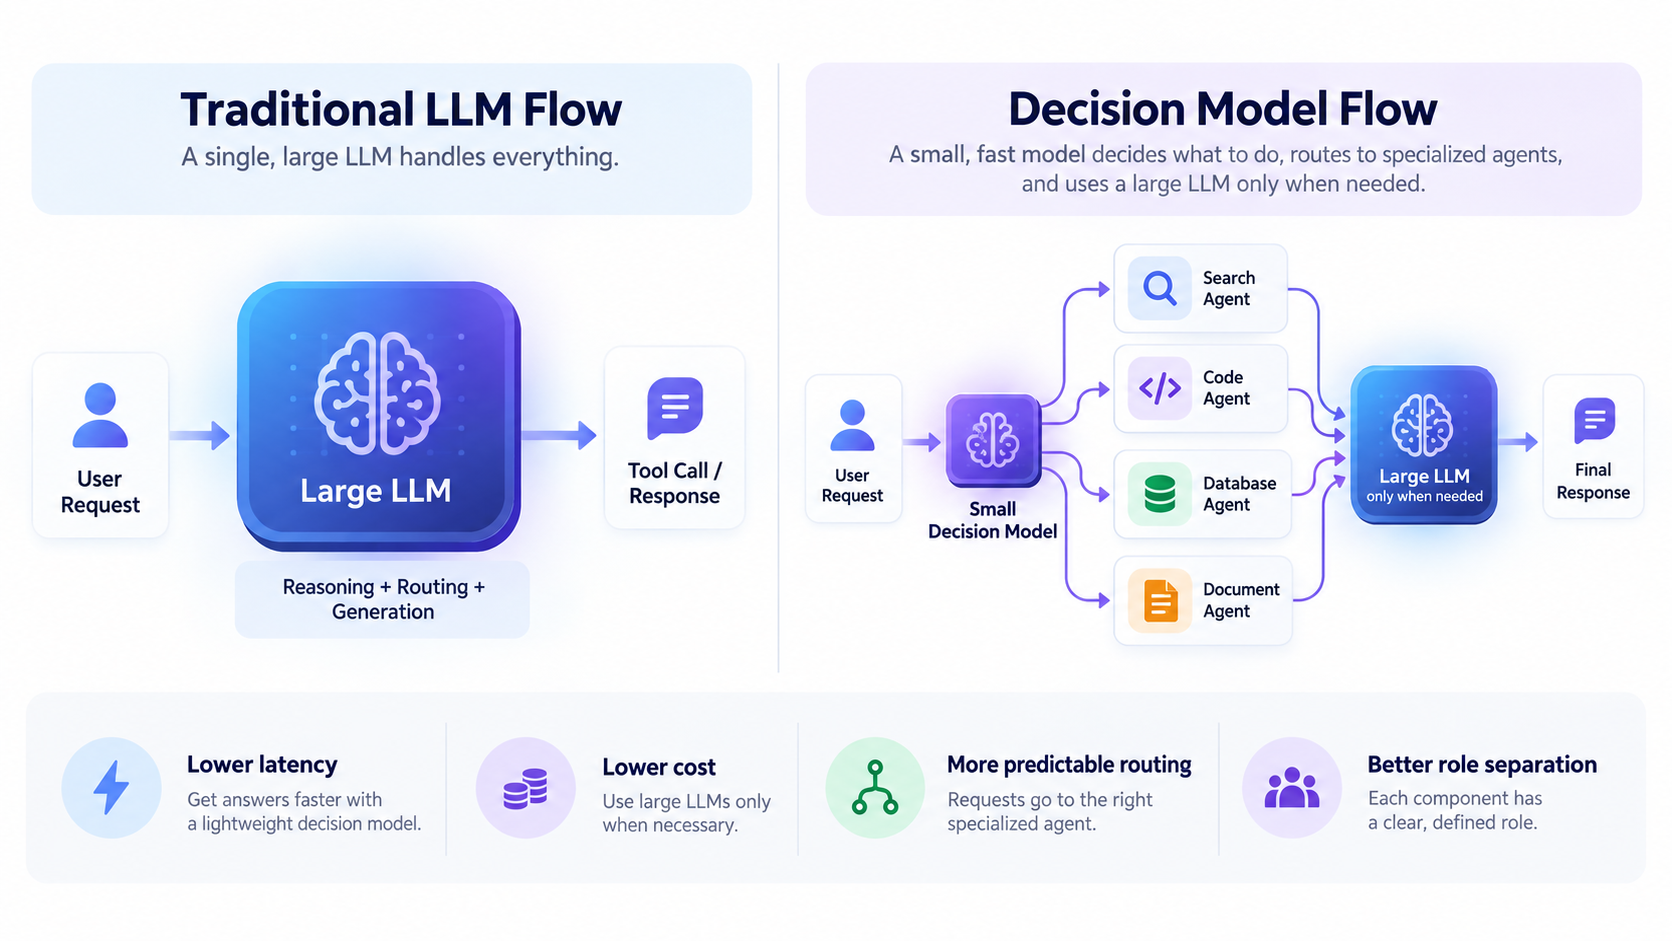
여기서 Julia의 포지션이 명확해진다. Julia는 LLM을 대체하려는 모델이 아니다. 오히려 다음처럼 사용할 수 있다.
                User Request
                      ↓
                   Julia-1
                      ↓
┌─────────────┬──────────────┬──────────────┐
 Search       Coding         Database
 Agent        Agent          Agent
어떤 Agent 또는 Tool을 호출할지만 작은 모델이 먼저 결정하고, 실제 복잡한 작업은 필요한 모델이나 Agent에게 넘긴다.
5. Agent에서 정말 모든 판단을 LLM이 해야 할까?
현재 Agent 구조를 단순하게 표현하면 흔히 다음과 같다.
User
 ↓
Large LLM
 ↓
Prompt 이해
 ↓
Tool 목록 확인
 ↓
어떤 Tool을 사용할지 reasoning
 ↓
Tool Call
 ↓
결과 확인
 ↓
다시 LLM
그런데 여기서 생각해볼 수 있는 문제가 있다.
사용자의 요청이
"지난달 매출 데이터를 SQL에서 가져와줘."
라고 들어왔다고 해보자.
이 요청에서 필요한 것이 Database Agent라는 것을 판단하는 데 정말 수십억 파라미터의 LLM이 필요할까?
일부 문제에서는 그렇지 않을 수 있다.
User Request "지난달 매출 데이터를 가져와줘"
        ↓
      Julia
        ↓
    Options
    [
        Search
        Code
        Database
        Document
    ]
        ↓
    Database
그리고 실제 SQL 생성이나 분석만 큰 모델이 담당하면 된다.
이를 구조적으로 보면 다음과 같다.
                    User
                      ↓
               Decision Model
                 (Julia-1)
                      ↓
         ┌────────────┼────────────┐
         ↓            ↓            ↓
      Search         Code       Database
       Agent         Agent        Agent
         ↓            ↓            ↓
                  Large LLM
               when necessary
즉 Reasoning과 Routing을 분리하는 구조다.
6. Julia가 받는 입력에는 중요한 제약이 있다
다만 Julia가 스스로 모든 것을 판단해주는 것은 아니다.
Julia에는 기본적으로
State
Question
Options
을 제공해야 한다.
예를 들어 다음처럼 말이다.
State:
"Find my meeting with Daniel tomorrow."

Question:
"Which tool should handle this request?"

Options:
- Search
- Calendar
- Email
- Database
그리고 Julia는 이 후보 중 하나를 선택한다.
즉,
"내 시스템에 어떤 Tool이 존재하는지도 모르겠지만 알아서 찾아서 실행해줘."
와 같은 open-ended Agent는 아니다.
Decision Space는 개발자가 어느 정도 설계해야 한다.
이 점은 Jev에서도 비슷하다. Jev 역시 structured question을 받고 typed decision을 내리는 모델이기 때문에, Decision Model 자체가 모든 workflow를 만드는 것은 아니다.
오히려 개발자가 workflow를 설계하고,
어떤 질문을 할 것인지
어떤 후보가 존재하는지
어떤 confidence에서 자동 실행할 것인지
를 정한 뒤 모델에게 그 안에서 판단을 맡긴다.
7. Julia에는 또 하나의 명확한 제약이 있다 — 최대 20개 Options
Julia-1의 native request에서는 한 번에 사용할 수 있는 option이 2~20개다.
Tool이 5개라면 문제가 없다.
Search
Code
Calendar
Email
Database
하지만 Agent가 사용할 수 있는 Tool이 100개라면 이야기가 달라진다. Julia에 100개를 한 번에 넣을 수 없다.
이 경우 구조를 나눠야 한다.
100 Tools
   ↓
1차 Candidate Retrieval
   ↓
관련 Tool 10개
   ↓
Julia-1
   ↓
최종 Tool 선택
또는 hierarchical routing을 사용할 수 있다.
                 User Request
                      ↓
            ┌─────────┼─────────┐
            ↓         ↓         ↓
        Data Tool   Web Tool   Office Tool
            ↓
        Candidate
        Selection
            ↓
        Julia-1
문제는 첫 번째 단계에서 정답 후보가 제거될 수 있다는 것이다.
Supersonic Labs 역시 grouped routing에서 narrowing 과정 중 올바른 candidate를 잃을 수 있다고 명시한다.
8. 실제 Benchmark는 어떨까?
Supersonic Labs는 Julia-1을 Jev reference와 비교했다.
2026년 9월 24일 공개된 결과는 다음과 같다.
| Benchmark | Julia-1 | Jev Reference |
| Typed Decisions | 73.15% | 72.70% |
| AG News | 94% | 91% |
| DAIR Emotion | 86% | 48% |
| Banking77 | 64% | 87% |
Typed Decision에서는 거의 비슷한 수준이다.
세부적으로는:
Choice : 71.33%
Noul   : 80.67%
Score  : 68.88%
였다.
단순 classification 성격이 강한 AG News와 Emotion에서는 Julia가 높은 결과를 보였다.
반대로 Banking77에서는 Jev reference보다 크게 낮았다.
9. Banking77 결과가 오히려 중요하다
Banking77 결과는 Julia의 구조적 한계를 잘 보여준다. Banking77 pilot에서는 72개 label을 다뤄야 한다.
하지만 Julia는 한 번에 최대 20개의 option만 처리할 수 있다. 따라서 다음과 같이 처리했다.
72 Labels
    ↓
Candidate Ranking
    ↓
Top 16
    ↓
Julia
    ↓
Final Decision
결과는:
Julia     64%
Jev       87%
즉 Decision Model을 Agent Router로 사용하려 한다면 후보가 몇 개냐가 상당히 중요해진다.
Tool이 몇 개 없는 작은 Agent라면 Julia의 구조가 잘 맞을 수 있다. 반대로 수백 개의 API와 Tool을 사용하는 대형 Agent에서는 별도의 candidate retrieval / hierarchical routing 계층이 필요할 가능성이 높다.
10. Julia는 Reasoning Model이 아니다
여기서 Julia에 대해 오해하면 안 되는 부분이 있다.
Julia는 작은 LLM이 아니다. 그리고 복잡한 reasoning을 대신하려는 모델도 아니다. Supersonic Labs 역시 Julia가 다음과 같은 능력을 보장하지 않는다고 설명한다.
- 부족한 외부 지식 추론
- Algebra 문제 풀이
- 긴 Multi-step Reasoning
- Open-ended Generation
Julia가 잘하도록 설계된 문제는 훨씬 명확하다.
현재 주어진 Context와 후보를 보고 무엇이 가장 적절한지 결정하는 것
따라서 Julia를 설명할 때 Small Language Model이라고 부르는 것보다
Small Decision Model
이라고 부르는 편이 더 정확하다.
11. Jev에서 Julia까지 — 흥미로운 변화
개인적으로 Julia-1에서 가장 흥미로운 부분은 절대적인 benchmark 점수보다 이 방향이 반복되고 있다는 것이다.
기존 AI 시스템에서는 대부분 하나의 거대한 모델에게 많은 역할을 맡겼다.
Understand
+
Reason
+
Route
+
Generate
+
Evaluate
+
Act
하지만 Jev와 Julia가 제시하는 방향은 조금 다르다.
       AI System

 ┌─────────────────┐
 │ Decision Model  │
 │ Routing / Score │
 └────────┬────────┘
          ↓
 ┌─────────────────┐
 │   Large LLM     │
 │ Deep Reasoning  │
 └────────┬────────┘
          ↓
 ┌─────────────────┐
 │ Tools / Agents  │
 └─────────────────┘
모든 문제를 하나의 모델로 해결하기보다,
판단에 특화된 작은 모델과 깊은 reasoning을 담당하는 큰 모델을 분리하는 것이다.
Jev는 이 개념을 새로운 System One Model이라는 형태로 제시했고, Julia-1은 이를 기존 Encoder 기반의 144M 모델로도 어느 정도 구현할 수 있다는 사례를 보여준다.
12. Agent 시대에는 모델 크기보다 역할 분리가 중요해질 수도 있다
최근 AI 연구에서는 더 강한 reasoning model, 더 긴 context, 더 높은 Agent benchmark 성능에 많은 관심이 집중되어 있다.
하지만 실제 Agent 시스템에서는 모델 하나의 능력만큼 각 모델에 어떤 역할을 맡길 것인지도 중요해질 수 있다.
예를 들면 다음과 같은 구조다.
User Request
      ↓
Small Decision Model
      ↓
Task Classification / Routing
      ↓
┌────────┬────────┬────────┐
Search   Code     Document
 Agent   Agent      Agent
      ↓
Large Reasoning Model
      ↓
Final Result
모든 요청을 처음부터 큰 LLM에게 보내지 않는다면,
- Latency 감소
- GPU 비용 감소
- Local / Edge 처리 가능
- Router 동작 예측 가능성 증가
- Agent architecture의 역할 분리
같은 장점을 기대할 수 있다.
물론 Julia-1 하나만으로 대형 Agent Router를 완성할 수 있는 것은 아니다. 20개 option 제한과 candidate narrowing 문제, 도메인별 성능 편차 등이 분명히 존재한다.
그럼에도 Julia-1은 중요한 질문을 던진다.
Agent의 모든 판단에 정말 거대한 LLM이 필요한가?
Jev가 이 질문을 새로운 모델 architecture와 RLCD라는 방식으로 던졌다면,
Julia-1은 훨씬 현실적인 형태로 다시 묻는다.
이미 존재하는 140M급 Encoder를 잘 학습시키는 것만으로도 상당수의 Agent Decision을 처리할 수 있지 않을까?
마무리
Julia-1은 새로운 최강 LLM이 아니다.
오히려 그 반대에 가까운 모델이다. 텍스트 생성과 복잡한 reasoning을 포기하고, 특정한 decision 문제에 집중한 144M 규모의 작은 모델이다. 그리고 이 점 때문에 Julia-1은 Jev 이후의 흐름에서 꽤 흥미로운 모델이다.
Jev
→ Decision Model이라는 새로운 방향 제시
→ Typed Decision + Calibrated Probability

        ↓

Julia-1
→ 공개 Encoder 기반으로 같은 문제에 접근
→ 144M Parameters
→ Open Weights
→ CPU / WebGPU 실행 가능
Jev가 “LLM이 아닌 Decision Model”이라는 개념을 보여줬다면, Julia-1은 그 아이디어가 반드시 거대한 proprietary model이어야 할 필요는 없다는 가능성을 보여준다.
앞으로 Agent가 수많은 Tool과 모델을 조합하는 방향으로 발전한다면, 더 큰 하나의 모델을 만드는 것뿐 아니라, 작은 모델들이 각자 잘하는 판단을 맡는 architecture 역시 중요한 연구 방향이 될 수 있다.
Julia-1은 그 가능성을 보여주는 꽤 흥미로운 첫 사례다.
참고자료
- Supersonic Labs — Julia-1
https://huggingface.co/SupersonicLabs/Julia-1 - Supersonic Labs — Julia-1 ONNX / WebGPU
https://huggingface.co/SupersonicLabs/Julia-1-ONNX - TypeSafe AI — Introducing System One Models & Jev
https://typesafe.ai/blog/introducing-system-one-models-and-jev - TypeSafe AI
https://typesafe.ai/
'Tech Notes' 카테고리의 다른 글
| IBM ALTK-Evolve 분석 — LLM을 재학습하지 않고 Agent 성능을 높이는 방법 (0) | 2026.10.21 |
|---|---|
| LLM은 답을 만들고, Jev는 판단한다 — TypeSafe AI의 System One Model (0) | 2026.09.22 |
| AI는 너무 빠르게 발전하고 있는가? 다시 등장한 AI 속도 조절론 (0) | 2026.09.17 |
| Agent Lightning v1.0: 실제 AI Agent를 그대로 두고 RL로 학습시키는 방법 (0) | 2026.08.28 |
| LLM의 Router와 MoE는 어떻게 다를까? 모델 선택부터 Expert, Agent까지 (0) | 2026.08.19 |


