최근 LLM을 살펴보다 보면 Router, MoE(Mixture of Experts), Expert, Agent 같은 용어가 자주 등장한다.
특히 Router와 MoE는 모두 입력에 따라 무언가를 선택한다는 점 때문에 비슷해 보이지만, 실제로는 동작하는 위치와 선택하는 대상이 완전히 다르다.
간단하게 먼저 정리하면 다음과 같다.
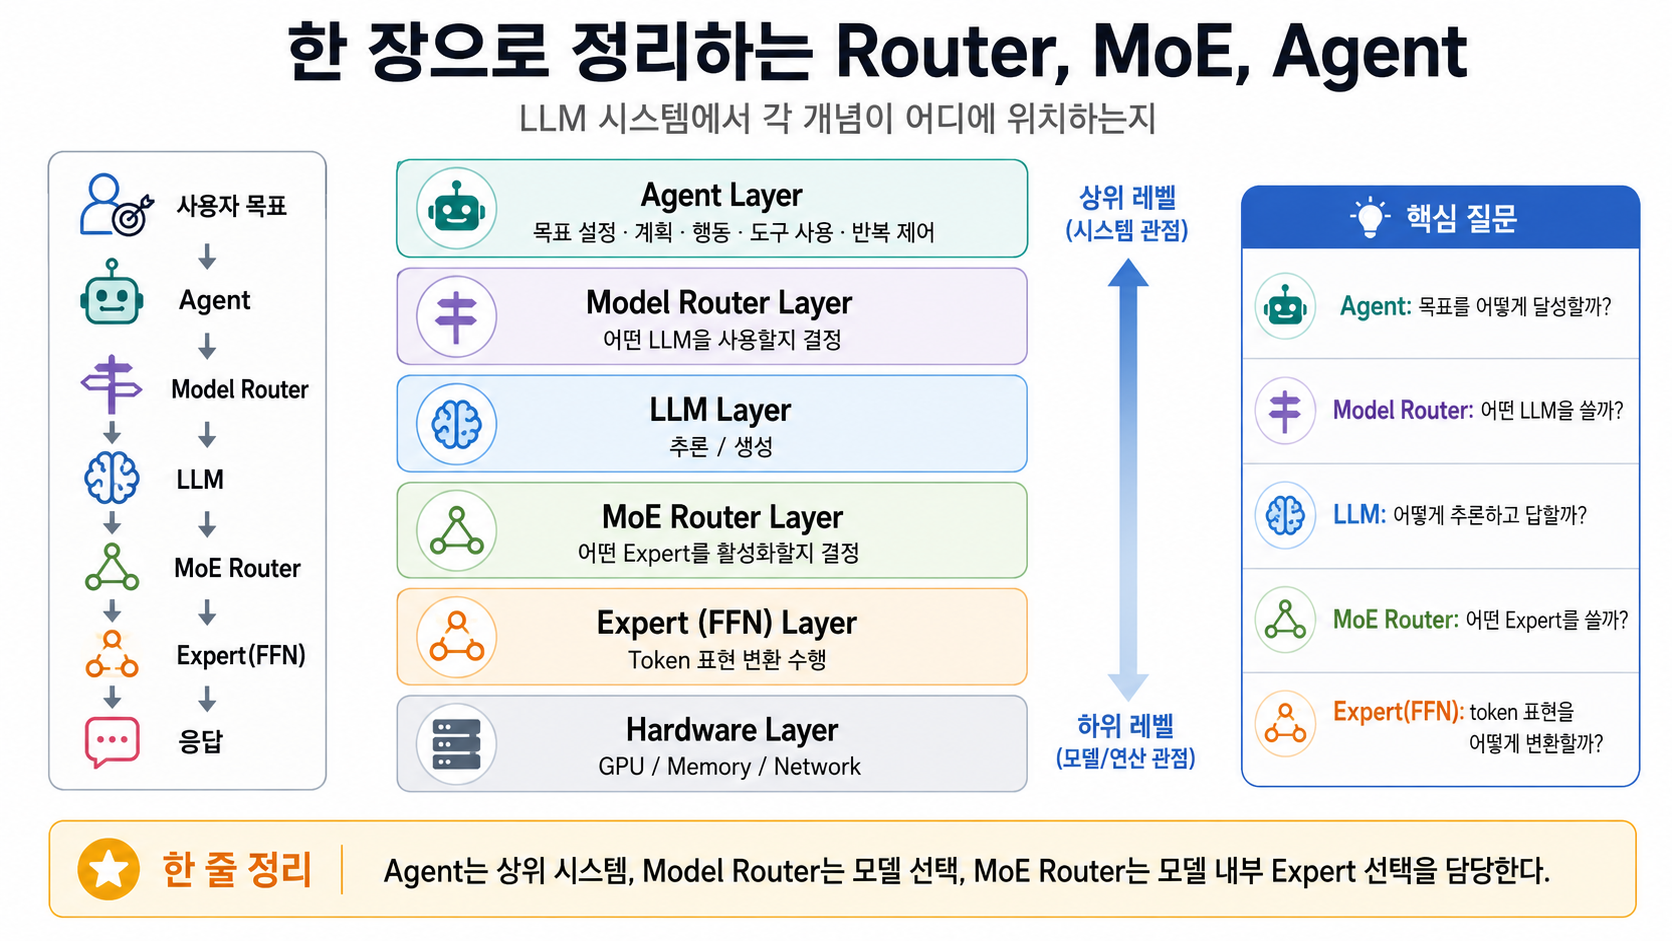
Model Router는 어떤 LLM을 사용할지 선택하고, MoE Router는 하나의 LLM 내부에서 어떤 Expert를 활성화할지 선택한다.그리고 Agent는 이러한 모델과 Router, Tool 등을 활용해 하나의 목표를 수행하는 더 상위의 시스템 구조라고 볼 수 있다.
1. Model Router — 어떤 LLM을 사용할 것인가?
LLM Router 또는 Model Router는 사용자 요청이 들어왔을 때 어떤 모델이 해당 요청을 처리할지 결정하는 구조다.
예를 들어 서비스에 다음과 같은 모델들이 있다고 가정해보자.
User Query
    ↓
Model Router
    │
    ├─ 간단한 질문 → Small LLM
    │
    ├─ 코딩       → Code LLM
    │
    └─ 복잡한 추론 → Reasoning LLM
사용자가
"Python에서 heap을 구현하는 방법을 알려줘"
라고 질문하면 Router가 이를 코딩 관련 요청으로 판단하고 Code LLM으로 전달하는 식이다.
Router는 반드시 또 다른 LLM일 필요는 없다.
- Rule-based
- Keyword / Regex
- Embedding Similarity
- Classification Model
- Small LLM
등 다양한 방법으로 구현할 수 있다.
최근 연구에서는 단순히 질문의 종류만 분류하는 것을 넘어 응답 품질과 비용을 함께 고려해 강한 모델과 저렴한 모델 중 하나를 선택하는 방식도 연구되고 있다. RouteLLM은 이러한 방식으로 strong/weak LLM 사이의 routing을 학습하는 대표적인 연구다.
즉 Model Router의 핵심 질문은 다음과 같다.
"이 요청을 어느 LLM에게 맡기는 것이 가장 좋은가?"
2. MoE — 하나의 모델 안에서 필요한 부분만 사용하기
MoE는 Mixture of Experts의 약자로, 여러 Expert를 하나의 모델 안에 두고 입력에 따라 일부 Expert만 활성화하는 모델 구조다.
여기서 중요한 것은 Expert가 일반적으로 독립적인 LLM 하나를 의미하지 않는다는 점이다.
Transformer 구조를 매우 단순화하면 다음과 같다.
Token
  ↓
Self-Attention
  ↓
FFN
  ↓
다음 Layer
MoE 모델에서는 이 FFN 부분을 여러 개의 Expert로 확장하는 방식이 일반적이다.
Token
  ↓
Self-Attention
  ↓
MoE Router
  │
  ├─ Expert 1 (FFN)
  ├─ Expert 2 (FFN)
  ├─ Expert 3 (FFN)
  ├─ ...
  └─ Expert N (FFN)
        ↓
     다음 Layer
Switch Transformer나 Mixtral과 같은 대표적인 MoE 연구에서도 Transformer 내부의 feed-forward 영역을 여러 Expert로 구성하고 Router가 일부 Expert를 선택하는 구조를 사용한다.
3. 여기서 FFN은 무엇인가?
FFN은 Feed-Forward Network의 약자다.
Transformer에서는 Self-Attention이 "현재 token이 다른 token들과 어떤 관계가 있는가?" 를 계산하는 역할을 한다면, FFN은 Attention을 거친 각 token의 표현을 비선형 변환하여 더 풍부한 feature representation으로 만드는 부분이라고 이해하면 된다.
단순하게 표현하면:
Token
  ↓
Attention
"다른 Token과의 관계 계산"
  ↓
FFN
"Token 표현을 변환"
  ↓
다음 Layer
일반적인 FFN은 내부적으로 대략 다음과 같은 형태의 신경망 연산을 수행한다.
Input
  ↓
Linear
  ↓
Activation
  ↓
Linear
  ↓
Output
LLM에는 이러한 FFN이 Transformer Layer마다 반복적으로 존재한다.
MoE는 이 FFN을 하나만 사용하는 대신:
기존 Transformer

Attention
   ↓
  FFN
다음처럼 여러 개로 늘린다고 생각하면 이해하기 쉽다.
MoE Transformer

Attention
   ↓
 Router
   ↓
┌──┼──┬──┐
E1 E2 E3 E4
그리고 각 E1, E2 등이 각각 하나의 Expert FFN이다.
4. MoE Router는 어떻게 Expert를 선택할까?
예를 들어 Expert가 8개 있다고 하자.
특정 token의 hidden state가 들어오면 Router가 각 Expert에 점수를 계산한다.
Expert 1 → 0.03
Expert 2 → 0.10
Expert 3 → 0.55
Expert 4 → 0.04
Expert 5 → 0.02
Expert 6 → 0.21
Expert 7 → 0.03
Expert 8 → 0.02
만약 Top-2 Routing을 사용한다면 가장 높은 점수를 받은
Expert 3
Expert 6
만 계산에 사용한다.
Mixtral 8x7B가 대표적인 예다. 각 layer에 8개의 feed-forward Expert를 두고, 각 token마다 Router가 2개의 Expert를 선택한다.
이를 Sparse Activation이라고 한다.
전체 Expert

E1 E2 E3 E4 E5 E6 E7 E8
      ↑        ↑
      └─ Top-2 ┘

실제로는 일부 Expert만 활성화
MoE가 주목받는 가장 큰 이유 중 하나가 바로 여기에 있다.
모델 전체에는 매우 많은 파라미터를 가지고 있으면서도 각 token을 처리할 때는 일부 파라미터만 활성화해 계산량을 관리할 수 있기 때문이다. Switch Transformer 역시 이러한 sparse activation을 이용해 모델 capacity를 크게 확장하는 방법을 제시했다.
5. Expert는 수학, 코딩처럼 사람이 나눠서 학습시키는가?
여기서 Expert라는 이름 때문에 다음과 같이 생각하기 쉽다.
Expert 1 = 수학 전문가
Expert 2 = 코딩 전문가
Expert 3 = 영어 전문가
Expert 4 = 일상 대화 전문가
하지만 일반적인 MoE 학습은 이렇게 명시적으로 역할을 지정하지 않는다.
대신:
수학 데이터
코드 데이터
자연어 데이터
과학 데이터
대화 데이터
...
      ↓
하나의 Training Dataset
      ↓
       MoE
        │
      Router
   ↙    ↓    ↘
  E1    E2    E3 ...
와 같이 모델 전체를 학습하면서 Router와 Expert도 함께 학습된다.
그 과정에서 특정 Expert가 특정 패턴이나 representation에 더 전문화되는 현상이 나타날 수 있다.
따라서 실제로는:
Expert 1 = 수학
Expert 2 = 코딩
처럼 깔끔하게 나뉜다고 보기는 어렵다.
특정 Expert가 숫자, 특정 언어, 코드 syntax 또는 특정 의미 패턴 등에 상대적으로 많이 활성화될 수 있으며, 하나의 token 역시 layer에 따라 서로 다른 Expert를 거칠 수 있다.
6. Model Router와 MoE의 가장 큰 차이
두 방식을 나란히 놓으면 차이가 명확하다.
Model Router
User Query
    ↓
Model Router
    ↓
어떤 LLM?
    ↓
Code LLM
MoE
User Query
    ↓
하나의 MoE LLM
    ↓
Transformer
    ↓
MoE Router
    ↓
어떤 Expert?
    ↓
Expert 3 + Expert 6
정리하면 다음과 같다.
| 구분 | Model Router | MoE |
| 적용 위치 | LLM 외부 | LLM 내부 |
| 계층 | Application / Serving | Model Architecture |
| 선택 대상 | LLM | Expert FFN |
| 선택 단위 | 주로 Request | 주로 Token |
| 모델 변경 | 가능 | 같은 모델 유지 |
| 학습 | 별도 Router 구성 가능 | Router와 Expert 공동 학습 |
| 주요 목적 | 비용·성능·Latency 최적화 | 모델 Capacity 대비 계산 효율 |
| 질문 | 어떤 모델을 사용할까? | 어떤 Expert를 사용할까? |
LLM Router에 관한 연구들은 실제로 모델별 품질과 비용을 고려해 요청에 적절한 모델을 할당하는 문제로 접근한다.
7. 두 기술은 동시에 사용할 수도 있다
Router와 MoE는 서로 대체하는 기술이 아니다.
실제로는 다음과 같이 같이 사용할 수 있다.
                 User
                   ↓
             Model Router
          ┌────────┼────────┐
          ↓        ↓        ↓
      Small LLM Code LLM Large LLM
                             ↓
                          MoE Model
                             ↓
                         MoE Router
                       ↙    ↓    ↘
                      E2    E7    E15
가장 위의 Model Router에서는
"어떤 LLM을 사용할 것인가?"
를 결정한다. 그리고 선택된 모델이 MoE 구조라면 모델 내부에서 다시
"현재 token을 어떤 Expert가 처리할 것인가?"
를 결정한다. 따라서 둘 다 Router라는 단어를 사용하지만 완전히 다른 레벨에서 동작하는 routing이다.
8. 그렇다면 Agent는 어디에 위치할까?
최근 자주 등장하는 AI Agent는 이보다 더 높은 시스템 레벨에서 이해하면 쉽다.
Agent는 단순히 적절한 모델을 선택하는 것을 넘어, 주어진 목표를 수행하기 위해 추론하고, 행동하고, 결과를 확인한 뒤 다시 다음 행동을 결정하는 시스템이다. 대표적인 ReAct 연구에서도 LLM의 Reasoning과 외부 환경에 대한 Acting을 번갈아 수행하는 구조를 제시했다.
예를 들어:
사용자 목표
    ↓
  Agent
    ↓
계획 수립
    ↓
Model Router
    ↓
적절한 LLM
    ↓
Tool 실행
    ↓
결과 확인
    ↓
다시 판단
    ↓
다음 Action
Agent 내부에는 필요에 따라 여러 구성요소가 들어갈 수 있다.
                     Agent
                       │
          ┌────────────┼────────────┐
          ↓            ↓            ↓
       Planning    Model Router    Tools
                       │
                       ↓
                      LLM
                       │
                  MoE 모델이라면
                       ↓
                   MoE Router
                       ↓
                    Experts
Anthropic 역시 agentic system의 기본 구성 요소를 LLM에 retrieval, tool, memory 등의 기능을 추가한 형태로 설명한다.
따라서 실무적인 시스템 계층으로 보면 다음처럼 정리할 수 있다.
────────────────────────────
Agent
Planning / Action / Tool / Loop
────────────────────────────
Model Router
어떤 LLM을 사용할 것인가?
────────────────────────────
LLM
Transformer / Reasoning
────────────────────────────
MoE Router
어떤 Expert를 사용할 것인가?
────────────────────────────
Expert FFN
실제 Token Representation 변환
────────────────────────────
Agent가 반드시 Model Router나 MoE를 포함해야 하는 것은 아니다. 다만 Agent는 모델 선택, reasoning, tool 사용 등을 조합하여 하나의 목표를 수행하는 시스템 레벨의 개념이기 때문에, 아키텍처 관점에서는 Router나 MoE보다 상위 계층으로 이해하면 편하다.
정리
처음에는 Router와 MoE 모두 "입력에 따라 무언가를 선택한다"는 점에서 비슷해 보이지만 선택 대상이 다르다.
- Model Router: 사용자 요청에 따라 어떤 LLM을 사용할지 선택
- MoE: 하나의 LLM 내부에서 token마다 어떤 Expert FFN을 사용할지 선택
- FFN Transformer 내부에서 각 token의 표현을 변환하는 Feed-Forward Network. MoE에서는 이 FFN을 여러 Expert로 구성한다.
- Agent: Router, LLM, Tool 등을 활용하면서 목표를 달성하기 위해 판단과 행동을 반복하는 상위 시스템
참고자료
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
https://arxiv.org/abs/2101.03961 - Mixtral of Experts
https://arxiv.org/abs/2401.04088 - RouteLLM: Learning to Route LLMs with Preference Data
https://arxiv.org/abs/2406.18665 - Hybrid LLM: Cost-Efficient and Quality-Aware Query Routing
https://arxiv.org/abs/2404.14618 - ReAct: Synergizing Reasoning and Acting in Language Models
https://arxiv.org/abs/2210.03629 - Anthropic – Building Effective AI Agents
https://www.anthropic.com/engineering/building-effective-agents
'Tech Notes' 카테고리의 다른 글
| AI는 너무 빠르게 발전하고 있는가? 다시 등장한 AI 속도 조절론 (0) | 2026.09.17 |
|---|---|
| Agent Lightning v1.0: 실제 AI Agent를 그대로 두고 RL로 학습시키는 방법 (0) | 2026.08.28 |
| inclusionAI, Ling-3.0-flash 공개: 효율성과 에이전트 성능을 함께 노린 대형 언어 모델 (0) | 2026.08.05 |
| GPT-Live의 실제 구조가 공개됐다: 예상과 달랐던 핵심 설계 (0) | 2026.08.04 |
| Qwen3.8-Max 공개: 16일 동안 코딩하는 2.4조 파라미터 AI 모델 (0) | 2026.08.03 |


