Ant Group의 AGI 연구 조직 inclusionAI가 새로운 오픈웨이트 언어 모델 Ling-3.0-flash를 공개했다.
https://huggingface.co/inclusionAI/Ling-3.0-flash
inclusionAI/Ling-3.0-flash · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co
Ling-3.0-flash는 총 1,240억 개의 파라미터를 가진 대형 모델이지만, 토큰을 처리할 때 실제로 활성화되는 파라미터는 51억 개에 불과하다. 모델의 전체 규모는 유지하면서 실제 연산량을 줄이는 희소 MoE 구조를 적용한 것이다.
이번 모델은 단순히 빠른 대화형 모델을 목표로 하지 않는다. 수학과 코딩 같은 추론 작업부터 도구 호출, 소프트웨어 수정, 검색, Deep Research까지 하나의 모델에서 처리하는 에이전트용 언어 모델을 지향한다.
inclusionAI?
inclusionAI는 중국의 핀테크 기업 Ant Group이 운영하는 AGI 연구 및 오픈소스 조직이다.
Ant Group은 알리페이를 운영하는 기업으로 잘 알려져 있다. inclusionAI는 대규모 언어 모델뿐 아니라 강화학습, 모델 학습 및 추론 시스템, 멀티모달 AI와 에이전트 프레임워크 등을 오픈소스로 공개하고 있다. inclusionAI가 공개하는 대표적인 모델 제품군은 다음과 같이 구분된다.
- Ling: 범용 언어 모델
- Ring: 추론에 초점을 맞춘 모델
- Ming: 이미지·영상·음성까지 처리하는 멀티모달 모델
Ling-3.0-flash는 이 가운데 범용 언어 모델인 Ling 시리즈의 새로운 세대에 해당한다.
Ling-3.0-flash의 기본 사양
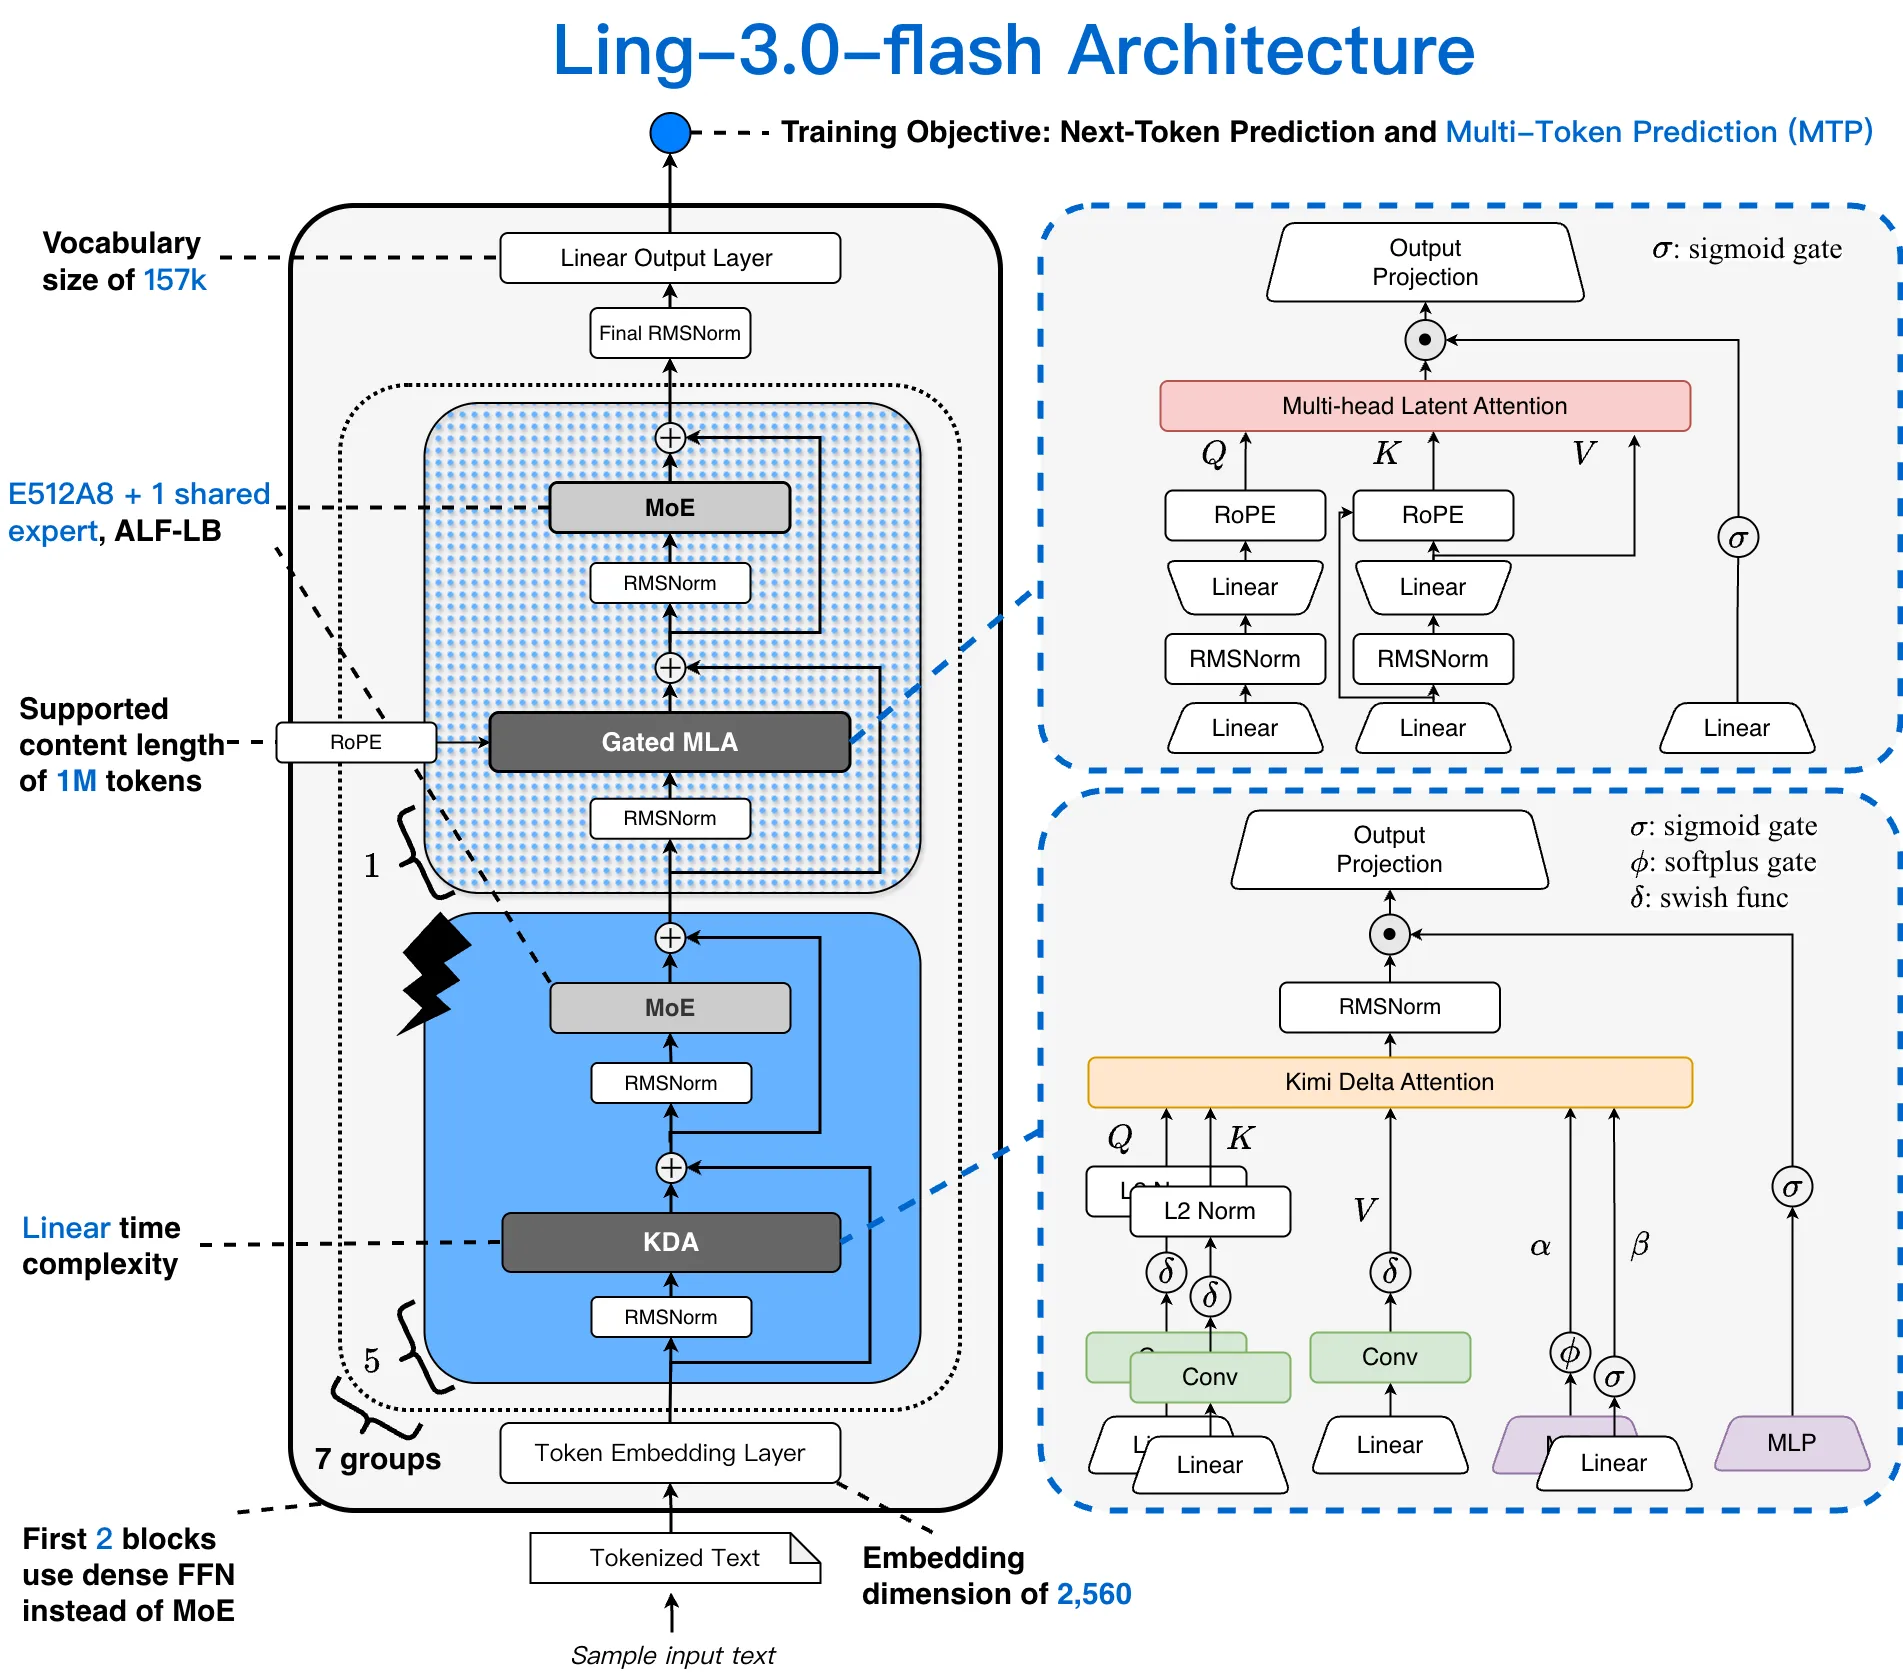
Ling-3.0-flash는 Hybrid-linear MoE 아키텍처를 사용한다.
| 항목 | Ling-3.0-flash |
| 전체 파라미터 | 124B |
| 활성 파라미터 | 5.1B |
| Transformer Layer | 42개 |
| KDA Layer | 35개 |
| Gated MLA Layer | 7개 |
| Routed Expert | 512개 |
| 토큰당 활성 Expert | 8개 |
| Shared Expert | 1개 |
| Hidden Size | 2,560 |
| 학습 컨텍스트 길이 | 8K → 32K → 256K |
| 라이선스 | MIT |
모델의 전체 파라미터는 124B지만, 각각의 토큰을 처리할 때는 512개의 routed expert 가운데 8개만 선택된다. 이를 통해 토큰당 활성 파라미터를 5.1B 수준으로 낮췄다.
124B인데 왜 5.1B만 사용하는가
Ling-3.0-flash에는 MoE, Mixture of Experts 구조가 적용됐다.
MoE는 하나의 거대한 모델 내부에 여러 개의 전문가 네트워크를 배치하고, 입력에 따라 필요한 전문가만 선택해 사용하는 방식이다.
일반적인 Dense 모델은 토큰 하나를 처리할 때 대부분의 파라미터를 사용한다. 반면 MoE 모델은 입력 토큰의 특성에 맞는 일부 expert만 활성화한다.
Ling-3.0-flash에는 총 512개의 routed expert가 있지만, 토큰당 활성화되는 expert는 8개다.
512개 Expert 중 8개 활성화
→ 1/64 Sparse MoE
코드와 관련된 입력에는 코드 처리에 강한 expert 조합이, 수학 문제에는 수학 추론에 적합한 expert 조합이 선택되는 방식으로 이해할 수 있다. 이 구조의 장점은 모델이 많은 지식을 담을 수 있는 전체 용량을 유지하면서도, 실제 토큰 처리에 필요한 연산량을 줄일 수 있다는 점이다.
다만 활성 파라미터가 5.1B라는 이유로 일반적인 5B 모델처럼 가볍게 실행할 수 있는 것은 아니다.
추론 과정에서 일부 expert만 계산하더라도, 기본적으로 124B 전체 가중치를 메모리에 저장해야 한다. 따라서 Ling-3.0-flash는 노트북이나 단일 소비자용 GPU보다 다중 GPU 서버 환경에 적합한 모델이다.
KDA와 MLA를 결합한 하이브리드 어텐션
Ling-3.0-flash의 또 다른 핵심은 Hybrid-Linear Attention이다.
모델은 다음 두 종류의 레이어를 5대 1 비율로 교차 배치한다.
- KDA Layer 35개
- Gated MLA Layer 7개
KDA(Kimi Delta Attention)란 무엇인가
기존 Self-Attention은 모든 토큰 간 관계를 계산하기 때문에 입력 길이가 길어질수록 연산량과 메모리 사용량이 크게 증가한다.
KDA는 과거 문맥을 압축된 상태로 누적해 처리하는 선형 어텐션 계열의 기술이다. 긴 문서를 처리할 때 일반적인 어텐션보다 계산 비용을 낮추는 것이 목적이다. Ling-3.0에는 fine-grained diagonal gating이 추가됐다. 이를 통해 이전 정보 가운데 무엇을 유지하고, 무엇을 새로운 정보로 갱신할지를 더 세밀하게 제어한다.
MLA(Multi-head Latent Attention)란 무엇인가
일반적인 어텐션에서는 이전 토큰의 Key와 Value를 KV Cache에 저장한다. 컨텍스트가 길어질수록 KV Cache도 커지기 때문에 많은 GPU 메모리가 필요하다.
MLA는 Key와 Value를 압축된 latent representation으로 저장해 KV Cache 사용량을 줄인다. 일반 어텐션의 정밀한 정보 검색 능력을 유지하면서 메모리 효율을 높이려는 구조다.
왜 두 방식을 함께 사용할까
선형 어텐션은 긴 컨텍스트를 효율적으로 처리할 수 있지만, 특정 위치의 정보를 정밀하게 찾아야 하는 작업에서는 일반 어텐션보다 불리할 수 있다.
반대로 MLA는 정밀한 관계 추론에는 유리하지만, 긴 문맥에서는 계산 및 캐시 비용이 증가한다.
Ling-3.0-flash는 대부분의 문맥을 KDA로 효율적으로 처리하고, 일정 간격으로 MLA를 배치해 정밀한 정보 검색 능력을 보완한다.
KDA: 긴 문맥을 효율적으로 누적 처리
+
MLA: 필요한 정보와 토큰 관계를 정밀하게 탐색
중요한 점은 Ling-3.0이 이 하이브리드 아키텍처를 사전학습 초기부터 적용했다는 것이다. 기존 모델을 만든 뒤 일부 레이어를 선형 어텐션으로 변경한 것이 아니라, 처음부터 KDA와 MLA의 조합을 기준으로 학습됐다.
256K 컨텍스트를 실제 학습에 사용
Ling-3.0-flash의 컨텍스트 학습 스케줄은 다음과 같다.
8K → 32K → 256K
단순히 짧은 컨텍스트로 학습한 모델에 외삽 기술을 적용해 최대 길이만 늘린 것이 아니라, 학습 과정에서 실제로 256K 컨텍스트까지 확장했다.
256K 컨텍스트는 다음과 같은 작업에 활용할 수 있다.
- 대규모 코드 저장소 분석
- 여러 개의 긴 기술 문서 검토
- 논문과 웹 검색 결과를 결합한 리서치
- 장시간 실행되는 에이전트 작업
- 여러 차례의 도구 호출 결과 유지
- 긴 대화 및 작업 기록 기반 추론
다만 256K 입력을 지원한다는 것이 전체 구간의 모든 정보를 동일한 정확도로 기억한다는 의미는 아니다. 실제 성능은 정보가 배치된 위치, 문서 구조, 프롬프트 방식과 컨텍스트 관리 전략에 따라 달라질 수 있다.
빠른 응답과 깊은 추론을 하나의 모델에서
inclusionAI는 Ling-3.0-flash를 Native Hybrid Reasoning Model이라고 소개한다.
이는 일반적인 빠른 응답과 긴 사고 과정을 사용하는 추론 응답을 하나의 모델에서 지원한다는 의미다.
Ling-3.0-flash는 thinking mode가 기본으로 활성화되어 있으며, 공식 모델 카드에서는 다음 설정을 권장한다.
temperature = 0.6
top_p = 0.95
top_k = 20
enable_thinking = true
따라서 이름에 flash가 포함됐지만, 단순히 짧은 답변을 빠르게 생성하는 모델만을 의미하지 않는다.
희소 MoE와 하이브리드 어텐션을 이용해 연산량을 줄이면서도, 필요한 경우 긴 추론 과정을 수행할 수 있도록 설계한 모델에 가깝다.
코딩과 에이전트 작업을 위한 모델
Ling-3.0-flash 발표에서 모델 구조만큼 강조되는 부분은 에이전트 학습이다.
inclusionAI는 코딩, 일반 업무, Deep Research를 포함한 1만 개 이상의 인터랙티브 환경을 학습에 활용했다고 설명한다.
일반적인 언어 모델 학습은 질문에 적절한 답변을 생성하는 데 집중한다. 반면 에이전트 학습에서는 모델이 다음 과정을 반복적으로 수행해야 한다.
- 사용자의 요청을 분석한다.
- 필요한 작업을 계획한다.
- 사용할 도구를 결정한다.
- 도구를 호출한다.
- 실행 결과를 확인한다.
- 오류가 발생하면 계획을 수정한다.
- 작업이 완료될 때까지 반복한다.
- 최종 결과를 사용자에게 전달한다.
Ling-3.0-flash는 다음과 같은 코딩 및 에이전트 프레임워크에서의 활용을 제시한다.
- Claude Code
- Kilo Code
- Qwen Code
- Hermes Agent
- OpenClaw
즉, Ling-3.0-flash는 단순한 챗봇 모델보다 코드 작성과 수정, 터미널 사용, 검색 및 여러 도구를 연결하는 실행형 AI 에이전트의 기반 모델을 목표로 한다.
공개된 주요 벤치마크
공식 모델 카드에 공개된 대표적인 평가 결과는 다음과 같다.
| 벤치마크 | 점수 | 평가 영역 |
| AIME 2026 | 93.2 | 고난도 수학 추론 |
| HMMT February 2026 | 87.0 | 수학 문제 해결 |
| SWE-Bench Pro | 56.6 | 실제 소프트웨어 수정 |
| SWE-Bench Multilingual | 72.4 | 다국어 코드 수정 |
| Humanity’s Last Exam | 22.7 | 고난도 지식 및 추론 |
수학 분야에서는 AIME 2026에서 93.2점을 기록했으며, 코딩 분야에서는 SWE-Bench Pro 56.6, SWE-Bench Multilingual 72.4를 제시했다. 특히 SWE-Bench 계열은 단순히 코드를 생성하는 능력보다 실제 GitHub 프로젝트에서 문제를 분석하고 코드를 수정하는 능력을 평가한다는 점에서 에이전트 모델과 관련성이 높다.
다만 이 결과를 일반적인 단일 모델 벤치마크와 동일하게 해석해서는 안 된다.
SWE-Bench 평가에는 OpenHands agent harness와 별도의 프롬프트가 사용됐다. 검색 평가에서는 내부 ReAct 및 멀티에이전트 하네스가 활용됐고, 일부 벤치마크에서는 GPT, Gemini, Claude 모델이 결과를 평가하는 judge 모델로 사용됐다.
따라서 공개된 점수는 Ling-3.0-flash의 순수한 모델 능력만을 나타내기보다 다음 요소가 결합된 시스템 성능에 가깝다.
Ling-3.0-flash
+ 프롬프트
+ 에이전트 하네스
+ 도구 사용
+ 컨텍스트 관리
+ 외부 평가 모델
또한 AntSWEBench처럼 inclusionAI 내부에서 사용하는 벤치마크도 포함돼 있어, 앞으로 독립적인 평가 결과를 추가로 확인할 필요가 있다.
긴 에이전트 작업을 위한 캐시 최적화
Ling-3.0-flash는 모델 자체뿐 아니라 추론 시스템의 효율도 함께 강조한다.
공식 설명에서는 다음 기술을 결합한 계층형 캐싱 구조를 제시한다.
- SGLang HiCache
- Mooncake hierarchical caching
- 물리적으로 분리된 dual pool
- 클러스터 공유 L3 cache
에이전트는 작업을 수행하는 동안 긴 대화 기록, 코드, 검색 결과와 도구 실행 결과를 반복해서 입력한다. 이때 동일한 prefix를 매번 다시 계산하면 응답 지연과 GPU 비용이 증가한다.
계층형 캐시는 이미 처리한 입력을 여러 단계에 저장해 불필요한 재계산을 줄인다.
inclusionAI는 이러한 구성으로 긴 입력 환경에서 TTFT, Time to First Token을 60%에서 80% 이상 줄일 수 있다고 주장한다.
다만 이 수치는 모델 자체의 개선만으로 발생한 결과라기보다, SGLang과 Mooncake를 포함한 특정 추론 인프라 구성에서 측정된 시스템 최적화 결과로 보는 것이 적절하다.
MTP를 이용한 생성 속도 향상
Ling-3.0-flash는 MTP, Multi-Token Prediction 방식으로 학습됐다.
일반적인 언어 모델은 현재까지 생성된 토큰을 기준으로 다음 토큰 하나를 예측한다.
MTP는 한 번의 계산에서 여러 개의 미래 토큰을 예측하도록 학습한다. 추론 과정에서는 이를 speculative decoding에 활용해 여러 토큰을 한 번에 확정할 수 있다.
공식 배포 가이드에서도 MTP 사용을 권장한다.
SGLang에서는 다음 옵션을 사용한다.
--speculative-algorithm NEXTN
vLLM에서는 다음과 같이 설정한다.
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
따라서 Ling-3.0-flash의 속도 이점을 충분히 사용하려면 모델 가중치뿐 아니라 MTP를 지원하는 추론 엔진도 함께 구성해야 한다.
실제로 가벼운 모델일까
Ling-3.0-flash는 토큰당 5.1B 파라미터만 활성화하지만, 로컬에서 쉽게 실행할 수 있는 5B 모델은 아니다.
단순하게 가중치 크기를 계산하면 다음과 같다.
| 가중치 형식 | 예상 가중치 크기 |
| BF16 | 약 248GB |
| FP8 | 약 124GB |
| INT4 | 약 62GB |
여기에 다음 메모리가 추가로 필요하다.
- KV Cache
- KDA 상태 캐시
- Expert routing buffer
- CUDA 작업 공간
- 긴 컨텍스트 입력
- 동시 요청 처리 공간
공식 실행 예제에서도 SGLang과 vLLM 모두 4개의 GPU를 사용하는 Tensor Parallel 구성을 제시한다.
따라서 Ling-3.0-flash는 개인용 GPU 한 장에서 실행하는 소형 모델이라기보다, 여러 GPU를 사용하는 서버에서 대형 모델의 연산 비용을 줄이기 위한 모델로 보는 것이 맞다.
특히 256K 컨텍스트와 여러 동시 요청을 함께 사용하려면 모델 가중치 외에도 상당한 런타임 메모리가 필요하다.
배포 시 확인해야 할 부분
Ling-3.0-flash는 MIT 라이선스로 공개돼 연구와 상업적 활용에 비교적 제약이 적다.
다만 현재 배포 난이도는 낮지 않다.
전용 SGLang과 vLLM 브랜치
공식 가이드는 일반 SGLang이나 vLLM 대신 inclusionAI가 제공하는 별도의 브랜치를 설치하도록 안내한다.
inclusionAI/sglang_ling_v3
inclusionAI/vllm-ling-v3
이는 KDA, MLA, MTP와 Ling 전용 tool-call parser를 처리하기 위한 구현이 아직 일반 배포판에 완전히 통합되지 않았다는 의미로 볼 수 있다.
Ling 전용 Parser
추론 서버 실행 시 다음 설정을 사용한다.
--tool-call-parser ling3
--reasoning-parser ling3
OpenAI 호환 API 형태로 서버를 실행할 수는 있지만, 기존 애플리케이션이 사용하는 tool-call 형식과 완전히 동일한지는 별도로 검증해야 한다.
초기 공개 모델
Ling-3.0-flash는 공개 초기 단계의 모델이다.
실제 서비스에 적용하기 전에는 다음 항목을 직접 테스트할 필요가 있다.
- 한국어 응답 품질
- 도구 호출 JSON 안정성
- 긴 작업 중 문맥 유지
- 코드 수정 성공률
- 환각 및 잘못된 도구 사용
- 전용 런타임의 안정성
- 양자화 적용 시 성능 저하
- 다중 GPU 환경의 처리량
Ling-3.0-flash의 장점
- 적은 활성 파라미터로 높은 성능을 목표로 한다
124B 전체 파라미터 중 토큰당 5.1B만 활성화한다. 전체 모델의 표현 능력을 유지하면서 실제 연산량을 줄이는 구조다. - 긴 컨텍스트 처리에 집중했다
KDA와 MLA를 결합하고, 실제 학습 과정에서 256K 컨텍스트까지 확장했다. 긴 코드와 문서를 처리하는 에이전트 작업에 적합하다. - 코딩과 도구 사용을 주요 목표로 한다
1만 개 이상의 인터랙티브 환경을 활용해 코딩, 일반 업무, Deep Research 에이전트 작업을 학습했다. - 추론 시스템까지 함께 최적화했다
MTP, SGLang HiCache, Mooncake 캐싱처럼 모델뿐 아니라 실제 서빙 환경의 속도와 비용을 함께 고려했다. - MIT 라이선스로 공개됐다
상업적 활용이 가능한 비교적 개방적인 라이선스를 사용한다.
아직 확인해야 할 한계
- 5.1B 모델처럼 가볍지는 않다
활성 파라미터는 5.1B지만, 124B 전체 가중치를 저장해야 한다. 실제 배포에는 다중 GPU 서버가 필요하다. - 전용 추론 환경에 대한 의존도가 높다
공식 성능을 충분히 활용하려면 별도의 SGLang 및 vLLM 브랜치와 MTP 설정이 필요하다. - 벤치마크가 시스템 구성에 영향을 받는다
일부 결과에는 에이전트 하네스, 별도 프롬프트, 멀티에이전트 구조와 외부 judge 모델이 포함됐다. - 독립적인 검증이 더 필요하다
공개 직후이기 때문에 실제 코딩 환경과 다양한 언어에서의 성능, 긴 작업의 안정성은 추가 평가가 필요하다.
마무리
Ling-3.0-flash에서 가장 흥미로운 점은 모델의 전체 크기를 단순히 키우는 대신, 실제 연산에 참여하는 파라미터를 크게 줄였다는 것이다.
124B라는 대형 모델이지만 토큰당 활성 파라미터는 5.1B다. 여기에 1/64 sparse MoE, KDA와 MLA의 하이브리드 어텐션, 256K 컨텍스트, MTP 기반 추론 가속을 결합했다.
이 구조가 목표로 하는 방향은 분명하다.
대형 모델의 성능을 유지하면서, 코딩·검색·도구 호출과 같은 장시간 에이전트 작업의 실제 운영 비용을 줄이는 것이다.
다만 5.1B active parameters라는 표현만 보고 소형 로컬 모델로 이해해서는 안 된다. 연산량은 크게 줄었지만 124B 전체 모델을 저장하고 여러 expert를 효율적으로 라우팅해야 하기 때문에 여전히 대규모 서버 인프라가 필요하다.
현재 공개된 결과만 보면 수학과 코딩, 에이전트 작업에서 상당히 강한 성능을 보여준다. 앞으로 주목할 부분은 독립 벤치마크에서도 비슷한 성능을 유지하는지, 전용 런타임이 일반 SGLang과 vLLM에 통합되는지, 그리고 실제 개발 환경에서 긴 작업을 얼마나 안정적으로 수행하는지다.
Ling-3.0-flash는 작은 모델을 만든 사례라기보다, 대형 AI 에이전트를 더 효율적으로 운영하기 위한 아키텍처와 추론 시스템을 함께 설계한 모델이라고 정리할 수 있다.
참고 자료
'Tech Notes' 카테고리의 다른 글
| Agent Lightning v1.0: 실제 AI Agent를 그대로 두고 RL로 학습시키는 방법 (0) | 2026.08.28 |
|---|---|
| LLM의 Router와 MoE는 어떻게 다를까? 모델 선택부터 Expert, Agent까지 (0) | 2026.08.19 |
| GPT-Live의 실제 구조가 공개됐다: 예상과 달랐던 핵심 설계 (0) | 2026.08.04 |
| Qwen3.8-Max 공개: 16일 동안 코딩하는 2.4조 파라미터 AI 모델 (0) | 2026.08.03 |
| Claude Code의 컨텍스트 엔지니어링이 바뀌었다: 더 많이 넣는 대신 필요한 순간에 불러오기 (0) | 2026.07.28 |


