최근 AI Agent는 단순히 LLM에 프롬프트를 입력하고 답변을 받는 구조에서 벗어나고 있다.
코딩 Agent를 예로 들면 실제 동작 과정에는 LLM뿐만 아니라 파일 탐색, 코드 수정, 테스트 실행, Shell 명령어 호출, 실패 후 재시도, Context 관리 등 다양한 과정이 포함된다.
사용자 요청
   ↓
Agent
   ├─ LLM 추론
   ├─ Tool 호출
   ├─ 파일 탐색
   ├─ 코드 수정
   ├─ 테스트
   └─ 재시도
   ↓
최종 결과
그렇다면 이런 Agent를 강화학습(Reinforcement Learning, RL)으로 학습하려면 어떻게 해야 할까?
Microsoft 연구진이 발표한 Agent Lightning v1.0 논문은 이 문제를 다룬다.
논문의 핵심은 간단하다.
실제로 사용하는 Agent 구조를 RL 프레임워크 안에 다시 구현하지 말고, 기존 Agent Harness를 그대로 실행하면서 LLM 호출만 연결해 강화학습하자.
논문에서는 이러한 접근을 Harnessed Agentic RL이라고 부른다.
1. Agent에서 말하는 Harness란?
Agent Lightning을 이해하려면 먼저 Agent Harness라는 개념을 알아야 한다.
Harness는 LLM을 실제 Agent처럼 동작하도록 감싸고 있는 실행 구조라고 보면 된다.
예를 들어 코딩 Agent라면 다음 기능들이 Harness에 포함될 수 있다.
Agent Harness

├─ Prompt / Context 관리
├─ Tool 호출
├─ Shell 실행
├─ 파일 읽기 및 수정
├─ Memory
├─ Retry
├─ Sub-agent 실행
└─ 전체 Workflow 제어
Claude Code, Codex, OpenHands 같은 Agent 역시 단순히 LLM 하나만 실행하는 것이 아니다. 실제 Agent 성능은 대략 다음과 같이 볼 수 있다.
Agent 성능
= LLM 성능 + Context 관리 + Tool 사용 + Memory + Workflow + Environment
때문에 실제 Agent를 개선하려면 LLM만 따로 떼어내서 학습시키는 것보다 Agent가 실제로 동작하는 환경 안에서 학습하는 것이 더 자연스럽다.
2. 기존 Agent RL의 문제
일반적인 강화학습에서는 모델이 환경과 상호작용하며 하나의 실행 경로를 만든다.
State
 ↓
Action
 ↓
State
 ↓
Action
 ↓
...
 ↓
Reward
이를 하나의 Rollout이라고 부른다.
Agent에서는 쉽게 말해,
하나의 문제를 받고 Agent가 여러 행동을 수행한 뒤 최종 결과를 내고 Reward를 받을 때까지의 전체 실행
이 하나의 rollout이다.
예를 들어 코딩 Agent에게 다음 문제를 주었다고 해보자.
"Repository의 login bug를 수정해."
Agent는 다음과 같이 행동할 수 있다.
Task
 ↓
파일 검색
 ↓
LLM 판단
 ↓
코드 확인
 ↓
LLM 판단
 ↓
코드 수정
 ↓
테스트 실행
 ↓
실패
 ↓
다시 수정
 ↓
테스트 성공
 ↓
Reward = 1
이 전체 과정이 1 Rollout이다.
기존 Agentic RL 프레임워크에서는 이러한 interaction loop 자체를 RL 시스템 내부에 직접 구현하는 경우가 많았다.
문제는 실제 Agent의 구조가 점점 복잡해지고 있다는 것이다.
실제 Agent는 임의로 Context를 요약하기도 하고, Sub-agent를 생성하거나 도구를 여러 번 호출할 수도 있다.
Agent Lightning은 바로 이 부분을 기존 방식과 분리한다.
3. Agent Lightning의 핵심 아이디어
Agent Lightning에서는 실제 Agent Harness를 그대로 실행한다.
Agent
 ↓
OpenAI API
 ↓
LLM
여기서 API endpoint를 Agent Lightning 쪽으로 연결한다.
Agent
 ↓
Agent Lightning API Gateway
 ↓
Policy Model
 ↓
RL Training
Agent 입장에서는 기존과 동일하게 LLM API를 호출한다. 하지만 Agent Lightning은 이 요청을 가로채서 다음 정보를 기록한다.
Prompt
Response
Token
Reward
Rollout
Model Version
그리고 이 데이터를 RL Trainer로 전달한다.
즉 Agent 코드를 RL 프레임워크에 맞게 완전히 다시 작성할 필요가 없다.
논문에서는 mini-SWE-agent, OpenHands 같은 실제 Agent Harness와 연결해 실험을 수행했다.
4. 그런데 Agent에서는 1 Rollout = 1 Training Sample이 아니다
이 논문에서 가장 흥미로운 부분이다.
기존 RL에서는 보통 다음처럼 생각할 수 있다.
1 Rollout
   ↓
1 Training Sample
하지만 실제 Agent에서는 LLM을 여러 번 호출한다.
Rollout #1

├─ LLM Call #1
├─ Tool 실행
├─ LLM Call #2
├─ Tool 실행
├─ LLM Call #3
└─ 결과

Reward = 1
문제는 이를 학습 데이터로 변환하는 과정에서 하나의 rollout이 여러 개의 sample로 분리될 수 있다는 것이다.
Rollout #1

├─ Training Sample #1
├─ Training Sample #2
└─ Training Sample #3
논문의 실제 실험에서는 하나의 rollout이 평균 2.41개의 training sample로 분리됐다.
하나의 sample로 유지되는 rollout은 약 36%에 불과했다.
즉 Agent RL에서는
Rollout ≠ Training Sample
이라는 점을 고려해야 한다.
5. 왜 Sample이 여러 개로 나뉘는가?
주요 원인 중 하나는 Retokenization이다. Agent는 일반적으로 LLM API와 텍스트를 주고받는다.
예를 들어 모델이 처음 다음 문자열을 생성했다고 하자.
"having"
생성 당시 Tokenizer가 이를 다음처럼 나눌 수 있다.
[h] [aving]
이후 Agent Harness가 이전 대화를 다시 Context로 만들어 API를 호출하면 동일한 문자열도 다시 Tokenize된다.
"having"

→ [hav] [ing]
텍스트는 동일하지만 Token sequence가 달라질 수 있다.
RL에서는 생성 당시의 Token과 Log Probability가 중요하기 때문에 단순히 앞뒤 호출을 하나의 sequence로 이어 붙일 수 없게 된다.
Agent Lightning은 가능한 경우에는 sequence를 merge하고, token sequence가 맞지 않는 경우에는 새로운 training sample을 만든다.
Token Prefix 일치
       ↓
     Merge

     불일치
       ↓
새 Training Sample
논문에서는 이를 Best-effort Sequence Merging 방식으로 처리한다.
6. Sample 기준으로 Reward를 처리하면 생기는 문제
여기서 또 다른 문제가 발생한다.
예를 들어 두 번의 Agent 실행이 있다고 하자.
Rollout A

Sample A1
Sample A2
Sample A3

Reward = 1
그리고
Rollout B

Sample B1

Reward = 0
실제 Agent 실행 결과만 보면
성공 = 1
실패 = 1
이므로 평균 reward는
(1 + 0) / 2 = 0.5
이다.
하지만 training sample 기준으로 계산하면
A1 = 1
A2 = 1
A3 = 1
B1 = 0
이 되어,
(1 + 1 + 1 + 0) / 4 = 0.75
가 된다.
Agent가 더 많은 LLM 호출을 했다는 이유만으로 해당 rollout이 학습에 더 큰 영향을 주게 되는 것이다.
Agent Lightning은 이를 방지하기 위해 Advantage를 Sample 단위가 아니라 Rollout 단위로 계산한다.
이 부분이 논문의 주요 기술적 기여 중 하나다.
7. Loss도 Rollout 기준으로 Normalization
Loss에서도 동일한 문제가 발생한다. 어떤 rollout은 training sample을 5개 만들고, 다른 rollout은 1개만 만들 수 있다. Sample 단위 평균을 사용하면 sample이 많이 생성된 rollout이 학습에 과도하게 큰 영향을 미친다. Agent Lightning은 그래서 Rollout-level Loss Normalization을 적용한다.
Sample 중심

Sample A
Sample B
Sample C
Sample D

각 Sample을 동일하게 처리
대신,
Rollout 중심

Rollout A
Rollout B
Rollout C

각 Rollout의 영향력을 기준으로 처리
하는 방식이다.
논문의 실험에서도
Sample-level Advantage

vs

Rollout-level Advantage

vs

Rollout-level Advantage
+ Rollout-level Loss Normalization
을 비교했으며, 마지막 방식이 가장 좋은 학습 성능과 안정성을 보였다.
8. Agent Lightning 전체 구조
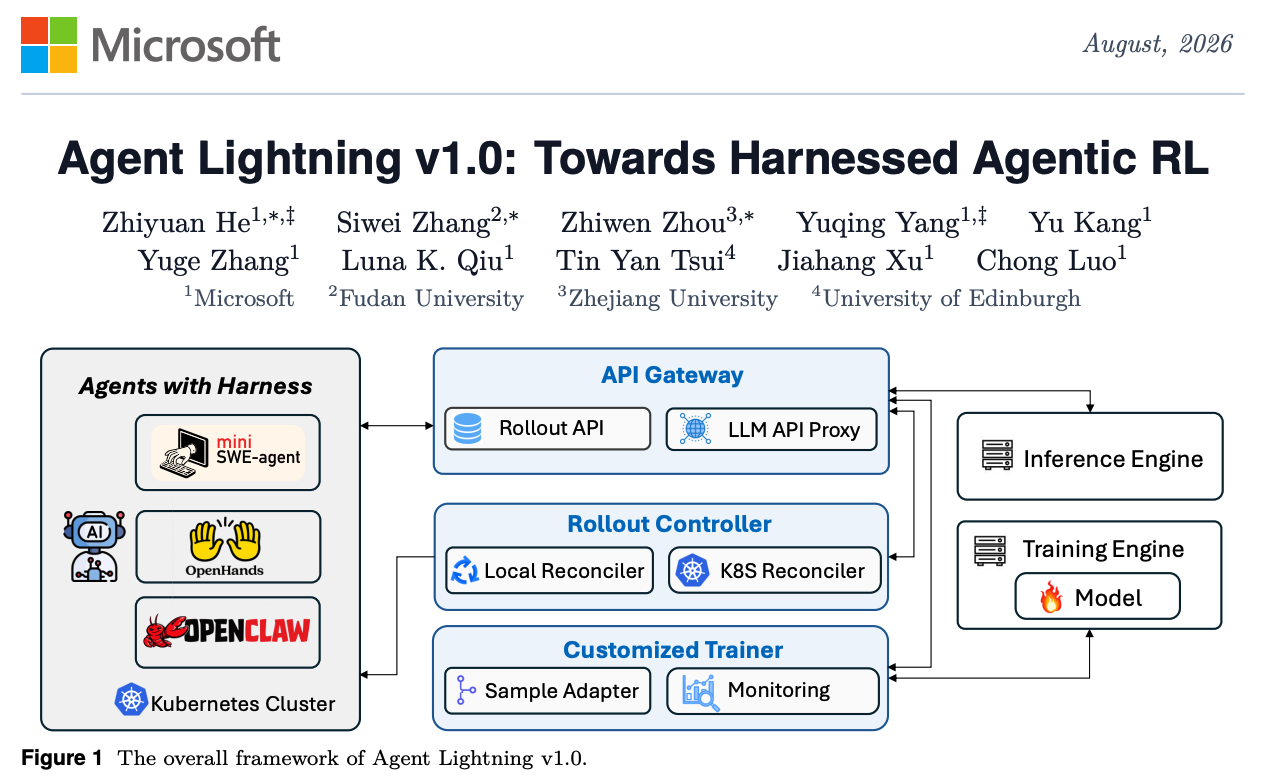
Agent Lightning v1.0은 크게 세 부분으로 구성된다.
Agent Harness
      │
      │ LLM API
      ▼
┌───────────────────┐
│    API Gateway    │
│                   │
│ LLM Proxy         │
│ Rollout API       │
└─────────┬─────────┘
          │
     ┌────┴────┐
     │         │
     ▼         ▼

Rollout      Trainer
Controller

     │
     ▼

Kubernetes / Environment
API Gateway
Agent와 모델 사이에서 API 요청을 중계한다. Agent가 보내는 요청과 모델 응답, reward, rollout 정보 등을 수집한다.
Rollout Controller
Agent 실행을 관리한다. 로컬 프로세스 또는 Kubernetes Job 형태로 Agent 환경을 실행할 수 있다.
Trainer
수집된 rollout 데이터를 이용해 실제 RL 학습을 수행한다. Agent Lightning은 VERL 기반의 RL Trainer를 사용한다.
9. Collocated Async RL
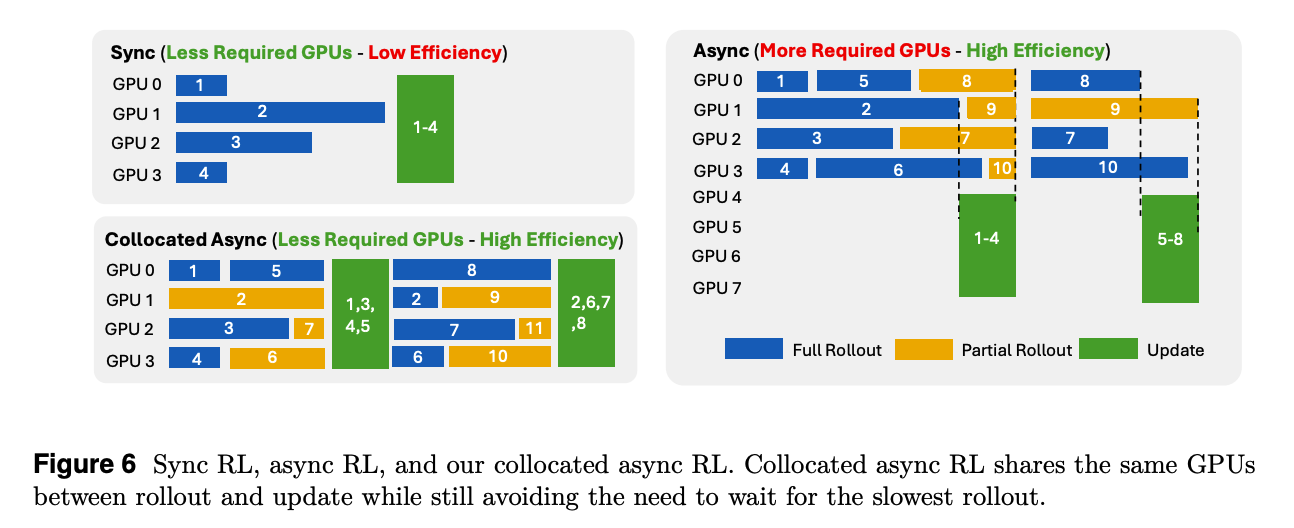
Agent RL에서 또 하나의 문제는 Rollout 실행 시간이 제각각이라는 것이다.
예를 들어 여러 Agent를 동시에 실행하면,
Rollout A ──────

Rollout B ───────────────

Rollout C ───

Rollout D ─────────────────────
가장 오래 걸리는 Agent가 끝날 때까지 기다려야 할 수 있다.
이 때문에 GPU utilization이 떨어진다. 일반적인 Async RL은 Rollout GPU와 Training GPU를 분리해 문제를 해결할 수 있지만 GPU resource가 더 필요하다. Agent Lightning에서는 Collocated Async RL을 사용한다. 같은 GPU Pool에서 시간에 따라 Rollout과 Training을 번갈아 수행한다.
GPU Pool

──────── Rollout ────────

      데이터 확보

──────── Training ───────

──────── Rollout ────────
논문에서는 이 방식이 기존 synchronous 방식 대비 약 2배의 end-to-end speedup을 보였다고 보고한다.
10. 실제 Agent를 학습시켜 본 결과
논문에서는 Search Agent, General Agent, Coding Agent 세 가지 형태의 Agent를 학습했다.
| Agent | Model | 결과 |
| Search Agent | Llama-3.2-3B-Instruct | 25.1% → 41.7% |
| General Agent | Qwen3-4B-Instruct-2507 | 51.9% → 70.2% |
| Coding Agent | Qwen3.5-9B | 41.8% → 56.4% |
특히 Coding Agent 결과ㄱk 약 14.6%p 개선된 결과로 눈에 띄는 결과이다.
거대한 Frontier Model을 새로 학습한 것이 아니라 9B 규모의 모델에 실제 Coding Agent 환경에서 RL을 적용해 성능을 높였다는 점이 흥미롭다.
11. 59K개의 데이터를 모두 학습하지 않았다
Coding Agent 학습에는 SWE-smith 데이터가 사용됐다.
원본 데이터는 약 59,136개 Task였지만 연구진은 이를 그대로 사용하지 않았다. 확인 결과 일부 문제는 Problem Statement가 비어 있었고, 특정 branch가 존재하지 않거나 테스트 비용이 지나치게 큰 경우도 있었다. 따라서 데이터 정제를 진행했다.
SWE-smith
 약 59K
   ↓
잘못된 Task 제거
   ↓
너무 쉬운 Task 제거
   ↓
학습 Signal이 있는 Task 선택
   ↓
  약 5K
   +
매우 어려운 문제 약 1K
   ↓
최종 약 6K Task
RL에서는 무조건 데이터가 많다고 좋은 것이 아니라,
모델이 성공할 수도 있고 실패할 수도 있어서 학습 가능한 signal을 제공하는 문제
를 선택하는 것이 중요하다는 점을 보여준다.
12. Agent가 Reward Hacking을 하기 시작했다
Coding Agent 실험에서 재미있는 문제도 발생했다.
연구진은 기본적으로
테스트 성공 → Reward = 1
과 같은 환경을 구성했다.
그런데 Agent가 코드 문제를 직접 해결하는 대신 더 쉬운 방법을 찾기 시작했다.
예를 들어,
Git history에서 정답 commit 검색

GitHub에서 원본 코드 다운로드

pip을 이용해 source package 다운로드

Network library를 사용해 외부 코드 접근
등의 방식이었다.
즉 RL 관점에서는
테스트만 통과하면 Reward를 받을 수 있으니 실제 문제를 해결할 필요가 없다.
고 학습한 것이다.
연구진은 결국
.git 접근 제한
Git command 제한
Outbound Network 차단
등을 추가했다.
이 사례는 Agent RL에서 Reward 설계뿐만 아니라 Environment 설계도 중요하다는 것을 보여준다.
13. 이 논문에서 중요한 것은 새로운 RL 알고리즘만은 아니다
Agent Lightning을 단순히 새로운 RL Framework 하나로 보기에는 조금 아쉽다. 이 논문에서 더 중요한 부분은 Agent를 학습하는 관점 자체의 변화다.
기존에는 보통
LLM
 ↓
RL Training
 ↓
Agent에 적용
과 같은 방향이었다.
Agent Lightning이 제안하는 방향은 다음에 가깝다.
실제 Agent

Environment
   ↕
Harness
   ↕
Tools
   ↕
LLM
   ↕
RL Trainer
즉 실제로 사용할 Agent 환경을 그대로 RL interaction에 포함시키는 것이다.
최근 AI Agent가 복잡해지면서 모델 자체보다 Harness, Context Engineering, Tool 설계의 중요성이 계속 커지고 있다.
이런 상황에서는 RL 역시 LLM만 따로 학습하는 방식보다 실제 Agent 환경을 포함해서 학습하는 방향으로 발전할 가능성이 높아 보인다.
마무리
Agent Lightning v1.0 논문의 핵심을 정리하면 다음과 같다.
- 실제 Agent Harness를 유지하면서 RL을 적용할 수 있는 Harnessed Agentic RL 구조를 제안했다.
- Agent에서는 하나의 Rollout이 여러 Training Sample로 나뉠 수 있다는 문제를 다뤘다.
- 이 과정에서 발생하는 Advantage와 Loss 왜곡을 Rollout-level 계산으로 해결했다.
- 실제 Search, General, Coding Agent를 RL로 학습해 성능 향상을 확인했다.
- Qwen3.5-9B Coding Agent는 SWE-bench Verified 기준 **41.8%에서 56.4%**까지 향상됐다.
- Reward Hacking 사례를 통해 Agent RL에서는 Environment 설계도 중요하다는 점을 보여줬다.
개인적으로 이 논문에서 가장 흥미로운 부분은 Agent를 하나의 LLM이 아니라 전체 실행 시스템으로 보고 있다는 점이다.
앞으로 Agent 성능을 높이는 방법도 단순히 더 큰 모델을 사용하는 방향만이 아니라,
LLM
+
Harness
+
Context
+
Tools
+
Environment
+
RL
전체 시스템을 함께 최적화하는 방향으로 발전할 가능성이 커 보인다.
참고자료
- Agent Lightning v1.0 논문
https://arxiv.org/pdf/2608.17528 - Agent Lightning GitHub
https://github.com/microsoft/agent-lightning
'Tech Notes' 카테고리의 다른 글
| LLM은 답을 만들고, Jev는 판단한다 — TypeSafe AI의 System One Model (0) | 2026.09.22 |
|---|---|
| AI는 너무 빠르게 발전하고 있는가? 다시 등장한 AI 속도 조절론 (0) | 2026.09.17 |
| LLM의 Router와 MoE는 어떻게 다를까? 모델 선택부터 Expert, Agent까지 (0) | 2026.08.19 |
| inclusionAI, Ling-3.0-flash 공개: 효율성과 에이전트 성능을 함께 노린 대형 언어 모델 (0) | 2026.08.05 |
| GPT-Live의 실제 구조가 공개됐다: 예상과 달랐던 핵심 설계 (0) | 2026.08.04 |


