최근 AI 모델 경쟁은 대부분 비슷한 방향으로 흘러가고 있다.
더 오래 추론하고, 더 복잡한 문제를 해결하고, 여러 도구를 사용하며 긴 작업을 스스로 수행할 수 있는 Agent 능력을 높이는 것이다.
Reasoning, Planning, Coding, Tool Use 같은 능력이 계속 강화되면서 하나의 모델이 처리할 수 있는 작업 범위도 빠르게 넓어지고 있다.
그런데 TypeSafe AI는 조금 다른 문제를 바라봤다.
모든 판단에 이렇게 강력한 LLM이 정말 필요한가?
2026년 9월 TypeSafe에서 공개한 Jev는 이 질문에서 출발한 모델이다.
Home - TypeSafe AI
TypeSafe AI is an AI lab building machine-native intelligence infrastructure for automation, designed to make decisions within software. Try our first System One Model, Jev, in early access.
typesafe.ai
Jev는 더 긴 글을 생성하거나 복잡한 reasoning을 수행하기 위한 모델이 아니다. 오히려 텍스트 생성을 줄이고 빠른 판단에 집중한 모델이다. TypeSafe AI는 이러한 모델을 System One Model이라고 부른다.
기존 LLM의 문제를 다른 관점에서 바라봤다
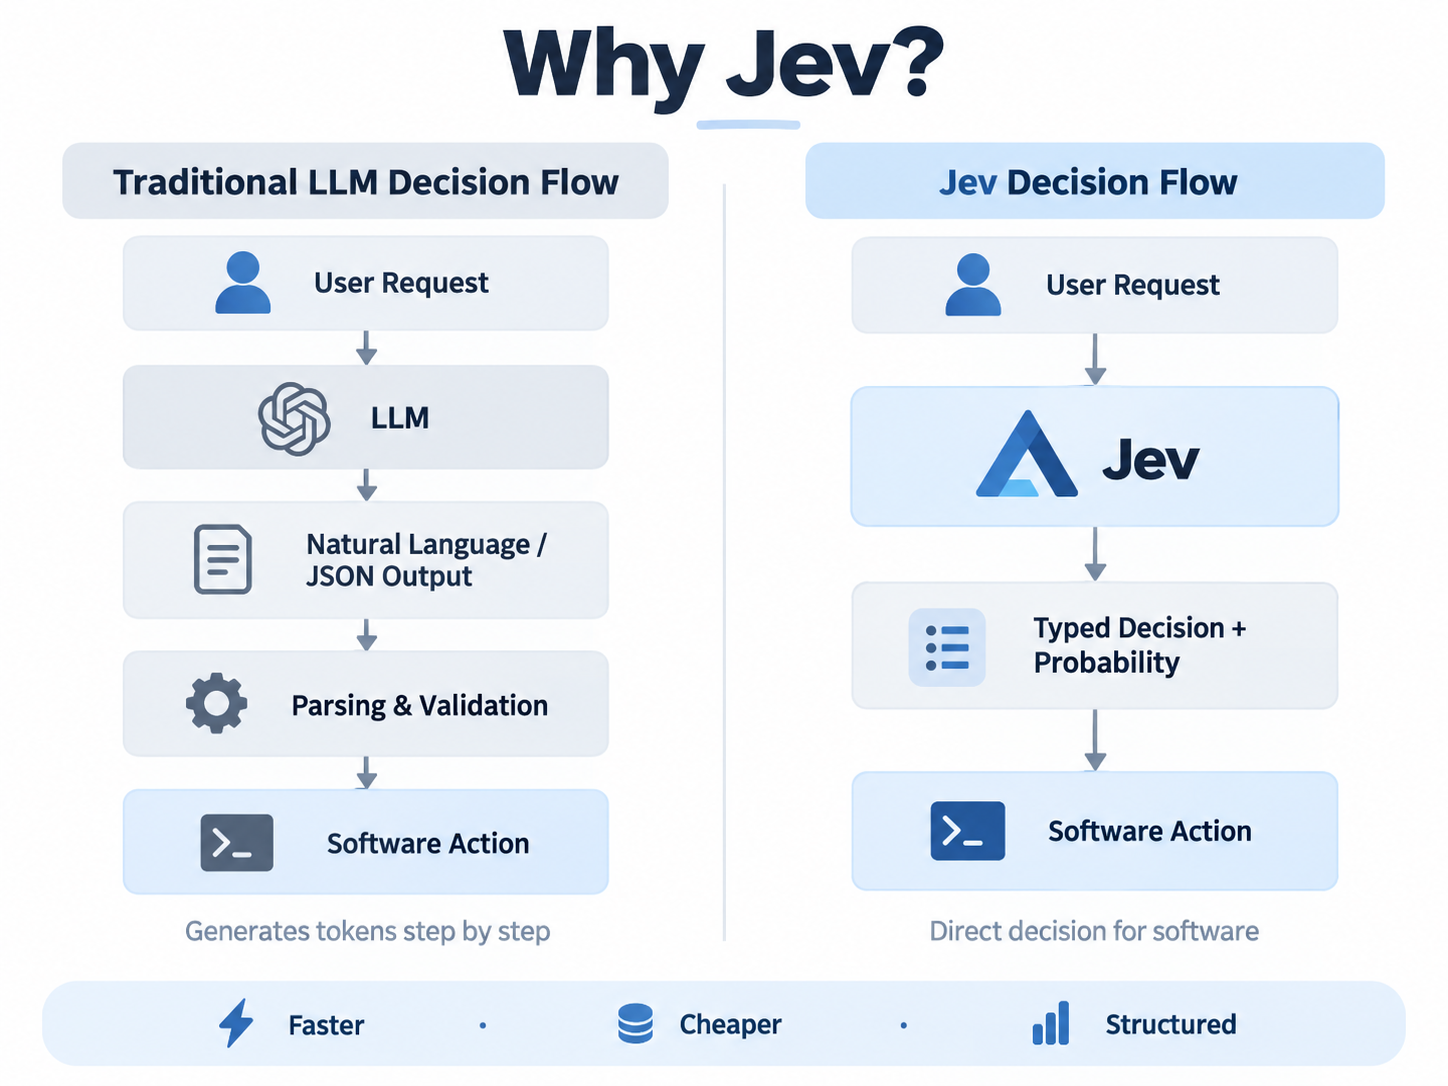
일반적인 LLM은 기본적으로 다음 토큰을 하나씩 예측한다.
Input
 ↓
LLM
 ↓
Token 1
 ↓
Token 2
 ↓
Token 3
 ↓
...
 ↓
Natural Language / JSON
사람과 대화하거나 문서를 작성한다면 이런 방식이 자연스럽다. 하지만 실제 AI 애플리케이션 내부에는 긴 문장이 필요하지 않은 판단도 많다.
예를 들어,
이 요청은 위험한가?
- YES or NO
또는
이 요청은 어느 카테고리인가?
- Billing or Technical or Refund or Other
처럼 몇 가지 선택지 중 하나만 결정하면 되는 경우다.
기존 LLM을 사용하면 이런 간단한 판단에도 먼저 텍스트를 생성해야 한다.
Input
 ↓
LLM
 ↓
JSON 생성
 ↓
Parsing
 ↓
Validation
 ↓
Application Logic
실제로 애플리케이션에 필요한 것은 결국 하나의 결정값인데, 그 값을 얻기 위해 자연어 생성 단계를 거치는 셈이다.
TypeSafe가 문제라고 본 것이 바로 이 부분이다.
Jev에서는 이 구조를 다음처럼 바꾼다.
State
+
Question
+
Choices
 ↓
Jev
 ↓
Decision + Probability
자연어 답변을 만들고 다시 해석하는 것이 아니라 소프트웨어에서 바로 사용할 수 있는 판단 결과를 반환하는 것이다.
System One Model이란?
System One이라는 이름은 Daniel Kahneman의 《Thinking, Fast and Slow》에서 말하는 인간의 두 가지 사고 방식에서 가져왔다.
크게 나누면 다음과 같다.
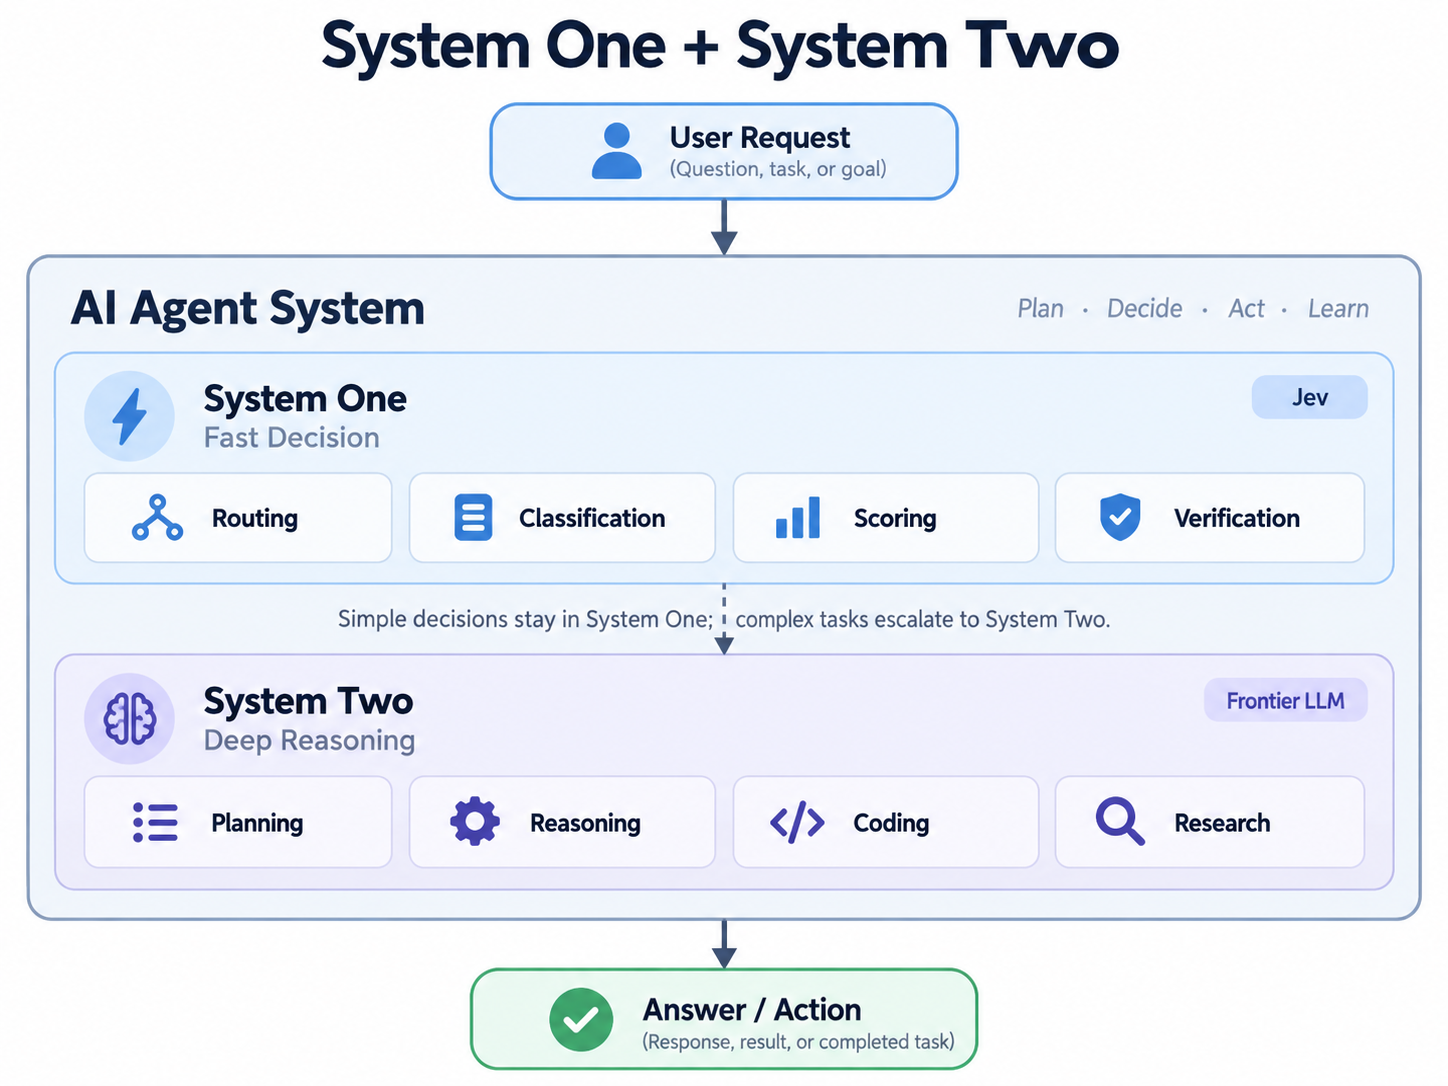
최근 LLM은 대부분 System 2 방향으로 발전하고 있다.
GPT나 Claude 같은 Frontier Model이 점점 더 오랜 시간 생각하고 복잡한 문제를 해결하도록 발전하는 이유다.
TypeSafe는 반대쪽에 집중했다.
Routing
Classification
Scoring
Verification
Decision
깊게 생각하는 것이 아니라 빠르게 판단하는 모델을 별도로 만들겠다는 것이다.
Jev는 무엇을 출력할까?
Jev에서는 크게 세 종류의 판단 구조를 제공한다.
- Noul: True / False 형태의 판단이다.
Is this transaction suspicious?
- TRUE or FALSE- Choice: 여러 후보 중 하나를 선택한다.
Which category?
- Billing or Refund or Technical or Other- Score: 특정 상태를 점수로 평가한다.
Customer churn risk?
- 1~5
중요한 점은 단순히 결과 하나만 반환하는 것이 아니다.
예를 들어 다음과 같은 확률 정보(Confidence score)도 얻을 수 있다.
Billing      0.08
Refund       0.12
Technical    0.76
Other        0.04
즉 Jev는
unstructured information → typed probabilistic decision
을 수행하는 모델로 볼 수 있다.
그렇다면 BERT와 무엇이 다른가?
Jev를 보면 가장 먼저 떠오르는 모델 중 하나가 BERT다. BERT도 텍스트 Classification에 매우 많이 사용되며, LLM보다 빠르게 특정 판단을 수행할 수 있다.
예를 들어 고객 문의 분류 모델을 만든다면 다음과 같은 형태다.
Customer Message
       ↓
      BERT
       ↓
    Billing
    Refund
    Technical
그렇다면 Jev는 그냥 새로운 BERT classifier라고 볼 수 있을까?
둘 사이에는 중요한 차이가 있다.
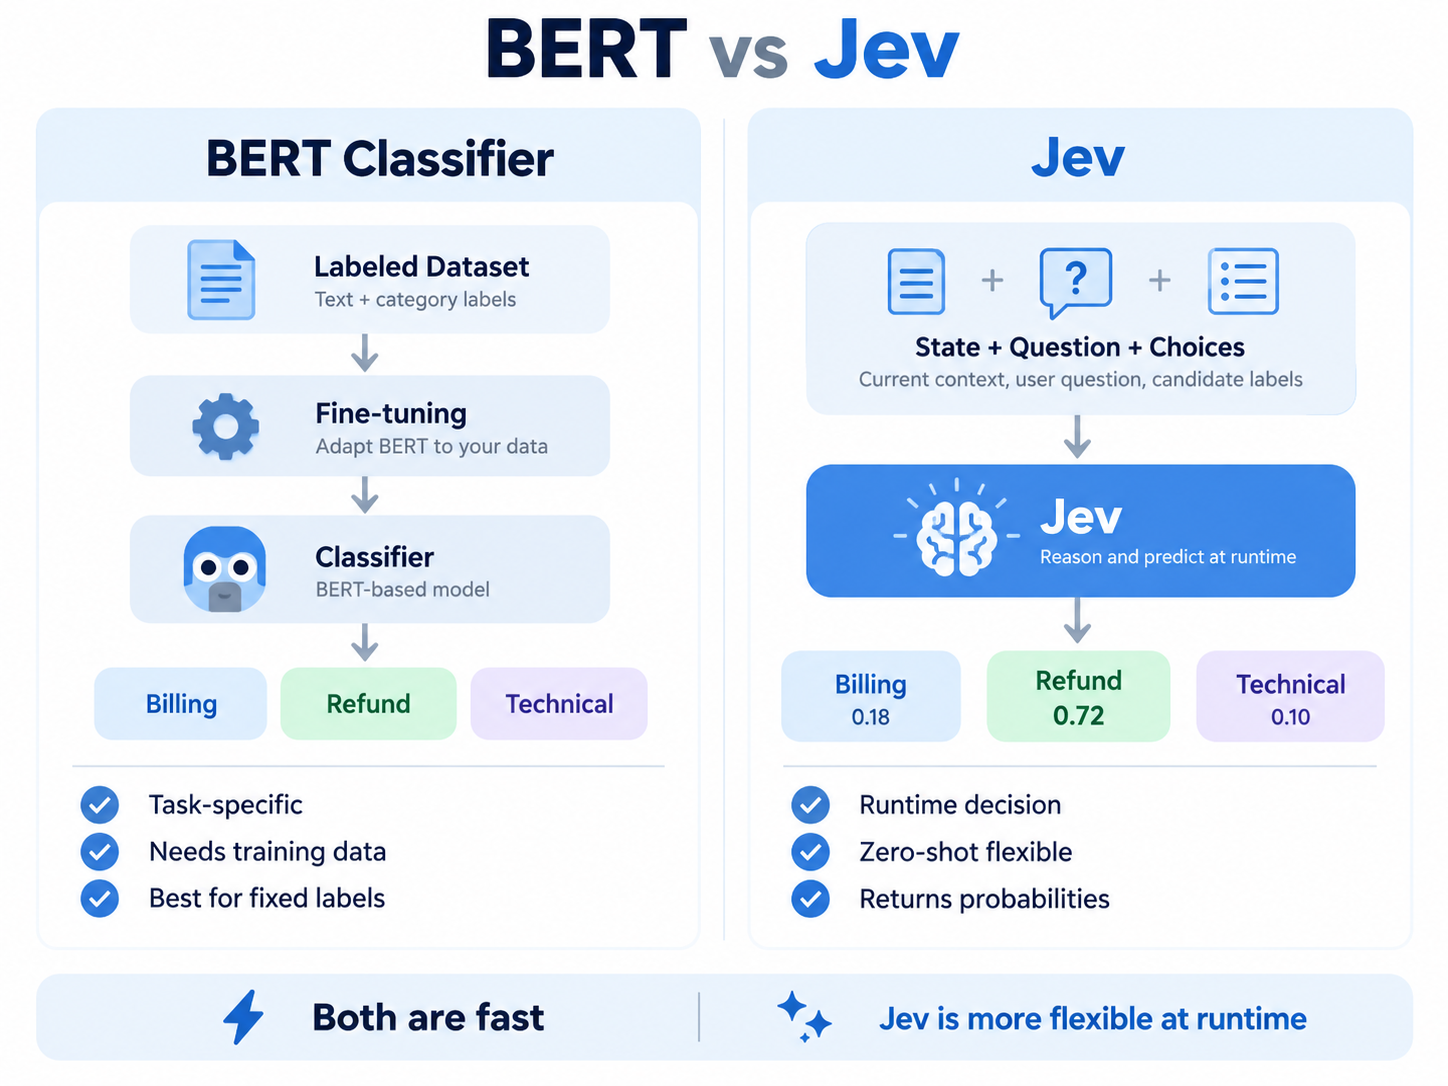
BERT는 보통 Task를 먼저 정의한다
BERT 기반 classifier를 만든다고 생각해보자.
먼저 데이터가 필요하다.
"환불해주세요"
→ REFUND

"로그인이 안 됩니다"
→ TECHNICAL

"결제가 이상합니다"
→ BILLING
이 데이터를 가지고 모델을 Fine-tuning 한다.
Labeled Dataset
      ↓
Fine-tuning
      ↓
BERT Classifier
      ↓
Fixed Labels
즉 모델을 학습할 때 이미 어떤 문제를 풀 것인지 정해져 있다.
그리고 새로운 카테고리가 생기거나 판단 기준이 크게 달라지면 추가 데이터와 Fine-tuning이 필요할 수 있다.
Jev는 Task 자체를 입력으로 전달한다
Jev의 접근은 조금 다르다.
모델 실행 시점에
State
+
Question
+
Choices
를 함께 전달한다.
예를 들어,
State:

Customer says:
"I don't recognize this payment."

Question:

What should we do?

Choices:

REFUND
FRAUD_CHECK
CUSTOMER_SUPPORT
IGNORE
라고 전달하면 모델은 이를 직접 판단한다.
FRAUD_CHECK        0.82
CUSTOMER_SUPPORT   0.12
REFUND             0.05
IGNORE             0.01
따라서 개념적으로 비교하면 다음과 같다.
BERT

Task 정의
 ↓
Dataset 생성
 ↓
Fine-tuning
 ↓
Inference
반면 Jev는
Jev

State
+
Task
+
Choices
 ↓
Inference
에 가깝다.
즉 BERT처럼 판단에 특화되어 있으면서도 LLM처럼 runtime에서 새로운 질문을 받을 수 있도록 설계한 것이 중요한 차이다.
Jev에서 더 중요한 것은 Probability다
Jev가 단순 Classification 모델과 다른 부분 중 하나는 확률을 모델 인터페이스의 중요한 요소로 사용한다는 점이다.
예를 들어:
LOW      0.03
MEDIUM   0.14
HIGH     0.83
처럼 출력할 수 있다.
그러면 애플리케이션에서는 confidence를 이용해 다음 행동을 결정할 수 있다.
if confidence > 0.9:
    execute()

elif confidence > 0.7:
    verify()

else:
    escalate()
단순히
HIGH
라고 판단하는 것보다
HIGH: 0.83
이라고 판단하는 것이 실제 시스템에서는 훨씬 많은 정보를 제공한다.
그리고 이 부분이 TypeSafe가 이야기하는 RLCD와 연결된다.
RLHF 대신 RLCD — 판단의 확률까지 학습한다
TypeSafe는 Jev 학습에 RLCD(Reinforcement Learning for Calibrated Decisions)라는 방법을 사용했다고 설명한다.
최근 LLM에서 익숙한 RLHF와 비교하면 목표가 조금 다르다.
RLHF는 일반적으로
어떤 답변을 사람이 더 선호하는가?
에 초점을 맞춘다.
단순화하면 다음과 같다.
Model Response
      ↓
Human Preference
      ↓
Reward
      ↓
Model Optimization
좋은 문장을 생성하고 사용자의 의도를 잘 따르는 모델을 만드는 것이 중요한 목적이다.
하지만 Jev에서는 자연어를 잘 생성하는 것이 목표가 아니다.
중요한 것은
Decision
+
Confidence
다.
Calibration이 핵심이다
여기서 중요한 개념이 Calibration이다. 예를 들어 어떤 모델이 100개의 문제에서
Confidence = 90%
라고 판단했다고 하자.
잘 Calibration된 모델이라면 실제로 이 문제들 중 약 90개 정도가 맞아야 한다.
반대로 모델이 항상
Confidence = 99%
라고 이야기하지만 실제 정확도가 70%라면 confidence를 신뢰하기 어렵다.
따라서 RLCD가 노리는 것은 단순히 정답을 맞혀라. 에서 끝나지 않는다. 더 중요한 목표는 얼마나 확실한 판단인지도 제대로 추정하라. 에 있다.
개념적으로는 다음과 같다.
State
 ↓
Decision
 ↓
Probability
 ↓
Actual Result
 ↓
Calibration Evaluation
 ↓
RLCD
즉 모델이 출력하는 probability 자체가 실제 정확도와 최대한 일치하도록 학습하는 것이다.
왜 Calibration이 중요한가?
Agent나 자동화 시스템에서는 모델의 판단이 바로 행동으로 이어질 수 있다.
예를 들어 모델이 어떤 요청을 자동 처리해도 되는지 판단한다고 가정해보자.
Approve
Confidence = 0.98
와
Approve
Confidence = 0.56
는 같은 결과지만 시스템에서는 완전히 다르게 처리할 수 있다.
98%
→ 자동 처리

56%
→ 다른 모델로 재검증
→ 또는 사람이 확인
즉 Jev는 판단 자체뿐 아니라 “이 판단을 얼마나 신뢰해야 하는가”까지 시스템에 전달하려는 모델이라고 볼 수 있다.
이 부분이 단순 Classification 모델과 구분되는 중요한 특징 중 하나다.
에이전트 시대에 왜 이런 모델이 필요할까?
최근 AI 연구를 보면 Agent의 능력을 높이는 방향이 매우 강하다. 하나의 Agent가 수행하는 과정은 점점 복잡해지고 있다.
User Request
 ↓
Understand
 ↓
Plan
 ↓
Decide
 ↓
Execute
 ↓
Evaluate
 ↓
Re-plan
 ↓
Answer
그런데 여기에는 중요한 문제가 하나 있다.
Agent가 복잡해질수록 작은 판단의 횟수도 증가한다.
예를 들어:
검색이 필요한가?
계산이 필요한가?
현재 정보로 충분한가?
다른 방법을 시도해야 하는가?
결과를 다시 검증해야 하는가?
추가 reasoning이 필요한가?
등이다.
이런 판단 하나하나에 Frontier LLM을 사용하면 모델 자체의 성능은 높아지더라도 전체 시스템의
Latency
Cost
Token Usage
가 증가할 수 있다.
TypeSafe는 이 문제를 다른 방식으로 접근한다.
모든 문제를 큰 모델에게 맡기지 않는다
기존 Agent 구조를 단순화하면 이런 모습이다.
                 Large LLM

Understand
Reason
Plan
Decide
Route
Verify
Generate
하나의 모델이 거의 모든 역할을 맡는다.
하지만 역할을 분리하면 다음과 같은 구조도 가능하다.
             AI System

        ┌─────────────┐
        │ System One  │
        │             │
        │ Routing     │
        │ Classify    │
        │ Score       │
        │ Verify      │
        │             │
        │ Jev         │
        └──────┬──────┘
               │
       Complex Problem
               ↓
        ┌─────────────┐
        │ System Two  │
        │             │
        │ Reasoning   │
        │ Planning    │
        │ Coding      │
        │ Research    │
        │             │
        │ Large LLM   │
        └─────────────┘
간단한 판단을 System One Model이 처리하고 정말 복잡한 문제만 Frontier LLM으로 넘기는 방식이다.
결국 핵심은 Router일 수도 있다
Agent가 사용할 수 있는 기능이 늘어나면 어떤 행동을 선택할 것인가가 점점 중요해진다.
예를 들어 시스템에 100개의 기능이 있다고 생각해보자.
기존 방식이라면 큰 LLM이 매번 100개의 후보를 확인하고 판단해야 할 수 있다.
100 Candidates
      ↓
Large LLM
      ↓
Decision
하지만 먼저 작은 Decision Model이 후보를 줄여줄 수도 있다.
100 Candidates
      ↓
Jev
      ↓
Top 3 Candidates
      ↓
Large LLM
      ↓
Final Decision
이 구조의 장점은 단순하다.
Large LLM이 확인해야 하는 범위를 줄일 수 있다.
결과적으로
Smaller Search Space
        ↓
Less Context
        ↓
Lower Latency
        ↓
Lower Cost
가 가능해질 수 있다.
물론 이것이 모든 Agent에서 항상 더 좋은 구조라는 의미는 아니다. Router가 잘못된 후보를 제거하면 뒤의 강력한 LLM도 정답을 찾지 못할 수 있기 때문이다. 그래서 Router의 정확도와 Calibration이 중요해진다.
그리고 다시 여기서 RLCD라는 Jev의 학습 방향이 의미를 갖는다.
Benchmark는 어떻게 나왔을까?
TypeSafe가 공개한 평가에서 Jev는 일반적인 MMLU나 GPQA 같은 benchmark보다 실제 software workflow 형태의 평가에 집중했다.
평가 영역에는 Security Incident, Customer Service, Invoice Processing 등 판단 중심의 작업이 포함됐다.
TypeSafe는 일부 환경에서 기존 LLM 대비
최대 약 193배 빠른 속도
최대 약 444배 낮은 비용
을 기록했다고 발표했다.
다만 이 숫자를 Jev가 GPT나 Claude보다 193배 뛰어나다. 라고 해석하면 안 된다.
비교하는 작업 자체가 다르기 때문이다. Jev가 평가받는 영역은
Classification
Routing
Scoring
Decision
같은 제한된 판단 Task다. 복잡한 reasoning이나 coding을 비교한 결과가 아니다.
따라서 이번 benchmark의 의미는 복잡한 reasoning이 필요 없는 판단에는 훨씬 작은 Decision Model을 사용하는 것이 효율적일 수 있다. 정도로 이해하는 것이 적절하다.
"Hallucination이 없다"는 것도 조금 다르게 봐야 한다
TypeSafe는 Jev의 특징으로 Zero Hallucinations를 강조한다.
하지만 이것은 Jev는 절대로 잘못 판단하지 않는다. 라는 의미가 아니다.
예를 들어 가능한 출력이
LOW
MEDIUM
HIGH
로 정의되어 있다면 Jev가
SUPER_HIGH
같은 존재하지 않는 값을 임의로 생성하지 않는다는 의미에 가깝다.
즉 다음과 같은 문제를 막을 수 있다.
잘못된 JSON
존재하지 않는 Enum
정의되지 않은 출력
Schema Error
이를 Structural Hallucination이라고 볼 수 있다.
하지만
실제로 HIGH인데 LOW라고 판단
하는 Semantic Error는 여전히 발생할 수 있다. 결국 Typed Output이 출력 형식의 안정성은 보장할 수 있지만 판단 자체의 정확성을 보장하지는 않는다. 그래서 다시 Probability와 Calibration이 중요해진다.
Jev가 흥미로운 이유
처음 Jev를 보면
또 하나의 작은 AI 모델인가?
라고 생각할 수도 있다. 하지만 이번 발표에서 개인적으로 흥미로운 부분은 모델 크기나 benchmark보다 접근 방식이다.
최근 AI 연구는 대부분
더 깊게 생각하기
더 오래 생각하기
더 많은 Tool 사용하기
더 복잡한 Agent 만들기
에 집중하고 있다.
TypeSafe는 오히려 반대로 질문했다.
모든 단계에서 그렇게 깊게 생각해야 할까?
그리고
빠른 판단
        +
깊은 추론
을 분리하려고 한다.
즉
Jev
→ Decide

Frontier LLM
→ Think
라는 역할 분담이다.
정리
앞으로 Agent가 복잡해질수록 모델이 해야 하는 판단 횟수도 계속 증가할 가능성이 높다.
그렇다면 AI 시스템의 성능을 높이는 방법이 반드시
더 큰 모델
만은 아닐 수 있다.
오히려
어떤 문제는 빠르게 판단하고

어떤 문제만 깊게 생각할 것인가
를 잘 나누는 것이 중요해질 수 있다. 그런 관점에서 Jev는 흥미로운 시도다. BERT처럼 특정 Task를 위해 매번 classifier를 별도로 학습하는 것도 아니고, Frontier LLM처럼 모든 판단을 자연어 생성과 복잡한 reasoning으로 해결하는 것도 아니다.
그 사이에서
runtime에 정의되는 문제를 빠르게 판단하고, 그 판단의 확률까지 제공하는 모델
이라는 새로운 위치를 만들려고 한다. 특히 RLCD를 통해 판단 정확도뿐 아니라 confidence calibration까지 모델의 핵심 목표로 삼았다는 점이 Jev를 단순 Classification 모델과 구분하는 중요한 특징이다.
아직 Early Access 단계이고 RLCD의 구체적인 학습 방법이나 모델 아키텍처에 대한 기술 자료도 더 공개될 필요가 있다.
하지만 Agent의 성능 경쟁이 대부분 System Two에 집중되어 있는 상황에서, TypeSafe가 System One이라는 반대편 문제를 본 것 자체는 꽤 흥미로운 접근이라고 생각한다.
결국 미래의 AI 시스템은 하나의 거대한 모델이 모든 것을 처리하기보다,
Fast Decision
     ↓
System One Model

Deep Reasoning
     ↓
Frontier LLM
처럼 역할이 점점 분리되는 방향으로 발전할 수도 있다.
Jev는 그 가능성을 보여주는 초기 사례라고 볼 수 있다.
참고자료
- TypeSafe AI — Introducing System One Models & Jev
https://typesafe.ai/blog/introducing-system-one-models-and-jev - TypeSafe AI Documentation
https://docs.typesafe.ai/introduction - TypeSafe AI
https://typesafe.ai/ - AI타임스 — TypeSafe AI Jev 관련 기사
https://www.aitimes.com/news/articleView.html?idxno=215506
'Tech Notes' 카테고리의 다른 글
| IBM ALTK-Evolve 분석 — LLM을 재학습하지 않고 Agent 성능을 높이는 방법 (0) | 2026.10.21 |
|---|---|
| Jev 이후 등장한 Julia-1 — 거대한 LLM 대신 144M 모델이 Agent의 결정을 맡는다면 (0) | 2026.09.29 |
| AI는 너무 빠르게 발전하고 있는가? 다시 등장한 AI 속도 조절론 (0) | 2026.09.17 |
| Agent Lightning v1.0: 실제 AI Agent를 그대로 두고 RL로 학습시키는 방법 (0) | 2026.08.28 |
| LLM의 Router와 MoE는 어떻게 다를까? 모델 선택부터 Expert, Agent까지 (0) | 2026.08.19 |


