FinGraph 프로젝트를 진행하면서 GraphRAG를 구현해봤는데, 관련 자료를 찾아보다가 흥미로운 논문 하나를 발견했다.
논문 제목은 RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM이다.
(논문 링크: https://arxiv.org/pdf/2607.11683)
GraphRAG를 구현하다 보면 자연스럽게 이런 고민이 생긴다.
- 문서에서 Entity와 Relation을 어떻게 안정적으로 추출할 것인가?
- 같은 Entity가 여러 문서에서 반복될 때 어떻게 하나로 합칠 것인가?
- Knowledge Graph 품질을 높이려면 결국 더 큰 LLM이 필요한가?
- 만들어진 그래프를 실제 검색에서는 어떻게 활용해야 하는가?
이번 논문은 이런 문제에 대해 꽤 현실적인 접근을 제안한다.
핵심은 간단하다.
GraphRAG에서는 더 큰 LLM을 사용하는 것보다, Entity/Relation을 추출하고 정제하는 파이프라인을 잘 만드는 것이 중요할 수 있다.
이를 위해 저자들은 RAGU라는 GraphRAG 엔진과 GraphRAG 작업에 특화된 Meno-Lite-0.1이라는 7B 모델을 함께 제안한다.
1. 기존 GraphRAG의 문제는 무엇일까?
일반적인 GraphRAG는 문서를 Chunk로 나누고, LLM으로 Entity와 Relation을 추출한 뒤 Knowledge Graph를 만든다.
대략 다음과 같은 구조다.
Document
   ↓
Chunking
   ↓
LLM
   ↓
Entity + Relation Extraction
   ↓
Knowledge Graph
   ↓
Graph Retrieval
   ↓
LLM Answer
문제는 LLM이 한 번의 Extraction 과정에서 만든 결과를 그대로 Graph에 넣는 경우가 많다는 점이다. 논문에서는 이를 Single-pass Extraction 문제라고 설명한다.
예를 들어 여러 문서에 같은 기업이 다음과 같이 등장할 수 있다.
Samsung Electronics
Samsung
Samsung Electronics Co.
사람이 보면 같은 기업일 가능성이 높지만, 별도의 처리가 없다면 Graph에서는 서로 다른 Node가 될 수 있다. Relation 역시 비슷하다.
Samsung ── produces ──> HBM

Samsung Electronics ── manufactures ──> HBM
결국 Graph가 커질수록 중복된 Entity와 불완전한 Relation이 계속 쌓이게 된다. 저자들은 기존 GraphRAG가 크게 세 가지 문제를 가지고 있다고 본다.
- Single-pass Extraction
- 큰 LLM에 대한 의존
- 실제 서비스에 적용하기 어려운 Engineering 문제
RAGU는 이 세 문제를 함께 해결하는 것을 목표로 한다.
2. RAGU의 핵심 — Extraction과 Consolidation을 분리한다
RAGU에서 가장 눈에 띄는 부분은 Graph를 만드는 과정을 여러 단계로 나눈다는 점이다.
전체 구조는 다음과 같다.
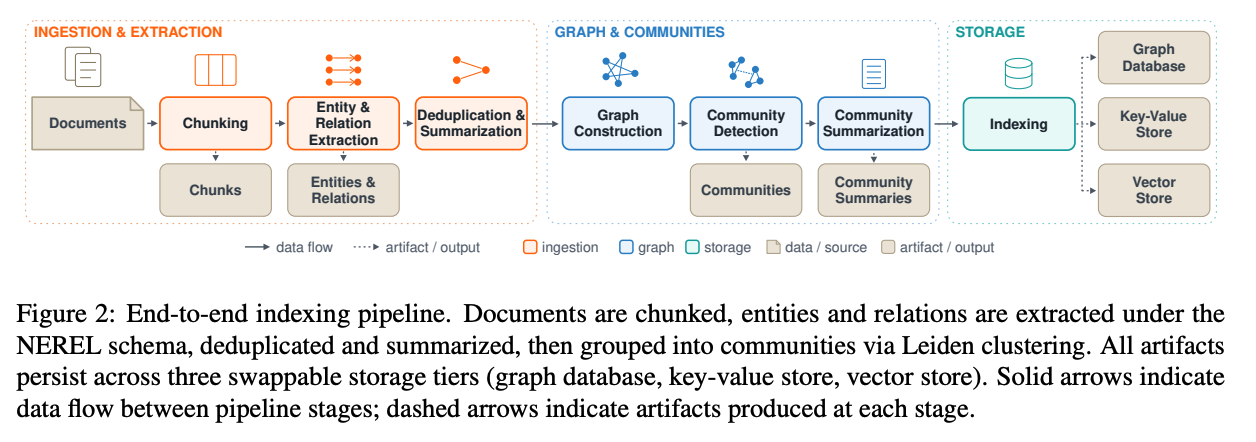
위 파이프라인에서, Ingestion & Extraction → Graph & Communities → Storage로 전체 파이프라인을 명확하게 나누고 있다는 것을 볼 수 있다. 여기서 기존 GraphRAG와 가장 크게 다른 부분은 바로 Deduplication & Summarization 단계다.
기존 방식이
Extraction
   ↓
Graph
에 가깝다면 RAGU는
Extraction
   ↓
Validation
   ↓
Deduplication
   ↓
Summarization
   ↓
Graph
구조를 사용한다. 즉 LLM이 처음 추출한 결과를 정답처럼 취급하지 않는다.
3. Entity와 Relation도 한 번에 추출하지 않는다
RAGU는 Entity와 Relation을 한 번의 Prompt로 동시에 생성하지 않는다.
먼저 Entity를 추출한다.
Text
 ↓
Entity Extraction
 ↓
Entity A
Entity B
Entity C
그리고 Entity가 검증되고 나면, 이 Entity들을 기준으로 Relation을 추출한다.
Validated Entities
 ↓
Relation Extraction
 ↓
A ── relation ──> B
RAGU는 NEREL Schema를 사용하며 29개의 Entity Type과 49개의 Relation Type을 정의한다. 중요한 점은 Relation Extraction 단계에서 새로운 Entity를 마음대로 만들 수 없도록 한다는 것이다.
즉 LLM이
A와 B 사이에 관계가 있을 것 같은데
새로운 C도 추가해야겠다.
처럼 동작하는 것을 막고,
이미 검증된 Entity

A
B
C
D

→ 이 Entity 사이에서만 Relation 생성
하도록 제한한다. 이렇게 하면 Entity와 Relation 사이의 불일치나 Hallucination을 줄일 수 있다.
4. 가장 흥미로운 부분 — Entity Consolidation
개인적으로 이 논문에서 가장 흥미로웠던 부분이다.
실제 GraphRAG를 구성하면 동일 Entity가 여러 Chunk에서 반복적으로 발견된다.
예를 들어 다음과 같다.
Chunk 1

OpenAI
"AI research company"


Chunk 17

OpenAI
"Developer of ChatGPT"


Chunk 42

OpenAI
"Artificial intelligence organization"
RAGU에서는 이런 Entity들을 (name, type) 기준으로 먼저 묶는다.
그리고 동일 Entity에 대한 설명이 많이 존재하면 DBSCAN을 사용해 Embedding 기반 Clustering을 수행한다.
대략 다음과 같다.
Entity Mentions
      ↓
Embedding
      ↓
DBSCAN Clustering
      ↓
Similar Descriptions
      ↓
LLM Summarization
      ↓
Consolidated Entity
DBSCAN은 K-Means와 달리 Cluster 개수를 미리 정하지 않아도 되는 Density-based Clustering 알고리즘이다.
따라서 같은 Entity에 대한 여러 설명 중 의미적으로 가까운 내용을 묶은 뒤 LLM으로 하나의 설명으로 통합하기에 적합하다.
Relation 역시 같은 방식으로 정제한다.
결국 RAGU의 Graph Construction은 단순히
LLM → Graph가 아니라,
LLM
 ↓
Entity / Relation Extraction
 ↓
Clustering
 ↓
Deduplication
 ↓
Summarization
 ↓
Graph
구조가 된다.
5. Graph를 만든 뒤에는 Community를 찾는다
정제된 Knowledge Graph가 만들어지고 나면 RAGU는 Leiden Algorithm을 이용해 Community Detection을 수행한다.
예를 들어 Graph가 다음과 같다고 해보자.
Samsung
  │
  ├ SK Hynix
  ├ HBM
  └ Semiconductor

NVIDIA
  │
  ├ GPU
  └ AI
Graph의 연결 구조를 분석해 관련성이 높은 Entity들을 Community로 묶는다.
Community 1

Samsung
SK Hynix
HBM
Semiconductor


Community 2

NVIDIA
GPU
AI
그리고 각 Community에 대해 LLM이
- Title
- Summary
- Findings
형태의 Community Report를 만든다. Microsoft GraphRAG에서 사용하는 Community Summary와 비슷한 아이디어다.
이 과정은 단순히 특정 Entity를 찾는 Local Search뿐 아니라, 문서 전체의 흐름이나 주제를 묻는 Global Search에도 활용할 수 있다.
6. 검색 방식도 하나만 사용하지 않는다
RAGU에는 다섯 가지 Search Engine이 구현되어 있다.
- LocalSearch
- GlobalSearch
- NaiveSearch
- MixSearch
- QueryPlanEngine
LocalSearch
질문과 관련 있는 Entity를 Vector Search로 찾고 해당 Entity와 연결된 Relation과 Chunk를 확장한다.
Question
   ↓
Entity Search
   ↓
Related Entity
   ↓
Relations
   ↓
Chunks
특정 기업이나 기술 사이의 관계를 물어보는 질문에 적합한 방식이다.
GlobalSearch
Graph Community Summary를 이용한다.
예를 들어
이 문서 전체에서 주요 기술 트렌드를 정리해줘.
처럼 특정 Entity보다는 전체 구조를 묻는 질문에 활용할 수 있다.
NaiveSearch
일반적인 Vector RAG 방식이다.
Question
 ↓
Embedding
 ↓
Vector Search
 ↓
Chunks
Graph를 사용하지 않기 때문에 GraphRAG와 일반 RAG를 비교하기 위한 Baseline으로도 사용할 수 있다.
MixSearch
여러 Search Engine을 함께 사용한다.
              ┌ Local Search
Question ─────┼ Global Search
              └ Vector Search
                    ↓
                  Merge
QueryPlanEngine
복잡한 질문을 여러 Sub-query로 나눈 뒤 DAG 형태의 Query Plan을 만든다.
Multi-hop Question이나 여러 조건을 동시에 비교해야 하는 질문에서 활용할 수 있는 구조다.
7. GraphRAG에는 꼭 큰 LLM이 필요할까?
이 논문의 두 번째 핵심 주제다.
저자들은 LLM의 능력을 크게 두 가지로 나누어 본다.
World Knowledge vs. Language Skill
World Knowledge는 모델 내부에 얼마나 많은 사실을 알고 있는지를 의미한다.
반면 Language Skill은
- Context 이해
- Entity Extraction
- Relation Extraction
- Summarization
- Context 기반 Reasoning
등의 능력을 의미한다. GraphRAG에서는 필요한 정보가 이미 검색된 Context 안에 존재하기 때문에, 모델 내부에 많은 지식을 가지고 있는 것보다 주어진 Context를 얼마나 잘 이해하는지가 더 중요하다는 것이 저자들의 주장이다.
이를 확인하기 위해 Qwen2.5 계열의 0.5B부터 72B까지 모델을 비교했다.
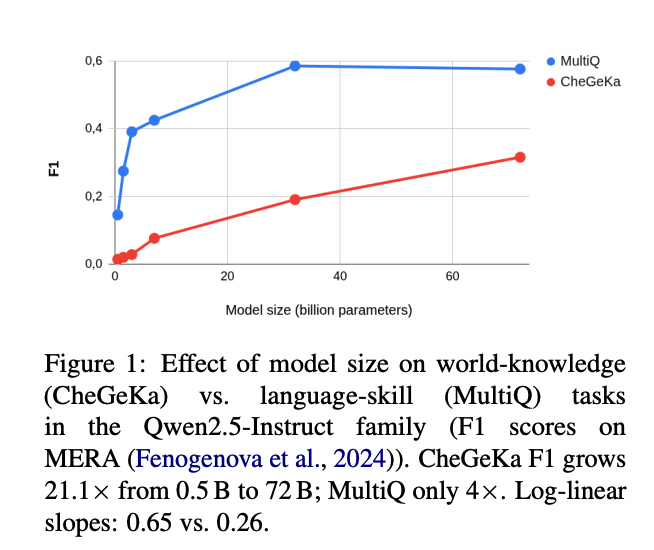
World Knowledge Benchmark에서는 모델 크기가 증가하면서 F1이 약 21.1배 증가한 반면, 모든 정보가 Context 안에 제공되는 Language Skill Benchmark에서는 약 4배 증가하는 데 그쳤다.
즉 모델을 크게 만들었을 때 가장 크게 증가하는 것은 내부 지식이고, GraphRAG에서 필요한 Context 기반 처리 능력은 상대적으로 완만하게 증가한다는 것이다.
8. 그래서 만든 7B 모델 — Meno-Lite-0.1
이 가설을 바탕으로 저자들은 GraphRAG 작업에 특화된 Meno-Lite-0.1을 만들었다.
Meno-Lite-0.1은 7B 모델이며 RuadaptQwen2.5-7B-Lite-Beta를 기반으로 한다.
학습은 크게 두 단계로 진행되었다.
Continued Pretraining

1.3B Tokens
Russian + English
Educational / Scientific Text

        ↓

Supervised Fine-Tuning

50M Tokens
NEREL Extraction
Multi-hop QA
Query Logs
일반적인 LLM처럼 모델 내부 지식을 최대한 많이 학습시키는 것보다, Context가 주어졌을 때 해당 Context를 잘 활용하도록 학습하는 것 에 집중한 모델이다.
9. 7B 모델이 32B 모델보다 Graph Extraction을 잘했다
Knowledge Graph Construction Benchmark 결과도 흥미롭다.
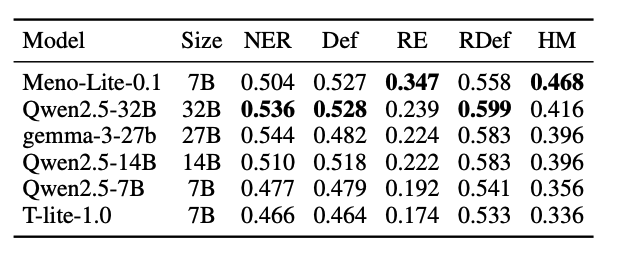
Meno-Lite-0.1은 Qwen2.5-32B보다 전체 Harmonic Mean 기준으로 12.5% 높은 성능을 기록했다. 특히 Relation Extraction에서 차이가 컸다. 즉 특정 작업에 맞게 Fine-tuning된 작은 모델이 단순히 Parameter가 큰 범용 모델보다 Graph Construction에 더 적합할 수 있다는 결과다.
10. 그런데 End-to-End 성능 차이는 다시 줄어든다
더 흥미로운 것은 다음 결과다.
Meno-Lite가 Extraction Benchmark에서는 32B 모델보다 좋은 결과를 보였지만, 전체 GraphRAG QA Pipeline에서는 Extraction 모델에 따른 성능 차이가 크게 줄었다.
논문에서는 Graph Construction LLM을 3B~14B 수준에서 바꿔도 최종 Answer Correctness가 대략 1.5%p 이내에서만 변화했다고 설명한다. 저자들은 이를 RAGU의 Consolidation Pipeline이 Extraction 과정의 Noise를 상당 부분 흡수하기 때문이라고 본다.
즉, 좋은 Extraction Model도 중요하지만,
Extraction
   ↓
Validation
   ↓
Deduplication
   ↓
Consolidation
   ↓
Community Detection
   ↓
Retrieval
이라는 전체 Pipeline의 안정성이 더 중요할 수 있다는 것이다.
11. RAGU가 모든 GraphRAG보다 좋은 것은 아니다
GraphRAG-Bench에서는 RAGU를 LightRAG, HippoRAG 2와 비교한다.
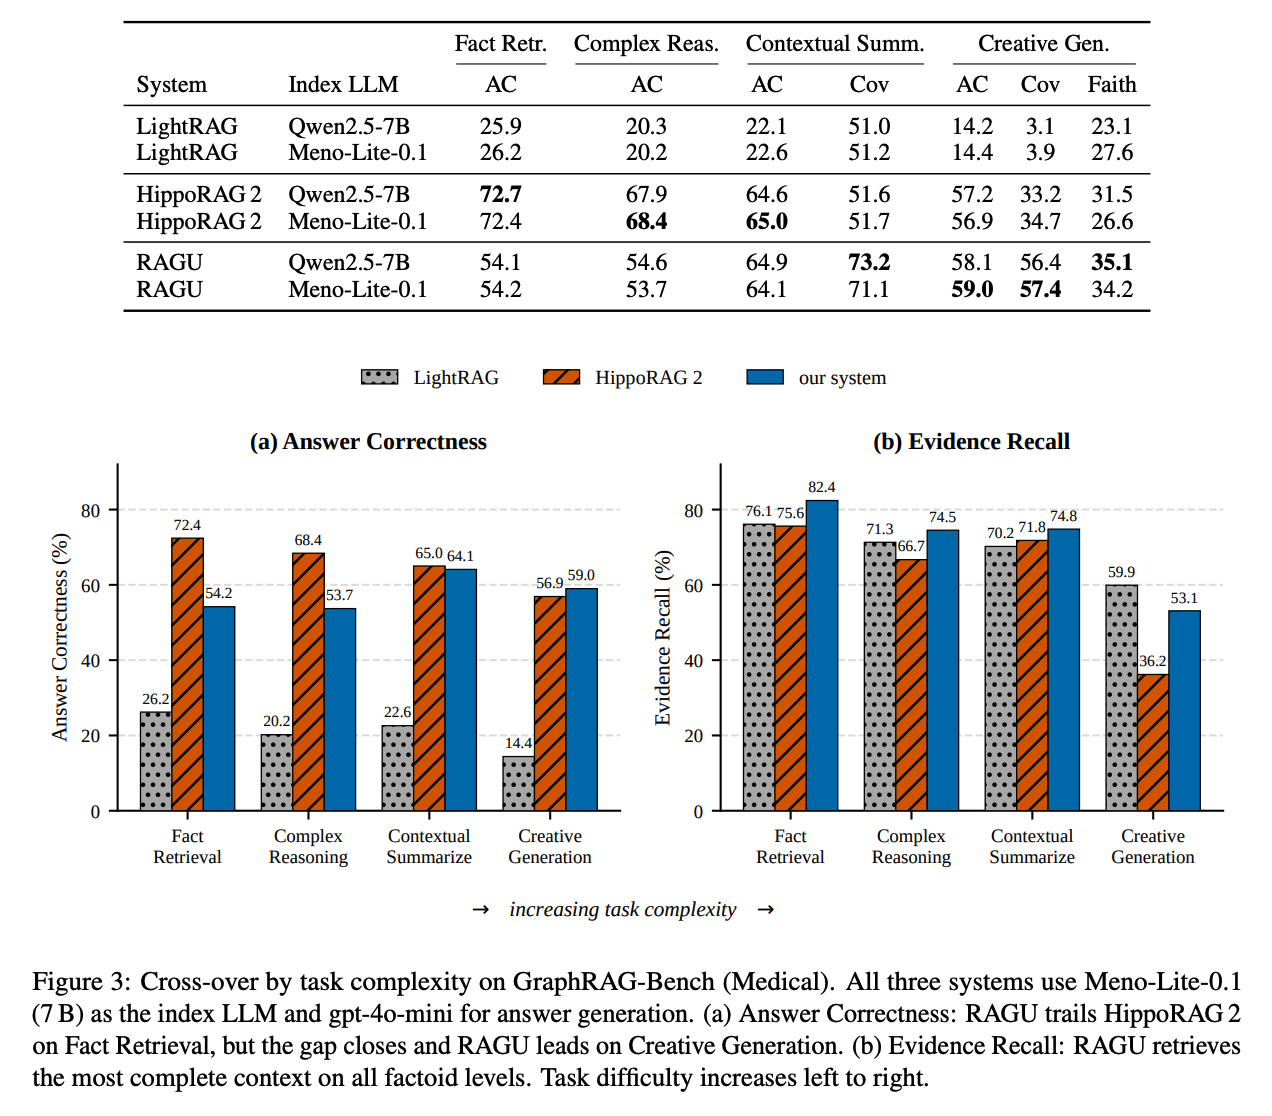
결과를 보면 Task 성격에 따라 강점이 다르다.
단일 Fact Retrieval
HippoRAG 2가 강하다.
HippoRAG 2: 72.4
RAGU:       54.2
HippoRAG 2는 Personalized PageRank를 이용해 Graph의 특정 Chain을 따라가는 데 강하기 때문이다.
Contextual Summarization
이 값은 차이가 거의 없다.
HippoRAG 2: 65.0
RAGU:       64.1
Creative Generation
반대로 RAGU가 앞선다.
RAGU:       59.0
HippoRAG 2: 56.9
Coverage에서도 RAGU가 상당히 높은 결과를 보인다.
RAGU:       57.4
HippoRAG 2: 34.7
즉 특정 Fact를 정확하게 따라가는 질문에서는 HippoRAG가 유리하고, 여러 정보를 넓게 수집하고 종합해야 하는 질문에서는 RAGU가 강한 모습을 보인다.
12. Evidence Recall이 높은 이유
RAGU의 특징이 가장 잘 드러나는 Metric 중 하나가 Evidence Recall이다.
논문에서는 Factoid Level 전반에서 RAGU가 가장 높은 Evidence Recall을 기록했다고 설명한다. 최고 약 0.84 수준이다.
즉 질문에 필요한 근거를 하나 정확하게 찾는 것보다, 관련될 가능성이 있는 근거를 최대한 넓게 가져오는 것 에 강하다.
이 특성 때문에 다음과 같은 질문에서는 RAGU 방식이 상당히 적합해 보인다.
"회사의 주요 위험 요인을 종합적으로 분석해줘."

"이 기업과 연관된 주요 기업과 기술을 찾아줘."

"여러 공시에서 반복적으로 등장하는 리스크를 정리해줘."
이 부분은 기업 공시와 관계 데이터를 다루는 GraphRAG에서도 꽤 흥미로운 특성이다.
13. 실제 구현 관점에서도 꽤 실용적이다
RAGU가 단순 연구용 구조에 그치지 않는다는 점도 눈에 띈다.
Storage Layer를 다음과 같이 세 단계로 나눈다.
Graph Store

Key-Value Store

Vector Store
Backend도 교체할 수 있도록 구성되어 있다.
예를 들어 Graph Store는 NetworkX에서 Neo4j로, Vector Store는 Qdrant로 변경할 수 있다.
또한 다음과 같은 기능도 포함한다.
- Async-first API
- Bounded Concurrency
- Pydantic v2 기반 Structured Output Validation
- Incremental Upsert / Update / Delete
- Deterministic ID
- Consistency Auditor
- 약 374개의 Test
그리고 Meno-Lite-0.1을 사용하면 Single GPU 환경에서도 구동할 수 있도록 설계되어 있다.
14. FinGraph 프로젝트 관점에서 흥미로웠던 부분
FinGraph를 만들면서 처음에는 자연스럽게 다음 구조에 집중했다.
DART 공시
   ↓
Chunking
   ↓
Entity / Relation Extraction
   ↓
Neo4j
   ↓
Graph Retrieval
실제로 GraphRAG를 처음 구현할 때는 Graph DB에 Entity와 Relation을 어떻게 저장하고, Cypher로 어떻게 조회할지에 더 관심이 간다. 그런데 데이터를 계속 쌓는다고 생각하면 결국 그 이전 단계가 더 중요해진다.
LLM Extraction
   ↓
Entity Validation
   ↓
Relation Validation
   ↓
Entity Deduplication
   ↓
Relation Deduplication
   ↓
Entity Summarization
   ↓
Relation Summarization
   ↓
Graph Construction
   ↓
Neo4j
특히 공시 데이터에서는 같은 기업이나 제품, 사업 영역이 여러 보고서에서 반복적으로 등장하기 때문에 Entity Consolidation이 상당히 중요한 문제가 될 수 있다. 예를 들어 같은 Risk가
반도체 수요 감소
메모리 반도체 수요 둔화
글로벌 반도체 시장 침체
처럼 서로 다른 표현으로 등장할 수 있다.
이런 표현을 각각 별도의 Node로 둘 것인지, 의미적으로 묶어 하나의 Risk Entity로 만들 것인지는 Graph 품질에 직접적인 영향을 미친다. RAGU에서 사용한
Entity Mentions
   ↓
Embedding
   ↓
DBSCAN
   ↓
LLM Summary
방식은 이런 문제를 해결하기 위한 하나의 방법으로 참고해볼 만해 보인다.
15. 정리
이번 논문을 한 문장으로 정리하면 다음과 같다.
GraphRAG의 성능을 높이는 핵심은 더 큰 LLM을 사용하는 것이 아니라, Entity와 Relation을 추출한 뒤 정제하고 통합하는 Graph Construction Pipeline을 잘 설계하는 데 있을 수 있다.
RAGU가 제안하는 핵심 흐름은 다음과 같다.
Document
   ↓
Chunking
   ↓
Entity Extraction
   ↓
Relation Extraction
   ↓
Validation
   ↓
Deduplication
   ↓
Summarization
   ↓
Graph Construction
   ↓
Community Detection
   ↓
Community Summarization
   ↓
Local / Global / Mix Retrieval
   ↓
LLM
그리고 GraphRAG 내부에서 사용하는 모델 역시 무조건 클 필요는 없으며, Context를 이해하고 Entity와 Relation을 정확하게 처리하도록 학습된 작은 모델이 충분히 경쟁력을 가질 수 있다는 것도 흥미로운 결과였다.
FinGraph 프로젝트를 진행하면서 지금까지는 Graph를 만들고 Neo4j에서 관계를 검색하는 구조 자체를 구현하는 데 집중했다.
하지만 프로젝트를 마무리하고 나면 RAGU에서 제안한 Entity/Relation Consolidation이나 Community 기반 Retrieval을 일부 적용해서 기존 방식과 비교해보는 것도 한 번 시도해볼 만하겠다는 생각이 들었다.
특히 지금 만들어둔 GraphRAG 구조에 전체를 다시 구현하기보다는,
현재 구조

Entity / Relation Extraction
        ↓
Neo4j
사이에
Deduplication
+
Entity Consolidation
+
Relation Consolidation
단계를 추가하고 검색 성능이 실제로 얼마나 달라지는지부터 비교해보면 꽤 재미있는 실험이 될 것 같다.
나중에 언젠간...해보겟다...ㅋ
참고자료
RAGU 논문: RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM
arXiv: https://arxiv.org/abs/2607.11683
RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM
Graph retrieval-augmented generation (GraphRAG) enhances large language models with structured knowledge, yet existing systems construct knowledge graphs in a single extraction pass, producing noisy entities and brittle retrieval. RAGU, an open-source modu
arxiv.org
RAGU GitHub
https://github.com/RaguTeam/RAGU
GitHub - RaguTeam/RAGU: Modular GraphRAG framework
Modular GraphRAG framework. Contribute to RaguTeam/RAGU development by creating an account on GitHub.
github.com
Meno-Lite-0.1
https://huggingface.co/bond005/meno-lite-0.1
bond005/meno-lite-0.1 · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co
'Side Projects > FinGraph Analyst' 카테고리의 다른 글
| GraphRAG 실전편 — Neo4j 구축부터 Cypher 활용까지 (0) | 2026.08.13 |
|---|---|
| GraphRAG란 무엇인가 — 벡터 검색에 Knowledge Graph를 더하는 이유 (0) | 2026.08.11 |
| 질문하기를 투자 근거로 만들기: FinGraph Analyst 개발기 3편 — 정량 재무데이터 통합 (0) | 2026.08.06 |
| GraphRAG로 질문에 답하기: FinGraph Analyst 개발기 2편 — 하이브리드 검색과 답변 생성 (0) | 2026.08.03 |
| GraphRAG로 기업 공시 읽기: FinGraph Analyst 개발기 1편 — DART 수집부터 그래프 뷰어까지 (0) | 2026.07.30 |


