RAG(Retrieval-Augmented Generation)는 LLM을 활용할 때 익숙한 구조가 됐다.
문서를 청크로 나누고 임베딩한 뒤, 사용자의 질문과 의미적으로 비슷한 문서를 찾아 LLM에 전달한다.
질문
→ Embedding
→ Vector Search
→ 관련 문서
→ LLM
→ 답변
문서 검색이나 사내 지식 검색처럼 질문과 관련된 내용을 찾는 문제에는 잘 맞는다.
그런데 데이터 사이의 관계가 중요한 질문에서는 조금 다른 문제가 생긴다.
예를 들어,
삼성전자와 SK하이닉스는 어떤 관계인가?
라는 질문을 생각해보자.
벡터 검색은 삼성전자와 관련된 문서, SK하이닉스와 관련된 문서를 찾는 것은 잘할 수 있다.
하지만 두 기업이 경쟁 관계인지, 공급 관계인지, 투자 관계인지 자체를 벡터 유사도가 알려주는 것은 아니다.
벡터 검색이 주로 찾는 것은
이 질문과 의미적으로 비슷한 내용은 무엇인가?
이기 때문이다.
반면 관계형 질문에서는
A와 B가 어떻게 연결돼 있는가?
가 중요하다.
이런 정보를 미리 Knowledge Graph로 구조화하고 RAG 검색에 함께 사용하는 방식이 GraphRAG다.
1. 일반 RAG와 GraphRAG의 차이
일반적인 RAG는 다음과 같이 동작한다.
질문
→ Vector Search
→ 관련 Chunk
→ LLM
GraphRAG에서는 검색된 문서에 등장한 엔티티를 기준으로 그래프를 추가로 탐색한다.
질문
→ Vector Search
→ 관련 Chunk
→ 관련 Entity
→ Graph Traversal
→ 관계 + 원문
→ LLM
즉, 벡터 검색을 없애는 것이 아니라 벡터 검색으로 시작점을 찾고, 그래프를 이용해 관계를 확장하는 방식으로 볼 수 있다.
Vector Search와 Graph Search가 담당하는 역할도 다르다.
| 검색 방식 | 역할 |
| Vector Search | 의미적으로 관련된 문서 찾기 |
| Graph Search | 엔티티 사이의 관계 찾기 |
| GraphRAG | 두 검색을 결합해 컨텍스트 확장 |
예를 들어 벡터 검색으로 삼성전자 사업 위험과 관련된 공시 문장을 찾았다면, 그래프에서는 해당 문장에 등장한 삼성전자를 시작점으로 다음과 같은 관계를 탐색할 수 있다.
삼성전자
├─ PRODUCES → HBM
├─ EXPOSED_TO → 경쟁 심화
└─ COMPETES_WITH → SK하이닉스
2. Knowledge Graph는 어떻게 만드는가
GraphRAG를 사용하려면 먼저 문서를 그래프로 변환해야 한다.
그래프는 기본적으로 Node와 Relationship으로 구성된다.
예를 들어 다음 문장이 있다고 해보자.
삼성전자는 HBM3E를 생산한다.
이를 그래프로 표현하면 다음과 같다.
(삼성전자:Company)
        │
        └─ PRODUCES ──▶ (HBM3E:Product)
결국 문서에서 두 종류의 정보를 추출해야 한다.
Entity Extraction
무엇이 개체인가?

+

Relation Extraction
개체 사이에 어떤 관계가 있는가?
전통적인 NLP에서는 NER(Named Entity Recognition)을 이용해 사람, 기업, 장소 등을 추출했다.
GraphRAG에서는 여기서 한 단계 더 나아가 엔티티 사이의 관계까지 함께 추출해야 한다.
3. LLM을 이용해 Entity와 Relation 추출하기
FinGraph Analyst에서는 DART 사업보고서를 Gemini에 전달하고 Structured Output을 이용해 엔티티와 관계를 추출했다.
엔티티 타입은 다음 네 가지로 제한했다.
Company
Person
Product
RiskEvent
관계 역시 처음부터 정해두었다.
INVESTS_IN
SUPPLIES_TO
COMPETES_WITH
EMPLOYS
PRODUCES
EXPOSED_TO
예를 들어 공시에
삼성전자는 메모리 반도체 제품을 생산하고 있다.
라는 내용이 있으면 다음과 같은 결과를 만드는 방식이다.
Entity
삼성전자 / Company
메모리 반도체 / Product

Relation
삼성전자 -[PRODUCES]-> 메모리 반도체
여기서 중요한 것은 엔티티와 관계 타입을 자유롭게 생성하게 하지 않았다는 점이다.
LLM에게 관계 이름을 자유롭게 만들도록 하면,
PRODUCES
MAKES
MANUFACTURES
DEVELOPS
처럼 비슷한 의미의 관계가 계속 생성될 수 있다.
사람이 보면 비슷하지만 그래프에서는 모두 다른 관계다.
그래서 Knowledge Graph를 만들 때는 보통 먼저
어떤 종류의 Node와 Relationship을 허용할 것인가?
를 정의한다.
이를 Graph Schema 또는 Ontology 설계라고 볼 수 있다.
스키마를 좁게 정의하면 검색과 집계가 쉬워지지만 세부적인 의미가 사라질 수 있고, 반대로 너무 넓게 잡으면 그래프 자체가 복잡해진다.
4. 추출한 관계를 Neo4j에 저장하기
추출 결과가 다음과 같다고 해보자.
삼성전자 -[PRODUCES]-> HBM3E
Neo4j에서는 이를 다음 형태로 저장할 수 있다.
(:Company {name: "삼성전자"})
        │
        └─[:PRODUCES]─▶
(:Product {name: "HBM3E"})
Neo4j는 Property Graph 구조를 사용하기 때문에 Node와 Relationship에 추가 정보도 저장할 수 있다.
예를 들어 관계에 다음 정보를 넣을 수 있다.
PRODUCES

evidence_chunk_id
→ samsung_chunk_012
이를 통해 단순히
삼성전자 → PRODUCES → HBM3E라는 관계만 저장하는 것이 아니라,
이 관계를 어느 공시 문장에서 추출했는가?
까지 남길 수 있다.
FinGraph Analyst에서는 엔티티도 원본 청크와 MENTIONED_IN 관계로 연결했다.
Company
→ MENTIONED_IN
→ Chunk
그래서 관계에서 다시 DART 원문까지 추적할 수 있도록 했다.
Relationship
→ evidence_chunk_id
→ Chunk
→ DART 원문
GraphRAG에서 이런 Evidence 연결은 꽤 중요하다.
그래프가 잘못 추출된 경우 실제 원문을 확인할 수 있고, 최종 답변에도 관계의 출처를 함께 보여줄 수 있기 때문이다.
5. 같은 엔티티를 하나로 합치는 문제
기업 공시에는 같은 회사가 여러 번 등장한다.
매번 새로운 노드를 생성한다면,
삼성전자 #1
삼성전자 #2
삼성전자 #3
...
처럼 같은 기업이 수십 개의 노드로 분리된다.
Neo4j에서는 MERGE를 사용해 기존 노드가 있으면 재사용하고, 없으면 생성하도록 할 수 있다.
MERGE (c:Company {name: "삼성전자"})
하지만 실제 문제는 조금 더 복잡하다.
삼성전자
삼성전자주식회사
Samsung Electronics
당사
가 모두 같은 기업을 의미할 수 있기 때문이다.
이처럼 서로 다른 표현이 같은 대상을 의미하는지 판단하고 통합하는 과정을 Entity Resolution이라고 한다.
GraphRAG에서는 이 과정의 품질도 중요하다. 잘못된 엔티티가 만들어지면 이후 그래프 탐색에서도 잘못된 관계가 반복해서 사용될 수 있기 때문이다. 진행한 프로젝트에서는 이 과정을 완벽하게 잡지는 못했다.
6. 검색할 때는 벡터로 찾고 그래프로 넓힌다
그래프를 구축했다면 이제 사용자 질문과 연결해야 한다. FinGraph Analyst에서는 비교적 단순한 방식을 사용했다.
1단계 — Vector Search
먼저 질문을 임베딩하고 의미적으로 가까운 공시 청크를 찾는다.
"삼성전자의 주요 위험요인은?"
        ↓
Vector Search
        ↓
위험·경쟁·시장 환경 관련 Chunk
여기까지는 일반적인 RAG와 같다.
2단계 — Entity 연결
검색된 청크에는 어떤 엔티티가 등장했는지 그래프에서 확인한다.
Chunk A
← MENTIONED_IN
← 삼성전자
벡터 검색 결과가 그래프 탐색의 시작점으로 바뀌는 것이다.
3단계 — Graph Traversal
찾아낸 삼성전자 노드에서 주변 관계를 탐색한다.
삼성전자
├─ EXPOSED_TO → 경쟁 심화
├─ EXPOSED_TO → 시장 불확실성
├─ PRODUCES → HBM
└─ COMPETES_WITH → SK하이닉스
결과적으로 LLM에는 벡터 검색에서 찾은 원문뿐 아니라 그래프 관계도 함께 전달할 수 있다.
7. 왜 1-Hop만 탐색했나
Graph Search에서는 현재 노드에서 몇 개의 관계를 따라갈지를 Hop으로 표현한다.
1-Hop
삼성전자
→ PRODUCES
→ HBM
2-Hop
삼성전자
→ PRODUCES
→ HBM
→ USED_IN
→ AI Accelerator
Hop을 늘리면 더 많은 관계를 발견할 수 있다. 하지만 문제는 검색 범위가 빠르게 커진다는 것이다.
1-Hop
→ 직접 연결된 관계

2-Hop
→ 관계의 관계

3-Hop
→ 관계의 관계의 관계
관계가 늘어날수록 질문과 상관없는 정보도 많이 포함되고, LLM에 전달할 컨텍스트 역시 커진다.
그래서 FinGraph Analyst에서는 우선 1-Hop만 사용했다.
GraphRAG를 고도화한다면 무작정 Hop을 늘리는 것보다
- 관계 타입 필터링
- Entity Ranking
- Path Ranking
- Query Routing
등을 이용해 질문에 필요한 관계만 선택하는 것이 더 중요하다.
8. LLM에는 원문과 그래프 관계를 함께 전달한다
검색이 끝나면 크게 두 종류의 정보가 만들어진다.
첫 번째는 벡터 검색으로 찾은 원문이다.
[공시 원문]

삼성전자 사업보고서
II. 사업의 내용
...
두 번째는 그래프에서 확인한 관계다.
[Graph Relations]

삼성전자 -[EXPOSED_TO]-> 경쟁 심화
삼성전자 -[COMPETES_WITH]-> SK하이닉스
LLM에 둘을 함께 전달하면 어떤 내용이 질문과 관련 있는지 뿐 아니라 그 안의 엔티티가 서로 어떻게 연결되어 있는지 도 함께 제공할 수 있다.
예를 들어 최종 답변은 다음과 같이 만들 수 있다.
삼성전자의 주요 위험요인으로는
업체 간 경쟁 심화와 불안정한 시장 환경이 확인된다.

관계:
삼성전자 -[EXPOSED_TO]-> 업체 간 경쟁 심화

출처:
삼성전자 사업보고서
II. 사업의 내용 > 기타 참고사항
GraphRAG의 목적은 LLM 자체를 바꾸는 것이 아니라 LLM에 전달되는 Context를 더 구조적으로 만드는 것에 가깝다.
9. Neo4j를 사용한 이유
GraphRAG를 구현할 때 반드시 Neo4j를 사용해야 하는 것은 아니다.
Graph 데이터를 저장하고 탐색할 수 있다면 다른 Graph DB를 사용할 수도 있다.
FinGraph Analyst에서는 Neo4j를 사용했다. 하나의 데이터베이스에서 다음 두 기능을 모두 사용할 수 있었기 때문이다.
Vector Index → 의미 기반 검색
+
Property Graph → 관계 기반 탐색
공시 Chunk에는 텍스트와 임베딩을 저장하고,
(:Chunk)

text
embedding
section
document
기업이나 제품은 그래프 관계로 연결했다.
(:Company)
   │
   ├─ PRODUCES → (:Product)
   ├─ EMPLOYS → (:Person)
   └─ EXPOSED_TO → (:RiskEvent)
이를 하나로 연결하면 다음 구조가 된다.
              Vector Search
                    │
                    ▼
                 Chunk
                    ▲
                    │
              MENTIONED_IN
                    │
                 Company
              /      |       \
       PRODUCES  EXPOSED_TO  COMPETES_WITH
           │         │             │
        Product   RiskEvent      Company
이렇게 Vector Search 결과를 바로 Graph Traversal로 연결할 수 있다는 점이 편리했다.
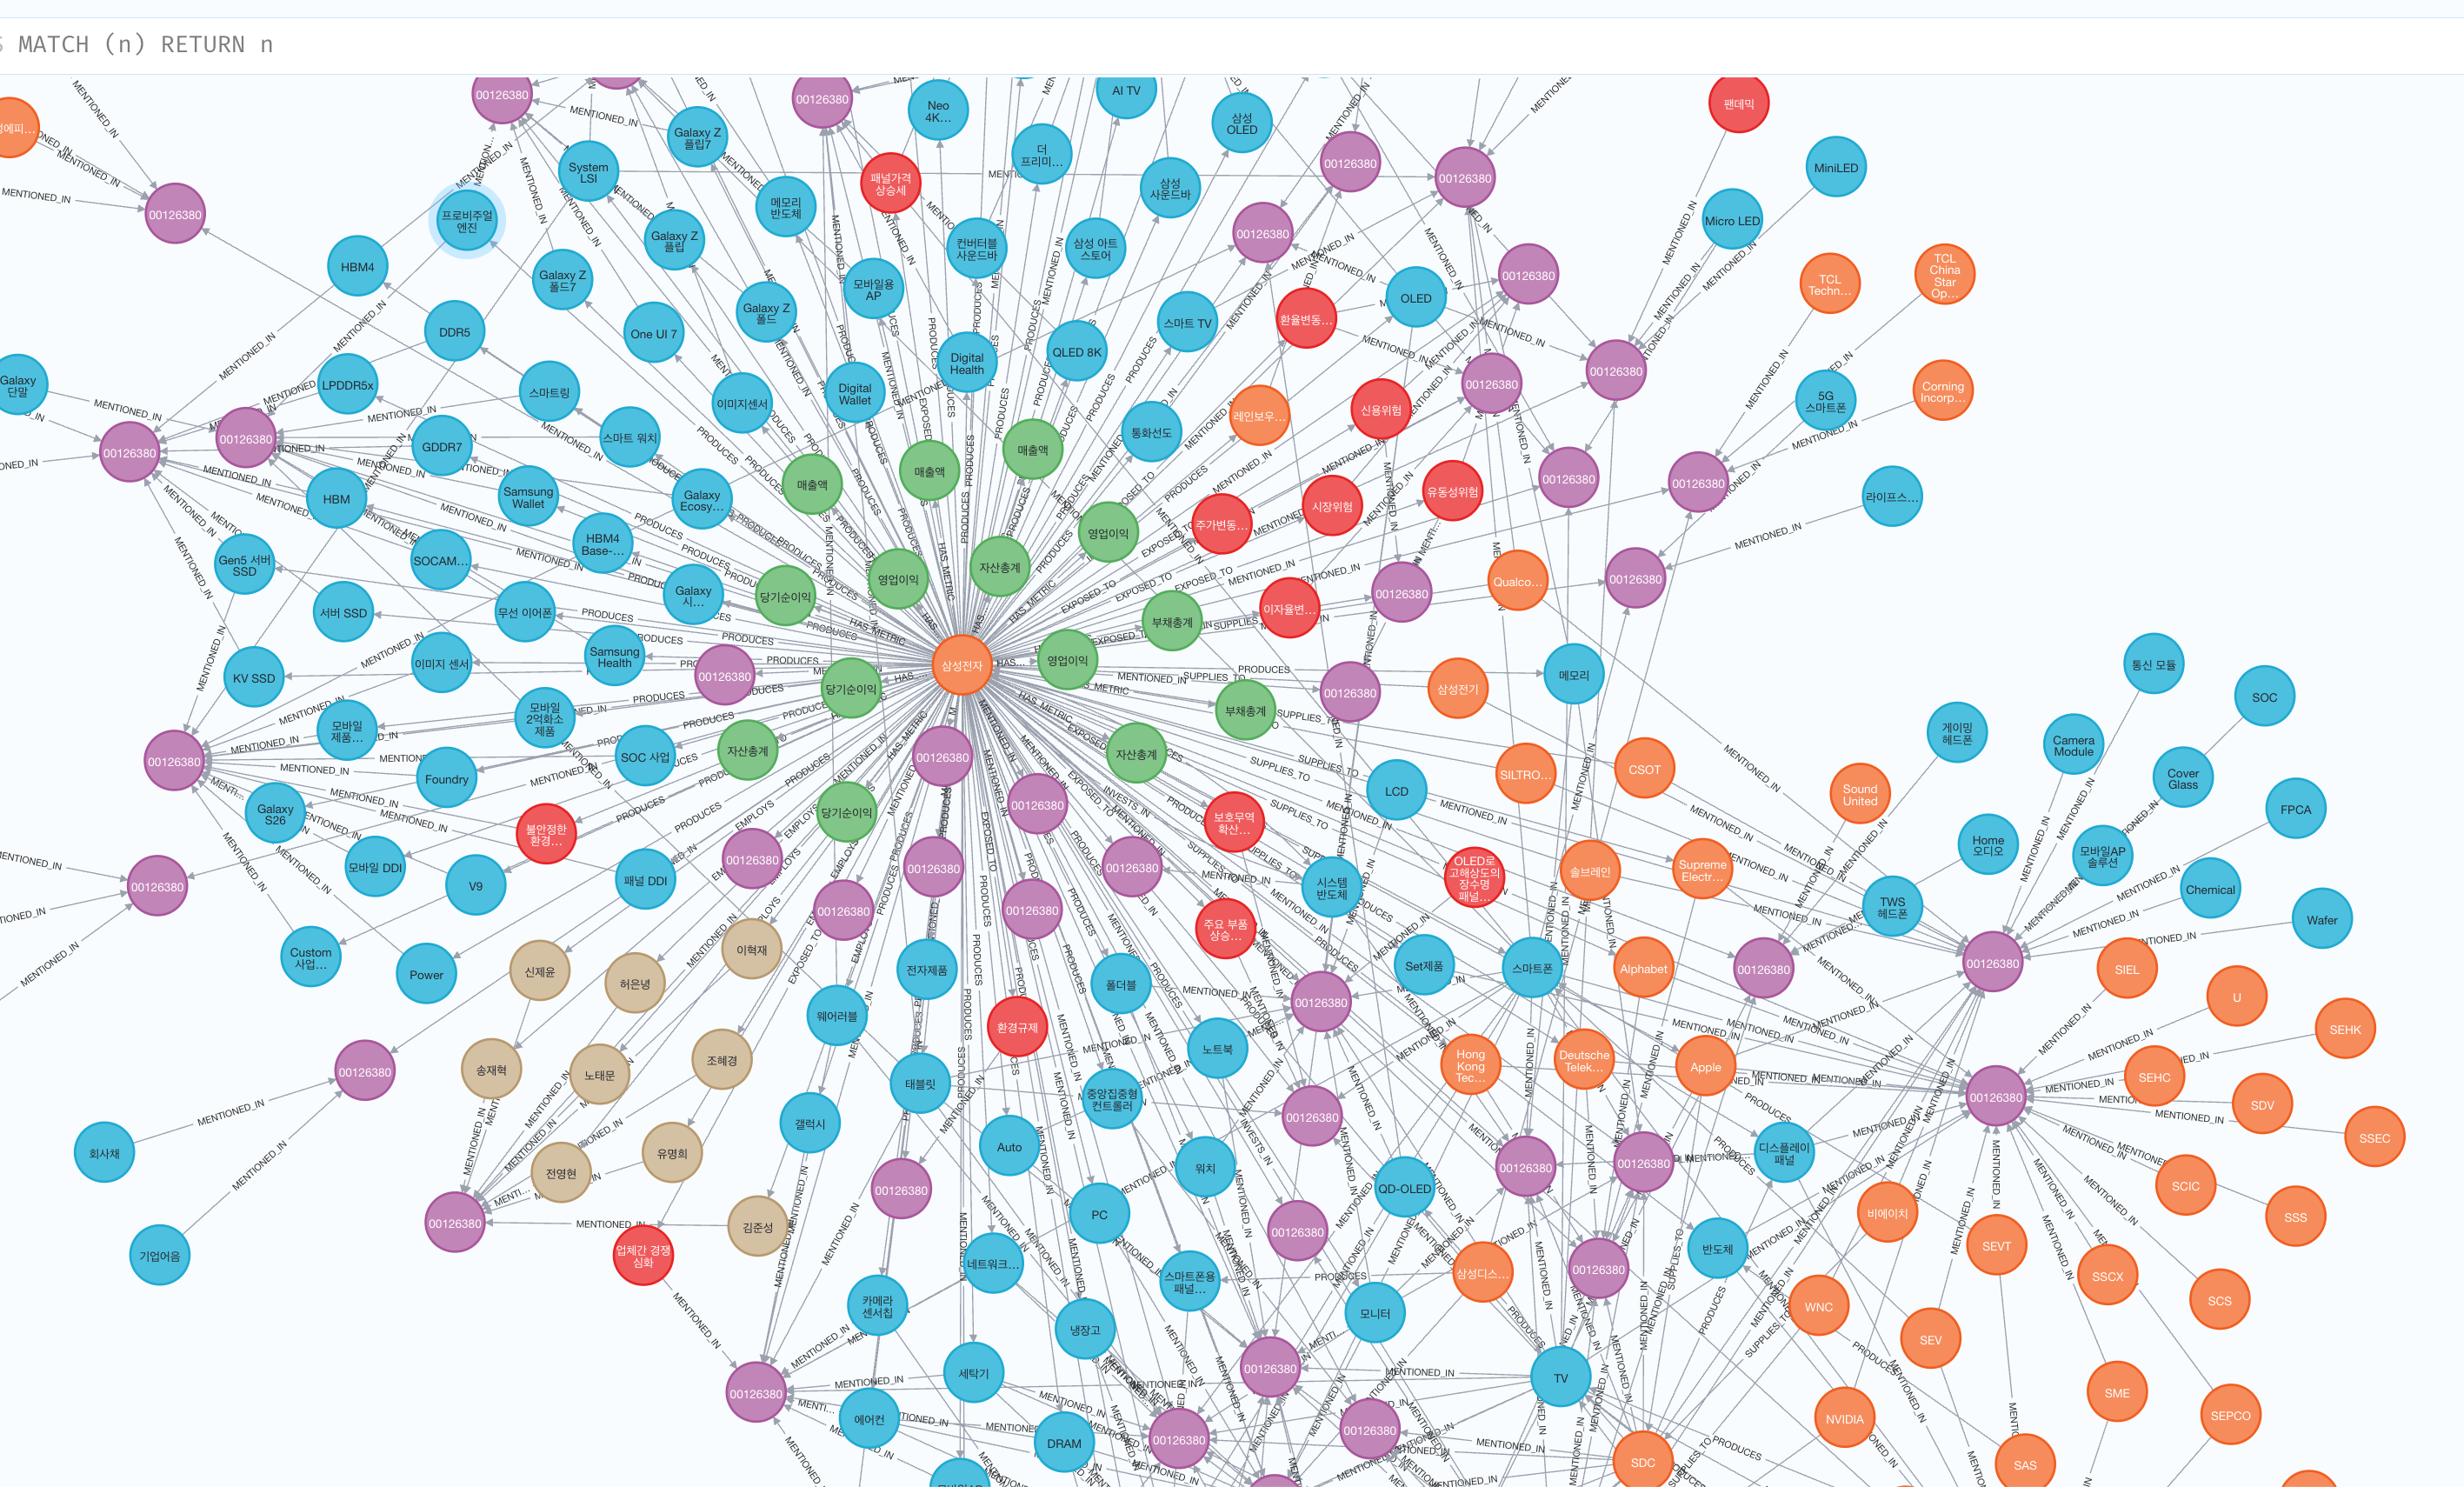
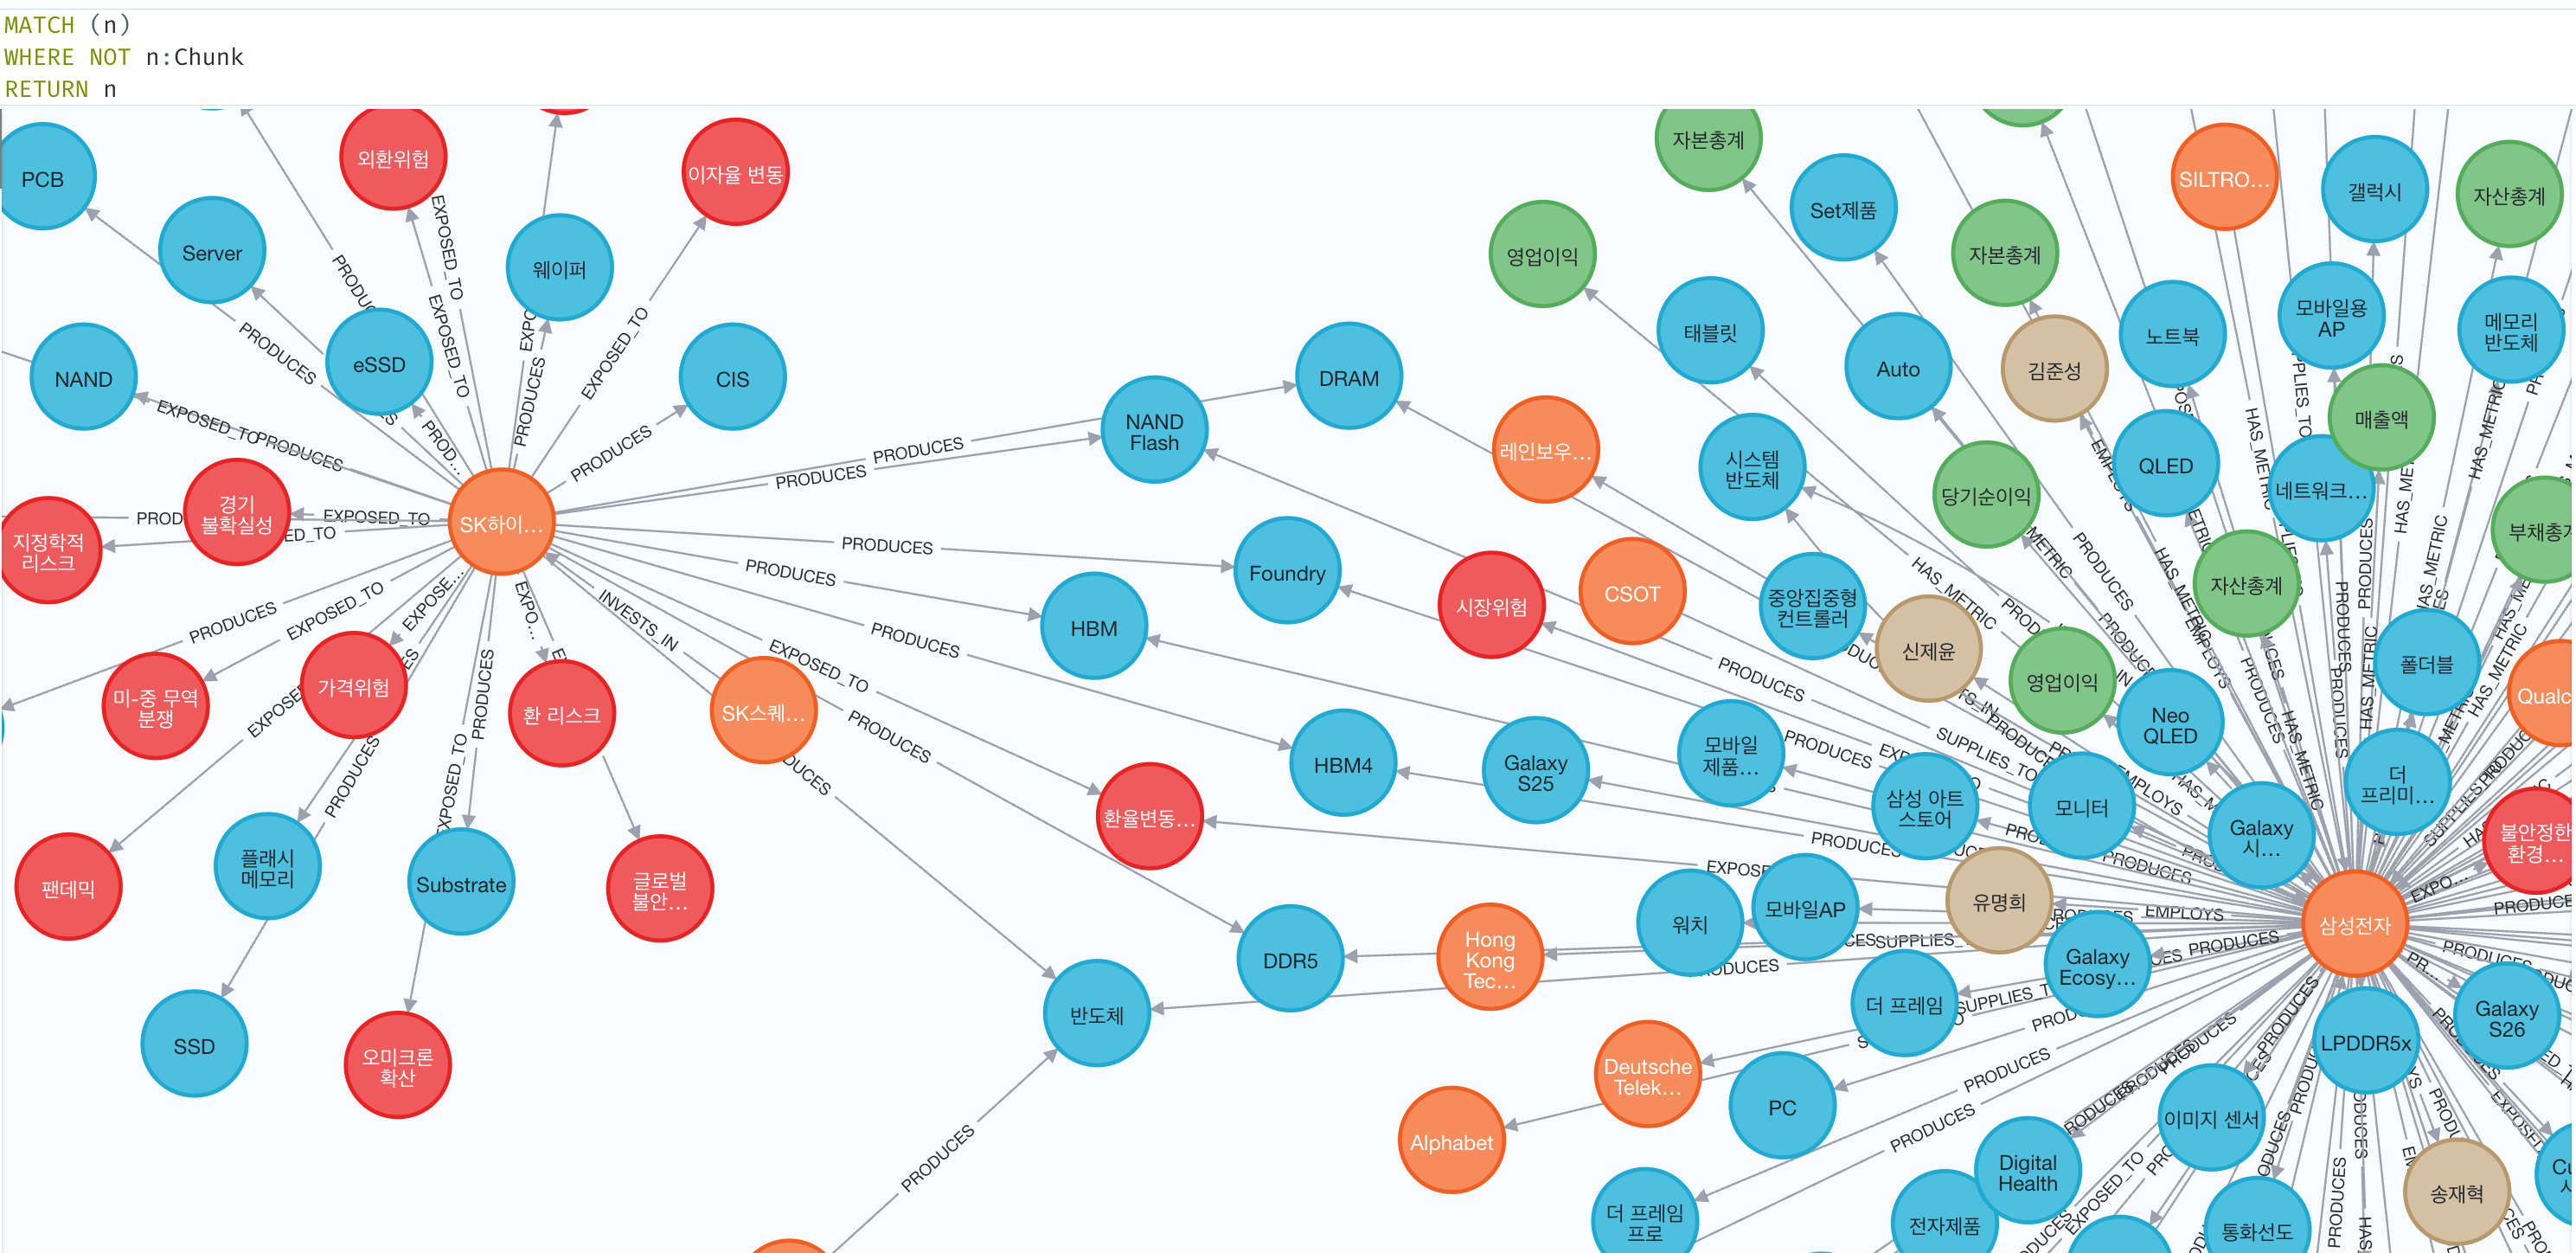
10. 모든 데이터를 그래프로 만들 필요는 없다
GraphRAG라고 해서 모든 정보를 Graph Traversal로 처리할 필요는 없다.
FinGraph Analyst에서는 이후 재무데이터도 다음처럼 그래프에 연결했다.
삼성전자
→ HAS_METRIC
→ 매출액
하지만 사용자가
최근 3년 매출 추이는?
이라고 질문하면 그래프를 탐색할 이유가 크지 않다.
이미 구조화된 정량 데이터이기 때문에 해당 기업의 값을 직접 조회하는 편이 효율적이다.
그래서 최종적으로는 데이터의 성격에 따라 검색 방식을 나눴다.
비정형 Text
→ Vector Search

Entity Relationship
→ Graph Traversal

정형 Financial Data
→ Direct Lookup
GraphRAG는 모든 데이터를 그래프로 만드는 기술이라기보다, 관계가 중요한 정보에 Knowledge Graph를 활용해 RAG의 검색 결과를 보강하는 방식으로 이해하는 것이 더 자연스럽다.
11. GraphRAG의 장점과 한계
GraphRAG의 장점은 관계 중심의 질문을 처리할 수 있다는 것이다.
특히 다음과 같은 문제에 적합하다.
A와 B는 어떤 관계인가?

A와 연결된 기업은 무엇인가?

A → B → C로 이어지는 경로가 있는가?

이 관계는 어느 문서에서 나온 것인가?
서로 다른 문서에 흩어진 정보도 같은 엔티티를 기준으로 연결할 수 있다.
Document A
→ 삼성전자 → Product

Document B
→ 삼성전자 → Risk

Document C
→ 삼성전자 → Competitor
반면 일반 RAG보다 구성해야 할 요소도 많다.
Entity Extraction
Relation Extraction
Schema Design
Entity Resolution
Graph Construction
Graph Traversal
Evidence Management
특히 LLM이 잘못된 관계를 추출하면 오류가 그래프에 구조화되어 저장되고, 이후 여러 질문에서 반복적으로 사용될 수 있다.
그래서 GraphRAG에서는 LLM 성능뿐 아니라
Extraction Quality
Schema Quality
Entity Resolution
Evidence Validation
도 중요하다.
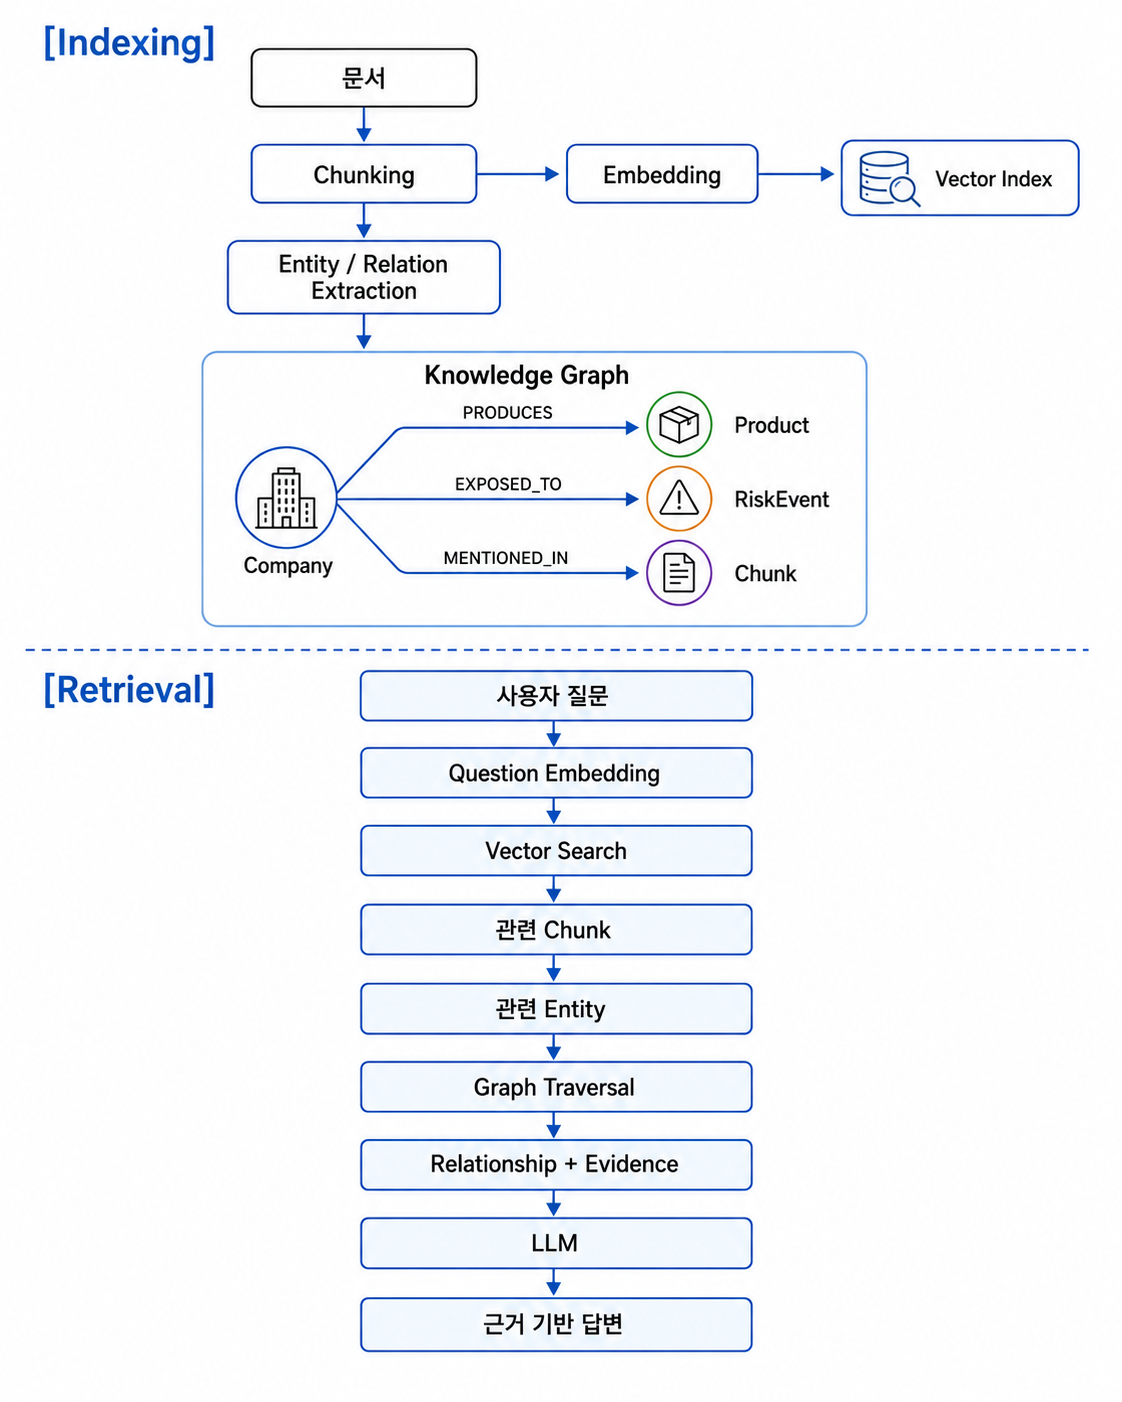
12. GraphRAG 전체 구조
지금까지의 내용을 하나로 연결하면 다음과 같다.
마무리
GraphRAG를 처음 접했을 때는 기존 RAG에 Graph DB를 추가하는 구조 정도로 생각했다.
직접 구현해보니 핵심은 DB의 종류보다 검색하는 정보의 종류가 달라진다는 것에 있었다.
일반적인 Vector RAG가 주로 묻는 것은 어떤 문서가 이 질문과 관련 있는가? 이다.
GraphRAG에서는 여기에 하나가 더 추가된다. 그 문서에 등장한 대상들은 서로 어떻게 연결되어 있는가?
이를 각각 Vector Search와 Knowledge Graph가 담당한다.
Vector Search
→ 무엇이 관련 있는가?

Graph Search
→ 그것들이 어떻게 연결되어 있는가?
그래서 GraphRAG를 한 문장으로 정리하면 다음과 같다.
GraphRAG는 벡터 검색으로 관련 정보를 찾고, Knowledge Graph를 통해 정보 사이의 관계까지 확장해 LLM에 더 구조적인 컨텍스트를 제공하는 RAG 방식이다.
모든 RAG 시스템에 GraphRAG가 필요한 것은 아니다. 단순한 FAQ나 문서 검색이라면 Vector RAG로 충분할 수 있다.
반대로 기업 관계, 공급망, 조직 구조, 논문 인용 관계처럼 정보 사이의 연결 자체가 중요한 문제에서는 GraphRAG의 장점이 커진다.
FinGraph Analyst는 이런 구조를 직접 확인하기 위해 DART 기업 공시를 이용해 구현한 프로젝트다.
'Side Projects > FinGraph Analyst' 카테고리의 다른 글
| GraphRAG는 큰 LLM보다 파이프라인이 중요할까? — RAGU 논문 정리 (0) | 2026.08.19 |
|---|---|
| GraphRAG 실전편 — Neo4j 구축부터 Cypher 활용까지 (0) | 2026.08.13 |
| 질문하기를 투자 근거로 만들기: FinGraph Analyst 개발기 3편 — 정량 재무데이터 통합 (0) | 2026.08.06 |
| GraphRAG로 질문에 답하기: FinGraph Analyst 개발기 2편 — 하이브리드 검색과 답변 생성 (0) | 2026.08.03 |
| GraphRAG로 기업 공시 읽기: FinGraph Analyst 개발기 1편 — DART 수집부터 그래프 뷰어까지 (0) | 2026.07.30 |


