지난 3개월 동안 AI 주식 알람 웹앱을 만들면서 주식 데이터를 수집하고, 뉴스와 가격 정보를 분석해 사용자에게 보여주는 과정을 경험했다.
처음에는 필요한 데이터를 잘 수집하고 LLM에 전달하면 어느 정도 투자 리서치 기능을 만들 수 있을 것으로 생각했다. 그런데 프로젝트를 진행할수록 기업 정보는 각각 떨어진 문서보다 서로 연결된 관계로 봐야 의미가 있다는 생각이 들었다.
예를 들어 다음과 같은 질문이다.
- 특정 기업은 어떤 회사에 투자했는가?
- 어떤 제품을 생산하고 있으며 주요 공급 관계는 어떻게 되는가?
- 경영진과 계열사는 어떻게 연결돼 있는가?
- 특정 위험 요인이 어떤 기업과 사업에 영향을 줄 수 있는가?
일반적인 RAG는 질문과 유사한 문서 조각을 찾는 데는 유용하다. 하지만 기업, 인물, 제품, 투자, 공급 관계처럼 정보 사이의 연결을 따라가야 하는 질문에는 그래프 구조가 더 적합하다.
그래서 이번에는 GraphRAG와 지식그래프를 실제 데이터로 공부해보기로 했다.
프로젝트 이름은 FinGraph Analyst다.
이 후에는 미국기업으로 변경해서 기존 AI 주식 알람과 연결 예정이지만, 국내정보가 검증이 더 쉬우니깐 국내부터 시작. 국내 기업의 공시에서 기업 관계와 주요 이벤트를 추출하고, 그래프 탐색과 벡터 검색을 결합해 투자 리서치 질문에 답하는 에이전트를 만드는 것이 목표다.
이번 글에서는 전체 기능 중 다음 단계까지 진행한 내용을 정리한다.
DART 공시 수집
→ 문서 파싱과 청킹
→ 엔티티·관계 추출
→ Neo4j 적재
→ 그래프 뷰어 구현
아직 질문에 답하는 GraphRAG 검색 기능까지 완성한 상태는 아니다. 이번 편은 그 이전 단계인 공시 문서를 실제 지식그래프로 변환하는 과정에 가깝다.
1. 처음 정한 프로젝트 범위
프로젝트의 목표는 크게 네 가지로 정했다.
- 기업 공시에서 기업, 인물, 제품, 위험 이벤트를 추출한다.
- 추출한 엔티티와 관계를 Neo4j에 지식그래프로 저장한다.
- 벡터 검색과 그래프 탐색을 함께 사용하는 하이브리드 검색을 구현한다.
- LLM이 관계 경로와 원문 근거를 포함해 답변하도록 만든다.
예를 들어 사용자가 다음과 같이 질문하는 구조를 생각했다.
삼성전자가 생산하는 주요 제품과
관련 공급 관계를 공시 근거와 함께 설명해줘.
최종적으로는 단순히 관련 문장을 찾아주는 것이 아니라 다음 정보를 함께 보여주는 것이 목표다.
삼성전자
→ PRODUCES
→ 특정 제품

관계의 출처
→ 삼성전자 사업보고서
→ II. 사업의 내용
→ 관련 원문
현재는 이 구조에서 그래프 구축과 근거 연결까지 구현했다.
2. 기술 스택 결정
학습이 목적이었기 때문에 GraphRAG 프레임워크를 바로 사용하는 대신 각 단계를 직접 연결하는 방식을 선택했다.
| 항목 | 사용기술 | 선택이유 |
| 데이터 | DART 전자공시 | 국내 상장기업의 공식 공시를 수집할 수 있음 |
| 언어 | Python | 문서 처리와 그래프 관련 라이브러리가 다양함 |
| LLM | Gemini API | 구조화 출력과 임베딩, 답변 생성을 하나의 API에서 처리 가능 |
| 그래프 DB | Neo4j | 그래프 탐색과 벡터 인덱스를 함께 지원 |
| UI | Streamlit + pyvis | Python만으로 빠르게 그래프 화면 구현 가능 |
| 개발 도구 | Claude Code | 코드 작성, 테스트, 리팩토링에 활용 |
LangChain이나 LlamaIndex 같은 프레임워크는 이번 단계에서는 사용하지 않았다.
프레임워크가 나쁘기 때문은 아니다. 다만 처음부터 추상화된 기능을 사용하면 다음 과정이 실제로 어떻게 연결되는지 놓칠 수 있다고 생각했다.
문서 수집
→ 청킹
→ 엔티티 추출
→ 관계 생성
→ 그래프 적재
→ 검색
→ 답변 생성
GraphRAG를 공부하는 것이 목적이었기 때문에 적어도 첫 번째 버전에서는 이 흐름을 직접 구현해보기로 했다.
실제 코드는 Claude Code를 사용해 작성했다. 다만 이번 프로젝트에서 더 많은 시간이 필요했던 부분은 코드 문법보다 어떤 엔티티를 추출할지, 관계를 어떻게 제한할지, 근거를 어디에 남길지 결정하는 일이었다.
3. 전체 파이프라인
현재 구현한 파이프라인은 다음과 같다.
DART 사업보고서 수집
        ↓
XML 텍스트 추출
        ↓
섹션 분할 및 청킹
        ↓
Gemini로 엔티티·관계 추출
        ↓
Neo4j 노드와 관계 생성
        ↓
원문 청크와 근거 연결
        ↓
Streamlit 그래프 뷰어
다음 단계에서는 여기에 아래 과정이 추가될 예정이다.
청크 임베딩
        ↓
Neo4j Vector Index
        ↓
벡터 검색 + 그래프 탐색
        ↓
근거 기반 답변 생성
4. 첫 번째 대상은 국내 기업 사업보고서
첫 번째 버전은 국내 기업만 대상으로 시작했다.
데이터는 금융감독원 DART에서 제공하는 사업보고서를 사용했다. 테스트 기업은 다음 세 곳으로 정했다.
- 삼성전자
- SK하이닉스
- 카카오
대형주를 우선 선택한 이유는 사업보고서에 포함된 사업, 제품, 계열회사, 임원 정보가 비교적 풍부하기 때문이다.
처음부터 모든 공시를 수집하지는 않았다. 사업보고서에서도 다음 네 개 챕터만 우선 사용했다.
- 회사의 개요
- 사업의 내용
- 임원 및 직원 현황
- 계열회사 등에 관한 사항
전체 재무제표와 주석까지 포함하면 문서 크기가 급격히 커지고, 현재 정의한 엔티티와 직접 관련이 없는 숫자 데이터도 많아진다.
첫 번째 목표는 재무제표 분석이 아니라 기업 관계 그래프가 실제로 만들어지는지 확인하는 것이었기 때문에 범위를 제한했다.
5. DART XML은 생각보다 단순하지 않았다
DART에서 받은 공시 원문은 XML 형식이다.
처음에는 다음처럼 비교적 단순한 계층 구조라고 생각했다.
SECTION-1
└── SECTION-2
    └── 본문
예를 들어 II. 사업의 내용이라는 대분류 아래에 1. 사업의 개요, 5. 위험관리 및 파생거래 같은 하위 섹션이 들어가는 구조다.
그런데 첫 번째 파서를 만들고 삼성전자 사업보고서를 처리하자 II. 사업의 내용 전체가 사라졌다.
SECTION 사이에 들어 있던 LIBRARY
원인은 일부 문서에서 SECTION-1과 SECTION-2 사이에 LIBRARY라는 태그가 들어가 있었기 때문이다.
SECTION-1
└── LIBRARY
    └── SECTION-2
처음 만든 파서는 현재 섹션의 직계 자식만 확인했다. 따라서 LIBRARY 아래에 있는 하위 섹션을 발견하지 못했다.
이를 해결하기 위해 래퍼 태그 안쪽까지 재귀적으로 확인하도록 수정했다.
그런데 이 수정으로 첫 번째 문제는 해결됐지만, 바로 두 번째 문제가 발생했다.
6. 카카오 사업보고서에서 청크가 1,304개 나온 이유
삼성전자와 SK하이닉스 사업보고서는 각각 약 50개 정도의 청크가 생성됐다.
그런데 카카오 사업보고서를 처리하자 청크가 1,304개 생성됐다.
처음에는 카카오의 공시가 다른 기업보다 훨씬 긴 것으로 생각했다. 하지만 결과를 확인해보니 동일하거나 비슷한 재무 데이터가 대량으로 포함돼 있었다.
원인은 표 안에 중첩된 또 다른 섹션이었다.
SECTION-1
└── TABLE
    └── 자회사 재무제표
        └── SECTION-1
래퍼 태그를 모두 통과하도록 만든 재귀 함수가 표 안의 자회사 재무제표까지 전부 문서 섹션으로 인식하고 있었다.
첫 번째 버그를 해결하기 위해 탐색 범위를 넓혔는데, 너무 넓게 탐색하면서 다른 문서 구조까지 끌어온 것이다.
결국 통과할 수 있는 태그를 LIBRARY로만 제한했다.
_PASSTHROUGH_WRAPPER_TAGS = ("LIBRARY",)
TABLE 계열 태그로는 내려가지 않도록 막은 뒤 카카오 사업보고서도 약 60개의 청크로 정상화됐다.
최종적으로 세 기업에서 총 163개의 청크를 생성했다.
삼성전자
SK하이닉스
카카오

→ 핵심 4개 챕터
→ 총 163개 청크
이 과정에서 가장 먼저 배운 점은 다음과 같다.
문서 스키마를 확인하는 것과 실제 문서가 그 스키마대로 들어오는 것은 다른 문제였다.
스펙만 보고 파서를 완성하려 하기보다, 실제 응답을 저장하고 기업별 문서 구조를 비교하는 편이 훨씬 빨랐다.
7. Gemini로 엔티티와 관계 추출하기
문서를 청크로 분리한 뒤에는 Gemini를 이용해 엔티티와 관계를 추출했다.
첫 번째 버전에서는 엔티티 타입을 네 가지로 제한했다.
| 엔티티 | 의미 |
| Company | 기업, 계열회사, 관계회사 |
| Person | 대표이사, 임원 등 주요 인물 |
| Product | 제품, 서비스, 사업 영역 |
| RiskEvent | 사업 또는 기업에 영향을 주는 위험 요소 |
관계는 다음 여섯 가지로 정의했다.
| 관계 | 의미 |
| INVESTS_IN | 기업이 다른 기업에 투자 |
| SUPPLIES_TO | 제품 또는 부품 공급 관계 |
| COMPETES_WITH | 기업 간 경쟁 관계 |
| EMPLOYS | 기업과 인물의 고용 관계 |
| PRODUCES | 기업이 제품 또는 서비스를 생산 |
| EXPOSED_TO | 기업이 특정 위험에 노출 |
처음부터 관계 타입을 많이 만들지는 않았다.
LLM에 관계 이름을 자유롭게 생성하도록 하면 비슷한 의미의 관계가 여러 종류로 나뉠 수 있다.
MAKES
MANUFACTURES
DEVELOPS
PRODUCES
SELLS
사람이 읽으면 비슷한 관계지만 그래프에서는 모두 다른 엣지가 된다.
따라서 첫 번째 버전에서는 관계 타입을 제한하고, 실제 결과를 보면서 필요한 관계를 추가하기로 했다.
8. 같은 회사가 여러 노드로 분리되는 문제
엔티티를 추출하면서 예상했던 문제가 바로 나타났다.
사업보고서에서 삼성전자는 다음과 같이 여러 표현으로 등장한다.
삼성전자
삼성전자주식회사
당사
회사
이를 그대로 추출하면 Neo4j에는 서로 다른 노드가 만들어질 수 있다.
(삼성전자)
(삼성전자주식회사)
(당사)
실제로는 같은 기업인데 그래프에서는 세 기업처럼 보이는 것이다.
이를 줄이기 위해 프롬프트에 현재 문서의 주체 기업을 명확히 전달했다.
이 문서의 주체 기업은 삼성전자다.
'당사', '회사', '삼성전자주식회사'는
모두 '삼성전자'로 통일한다.
이 규칙만으로 모든 별칭 문제가 해결되는 것은 아니다.
계열회사 이름의 약칭, 영문명, 과거 회사명처럼 더 복잡한 경우에는 별도의 Entity Resolution 과정이 필요하다. Entity Resolution은 서로 다르게 표현된 이름이 실제로 같은 대상을 가리키는지 판단하고 통합하는 과정이다.
이번 버전에서는 주체 기업 이름만 통일하고, 고급 별칭 통합은 이후 범위로 남겨뒀다.
9. 그래프에는 관계뿐 아니라 근거도 필요했다
처음 Neo4j에 적재할 때는 엔티티 노드와 관계만 만들려고 했다.
삼성전자
→ PRODUCES
→ 반도체
하지만 그래프를 보고 있으니 바로 다음 의문이 생겼다.
이 관계는 사업보고서의 어느 문장에서 나온 것일까?
투자 리서치 용도로 사용하려면 LLM이 생성한 관계만 보여주는 것으로는 부족하다. 추출이 잘못됐을 수도 있고, 문맥을 과하게 해석했을 수도 있기 때문이다.
그래서 모든 엔티티를 원본 청크와 MENTIONED_IN 관계로 연결했다.
Company
→ MENTIONED_IN
→ Chunk
기업 간 관계에도 해당 관계를 추출한 청크 ID를 속성으로 저장했다.
삼성전자
→ PRODUCES
→ 특정 제품

evidence_chunk_id
→ samsung_0012
이 구조를 통해 그래프의 관계에서 다시 원문으로 돌아갈 수 있게 했다.
관계 확인
→ evidence_chunk_id 조회
→ 원문 Chunk 확인
→ 공시명, 일자, 섹션 확인
GraphRAG에서 그래프 탐색 결과를 LLM에 전달하더라도 결국 답변의 신뢰성은 원문 근거를 얼마나 잘 연결했는지에 달려 있다고 생각했다.
10. 삼성전자 청크 12개로 먼저 테스트했다
전체 163개 청크를 모두 Gemini에 보내기 전에 삼성전자 청크 12개만 사용해 파이프라인을 확인했다.
처음부터 전체 데이터를 처리하면 문제가 발생했을 때 어느 단계에서 잘못됐는지 찾기 어렵기 때문이다.
테스트 결과는 다음과 같았다.
[Phase 2] 엔티티/관계 추출
12개 청크 처리 완료

[Phase 3] Neo4j 적재
노드 100개
관계 190개
라벨별 노드는 다음과 같이 생성됐다.
Company: 46개
Product: 32개
Person: 9개
RiskEvent: 1개
주요 관계는 다음과 같았다.
PRODUCES: 37개
EMPLOYS: 9개
SUPPLIES_TO: 5개
EXPOSED_TO: 1개
RiskEvent가 한 개밖에 나오지 않은 점은 예상과 달랐다.
처음에는 위험관리 및 파생거래 섹션에서 다양한 위험 요소가 추출될 것으로 생각했다. 하지만 실제 내용은 환율이나 금리 위험을 관리하기 위한 재무적 헤지 설명이 많았고, 현재 정의한 RiskEvent로 분류할 만한 표현은 적었다.
이 부분은 단순히 청크 수가 부족한 문제일 수도 있지만, RiskEvent의 정의와 프롬프트가 지나치게 좁은 것일 수도 있다.
전체 데이터를 처리한 뒤에도 동일한 결과가 나온다면 다음 항목을 다시 검토할 예정이다.
- RiskEvent 정의 확장
- 위험 관련 섹션 별도 프롬프트 사용
- 재무 위험과 사업 위험 분리
- 공시 외 뉴스 이벤트 추가
11. 검색보다 그래프 뷰어를 먼저 만든 이유
원래 계획은 다음 순서였다.
그래프 적재
→ 벡터 검색
→ 그래프 검색
→ 답변 생성
→ UI 구현
하지만 Neo4j에 데이터가 쌓이기 시작하자 중간 결과를 직접 보고 싶어졌다.
Cypher 쿼리로 데이터를 확인할 수는 있지만, 엔티티가 어떻게 연결됐는지 한눈에 파악하기는 어려웠다. 그래서 계획보다 먼저 Streamlit과 pyvis를 이용한 그래프 뷰어를 만들었다.
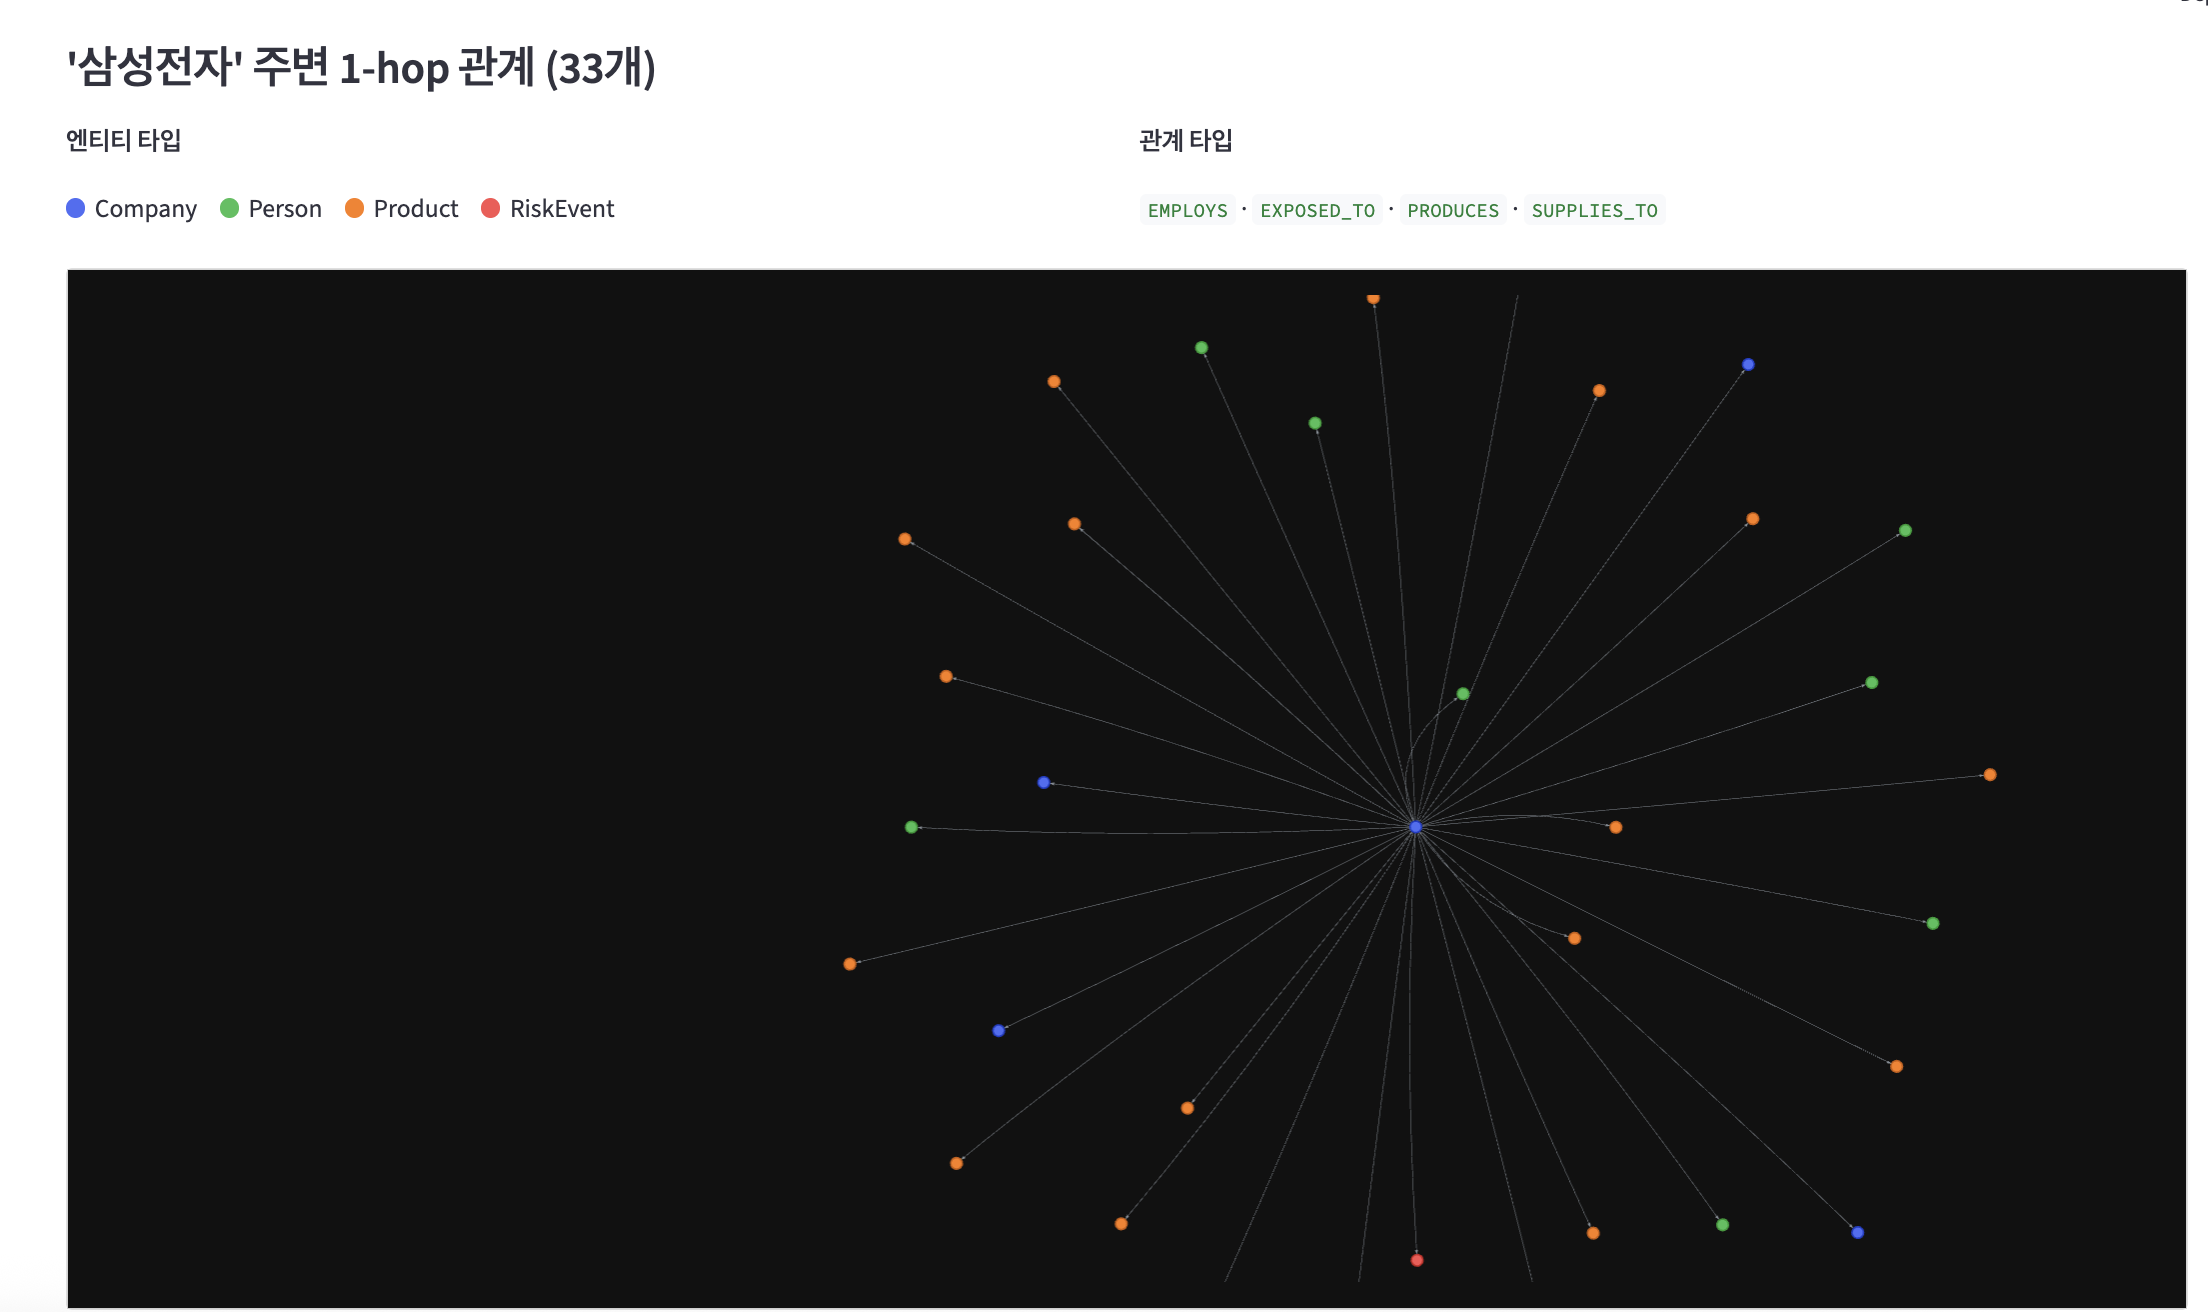
현재 그래프 뷰어에서는 다음 기능을 제공한다.
- 엔티티 타입별 색상 구분
- 엔티티 이름 검색
- 선택한 엔티티의 1-Hop 관계 표시
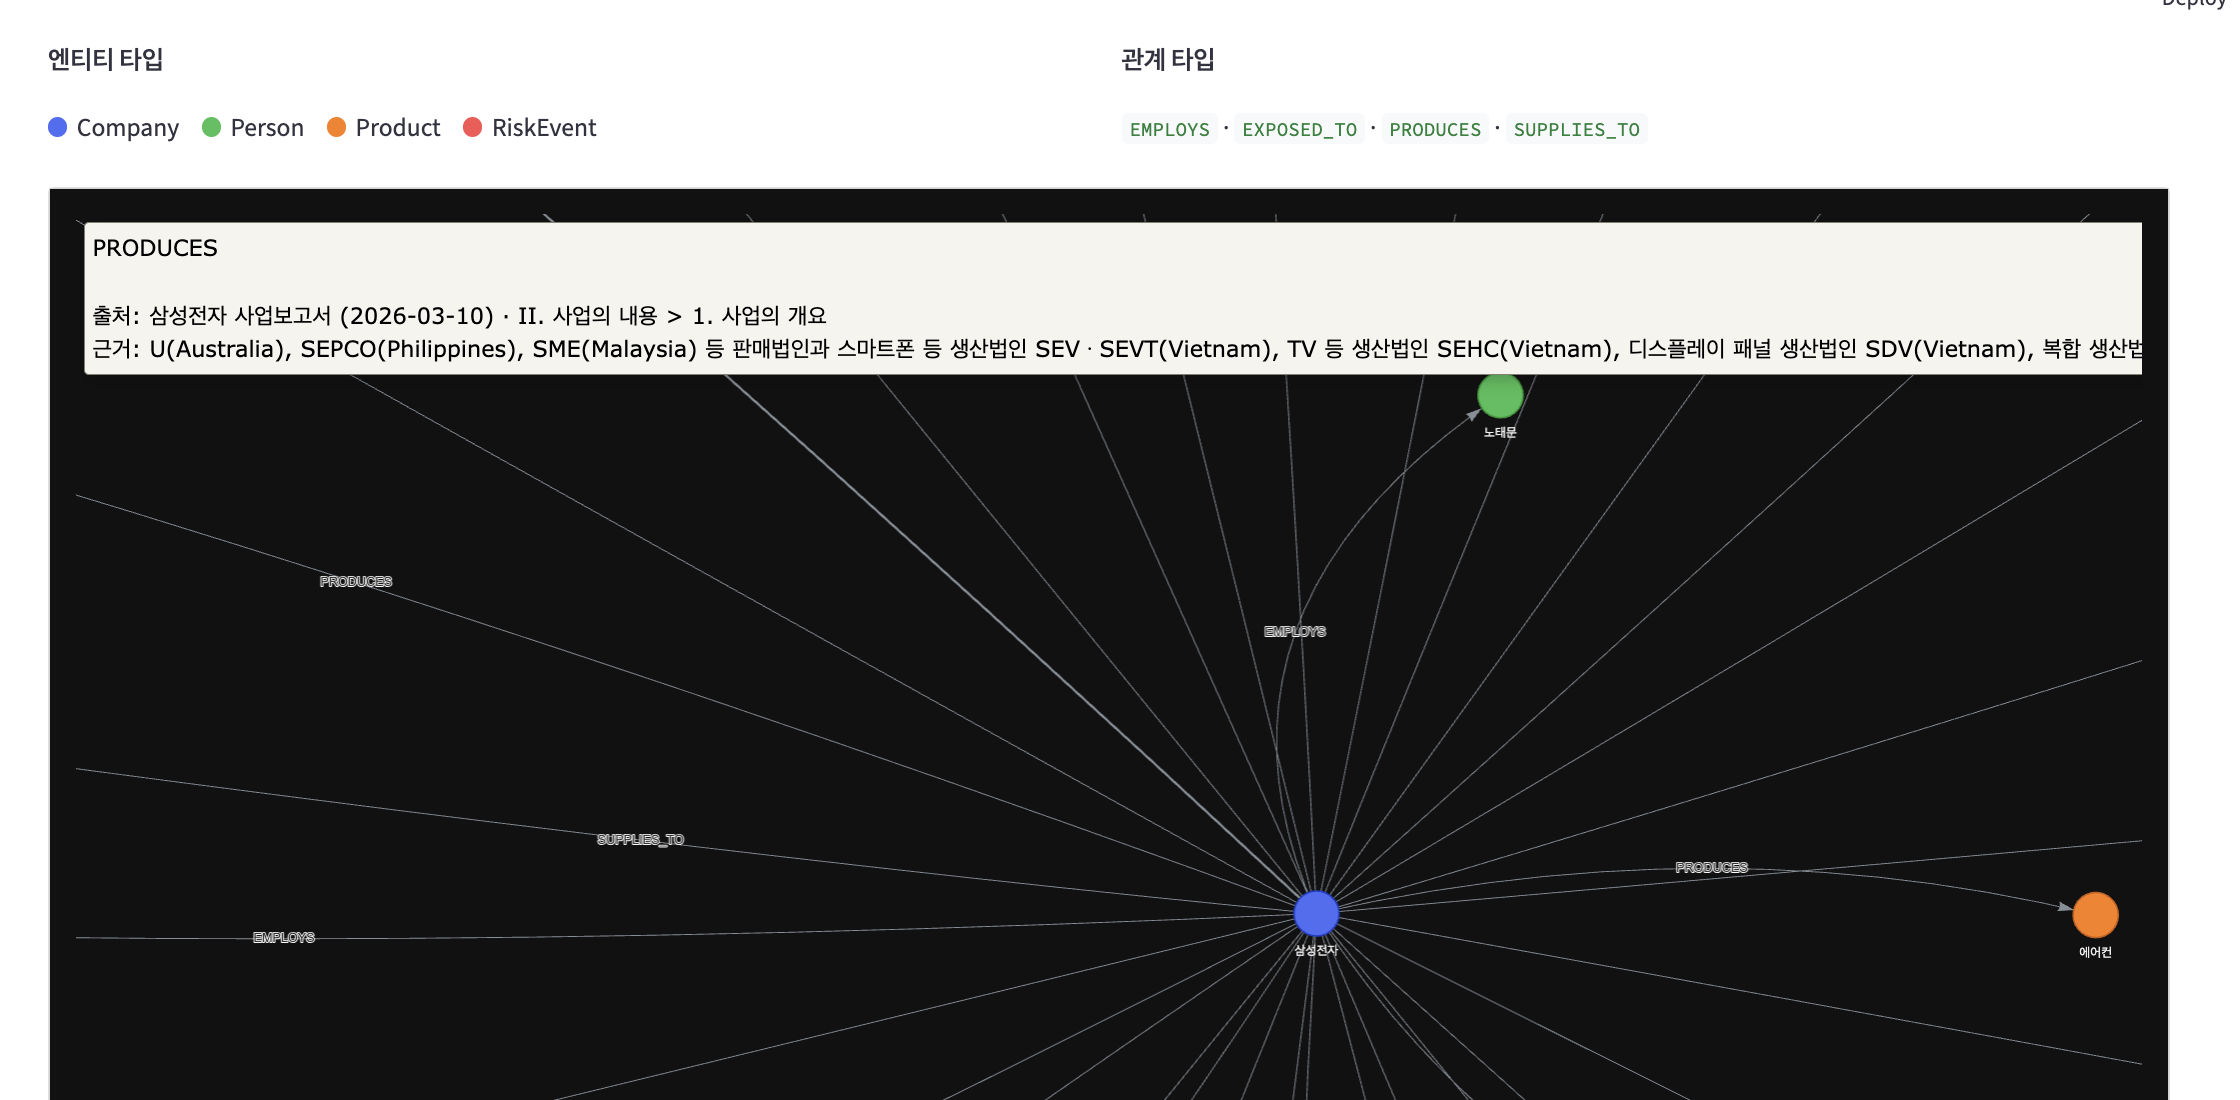
- 엣지에 관계 타입 표시
- 공시명, 공시일, 섹션 정보 표시
- 관계를 추출한 원문 일부 표시
- 현재 화면에 나타난 관계를 표 형태로 제공
예를 들어 특정 기업을 검색하면 직접 연결된 엔티티만 표시한다.
검색: 삼성전자

삼성전자
├── PRODUCES → Product
├── EMPLOYS → Person
├── SUPPLIES_TO → Company
└── EXPOSED_TO → RiskEvent
그래프 전체를 한 번에 표시하면 노드가 많아져 관계를 확인하기 어려워지기 때문에, 현재는 1-Hop 탐색만 지원한다.
12. 그래프에서 바로 원문 근거 확인하기
그래프의 엣지에 마우스를 올리면 다음 정보를 확인할 수 있도록 했다.
그래프 아래에는 현재 화면에 표시된 모든 관계를 표로 정리했다.
Hover 기능만 사용하면 여러 관계의 근거를 비교하기 어렵다. 따라서 그래프는 관계를 탐색하는 용도로 사용하고, 아래 표에서는 출처와 원문을 한 번에 비교할 수 있도록 했다.
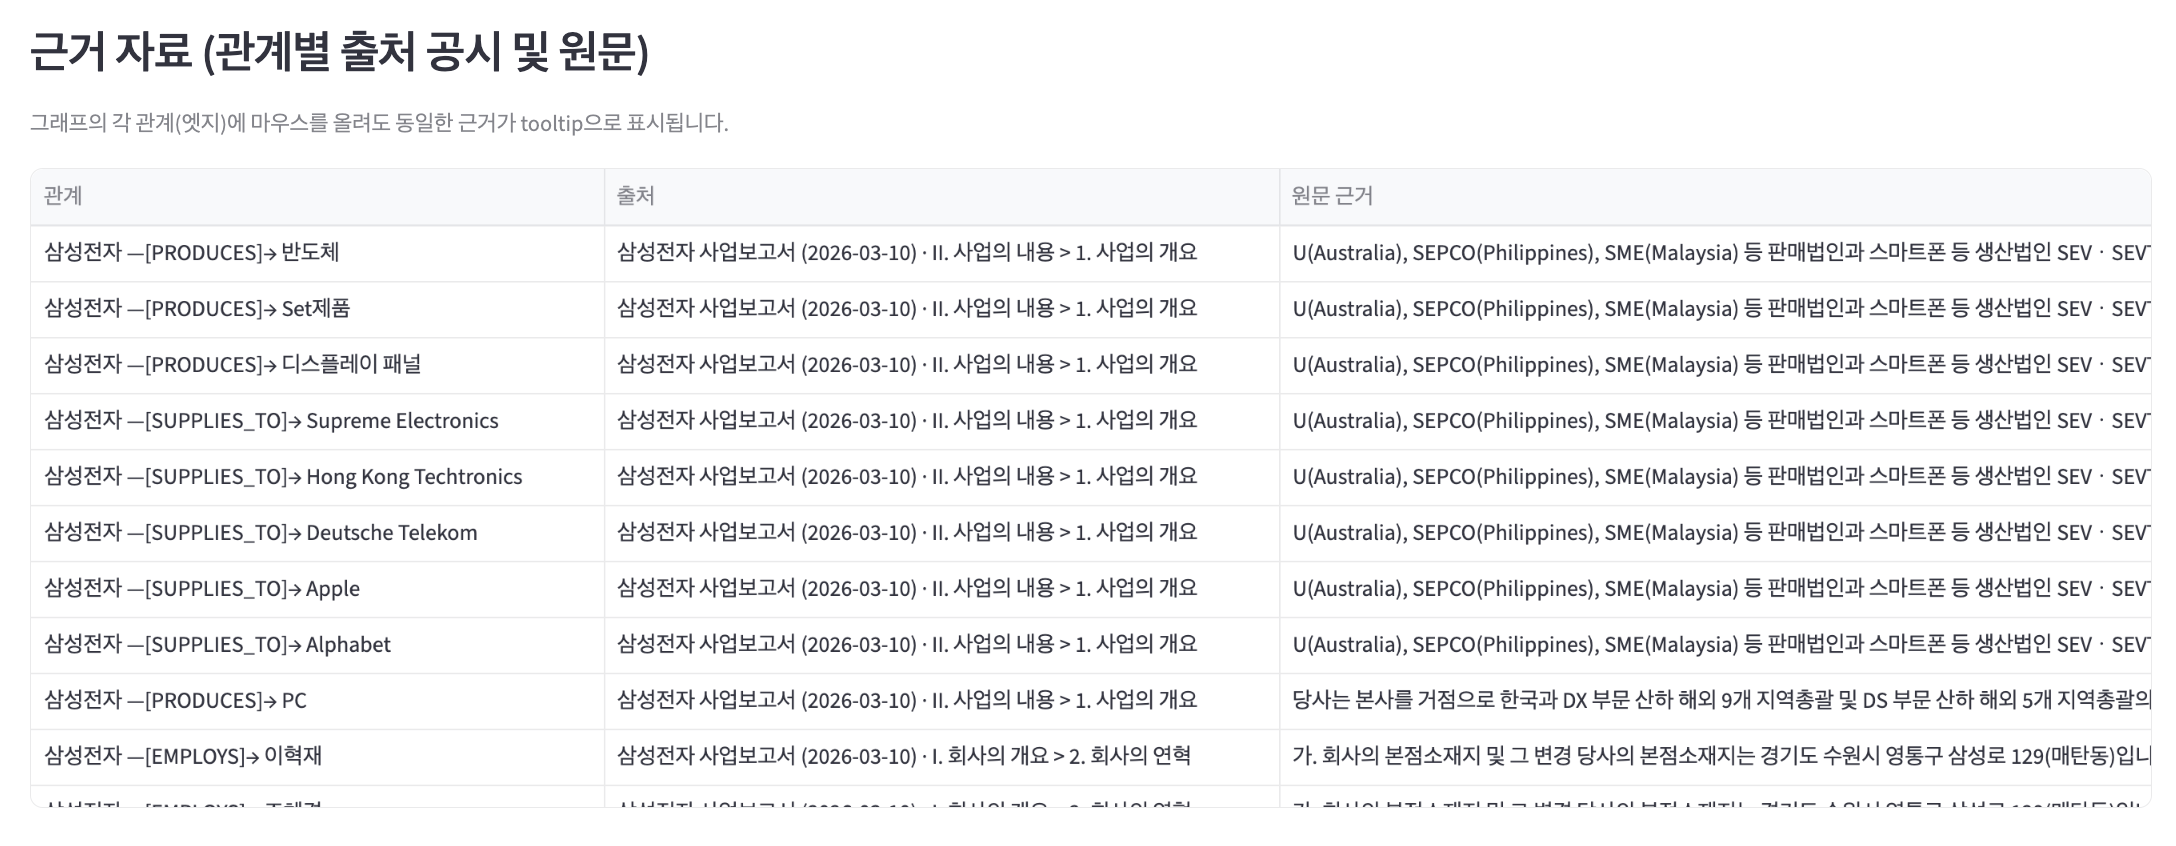
이 기능은 원래 마지막 답변 생성 단계에서 구현하려던 기능이었다.
하지만 실제 그래프를 확인하다 보니, 답변을 생성하기 전에도 근거 확인 기능이 필요했다.
그래프가 시각적으로 그럴듯하게 연결돼 있어도 원문을 읽어보면 관계 방향이 잘못됐거나, LLM이 문장을 과하게 해석한 경우가 있을 수 있기 때문이다.
13. 현재까지 구현한 결과
현재까지 진행한 범위는 다음과 같다.
DART 사업보고서 수집
완료

XML 파싱 및 섹션 추출
완료

삼성전자·SK하이닉스·카카오 청킹
총 163개

Gemini 엔티티·관계 추출
삼성전자 청크 12개 검증 완료

Neo4j 적재
노드 100개
관계 190개

Streamlit 그래프 뷰어
구현 완료
전체 파이프라인 중 현재 위치는 다음과 같다.
[완료] DART 수집
[완료] 파싱과 청킹
[완료] 엔티티·관계 추출 검증
[완료] Neo4j 그래프 구축
[완료] 근거 기반 그래프 뷰어

[예정] 전체 청크 적재
[예정] 벡터 인덱스
[예정] 하이브리드 검색
[예정] 답변 생성
아직 FinGraph Analyst가 투자 질문에 답할 수 있는 단계는 아니다.
현재는 공시 문서가 검색 가능한 지식그래프로 변환되고, 각 관계의 원문 근거를 다시 확인할 수 있는 단계까지 왔다.
14. 다음 단계: 그래프와 벡터 검색 연결하기
다음 작업은 나머지 151개 청크를 처리하고 Neo4j에 전체 데이터를 적재하는 것이다.
그다음에는 각 청크를 임베딩해 Neo4j Vector Index에 저장할 예정이다.
질문이 들어오면 먼저 질문과 의미가 비슷한 청크를 벡터 검색으로 찾고, 해당 청크에 연결된 엔티티와 관계를 그래프에서 확장하는 구조를 생각하고 있다.
사용자 질문
        ↓
Vector Search
관련 Chunk 검색
        ↓
Chunk와 연결된 Entity 확인
        ↓
Graph Traversal
관련 기업·인물·제품 탐색
        ↓
원문 근거와 관계 경로 수집
        ↓
LLM 답변 생성
벡터 검색만 사용하면 질문과 비슷한 문장은 찾을 수 있지만, 해당 기업과 연결된 다른 기업이나 제품까지 확장하기 어렵다.
반대로 그래프 검색만 사용하면 정확한 엔티티 이름이나 탐색 시작점을 먼저 알아야 하는 경우가 많다.
두 방식을 함께 사용하면 벡터 검색으로 시작점을 찾고, 그래프를 통해 관계를 확장할 수 있다.
이 단계까지 연결되면 처음 목표로 정했던 다음 질문을 실제로 테스트할 수 있을 것 같다.
이 기업과 연결된 주요 회사는 어디이며,
어떤 공시 근거로 연결돼 있는가?
마무리
이번 프로젝트를 시작하기 전에는 GraphRAG를 벡터 검색에 그래프 검색을 추가한 구조 정도로 생각했다.
직접 공시 데이터를 넣어보니 검색 이전에 해결해야 할 문제가 더 많았다.
문서 구조의 예외 처리
엔티티 이름 통일
관계 타입 정의
중복 노드 방지
관계 방향 결정
원문 근거 연결
추출 결과 검수
특히 그래프는 LLM이 만든 결과를 그대로 저장한다고 완성되는 것이 아니었다.
어떤 관계를 허용할지 정하고, 같은 대상을 하나의 노드로 통합하고, 잘못된 관계를 확인할 수 있도록 원문을 남기는 과정이 함께 필요했다.
이번에는 삼성전자 청크 12개로 전체 흐름이 동작하는 것까지 확인했다. 다음 글에서는 전체 데이터를 적재하고, Neo4j Vector Index와 그래프 탐색을 결합해 실제 질문에 답하는 하이브리드 검색 과정을 정리해보려 한다.
'Side Projects > FinGraph Analyst' 카테고리의 다른 글
| GraphRAG는 큰 LLM보다 파이프라인이 중요할까? — RAGU 논문 정리 (0) | 2026.08.19 |
|---|---|
| GraphRAG 실전편 — Neo4j 구축부터 Cypher 활용까지 (0) | 2026.08.13 |
| GraphRAG란 무엇인가 — 벡터 검색에 Knowledge Graph를 더하는 이유 (0) | 2026.08.11 |
| 질문하기를 투자 근거로 만들기: FinGraph Analyst 개발기 3편 — 정량 재무데이터 통합 (0) | 2026.08.06 |
| GraphRAG로 질문에 답하기: FinGraph Analyst 개발기 2편 — 하이브리드 검색과 답변 생성 (0) | 2026.08.03 |


