지난 글에서는 DART 사업보고서를 수집하고, 문서에서 기업·인물·제품·위험 이벤트를 추출해 Neo4j 지식그래프로 만드는 과정까지 정리했다.
GraphRAG로 기업 공시 읽기: FinGraph Analyst 개발기 1편 — DART 수집부터 그래프 뷰어까지
지난 3개월 동안 AI 주식 알람 웹앱을 만들면서 주식 데이터를 수집하고, 뉴스와 가격 정보를 분석해 사용자에게 보여주는 과정을 경험했다.처음에는 필요한 데이터를 잘 수집하고 LLM에 전달하
choiscoding.tistory.com
그래프를 직접 탐색하고 관계의 원문 근거를 확인할 수 있는 뷰어도 만들었지만, 아직은 사용자가 엔티티 이름을 직접 검색해야 했다.
이번 단계의 목표는 처음 프로젝트를 시작할 때 생각했던 GraphRAG 구조를 실제로 연결하는 것이었다.
사용자 질문
→ 관련 문서 검색
→ 그래프 관계 탐색
→ 원문 근거 수집
→ 근거 기반 답변 생성
즉, 저장된 그래프를 눈으로 보는 수준을 넘어 자연어 질문을 입력하면 관계 경로와 공시 원문을 함께 이용해 답변하는 기능을 구현했다.
1. 이전 단계에서 부족했던 것
1편이 끝났을 때 파이프라인은 다음 상태였다.
- 삼성전자 사업보고서 일부 청크만 엔티티·관계 추출
- Neo4j 지식그래프 구축
- 엔티티 이름을 기준으로 관계를 탐색하는 그래프 뷰어 구현
- 각 관계와 원문 청크 연결
그래프에 데이터는 들어가 있었지만, 사용자의 질문을 그래프 탐색으로 연결하는 과정은 없었다.
예를 들어 다음과 같은 질문을 입력하더라도,
삼성전자의 주요 위험 요인은 무엇인가?
어떤 엔티티에서 탐색을 시작해야 하는지, 관련 공시 문장은 무엇인지, 그래프의 어느 관계를 답변 근거로 사용할지 정하는 기능이 필요했다.
이번 단계에서는 다음 네 가지를 추가했다.
- 삼성전자 사업보고서 전체 청크 추출 및 적재
- 청크 임베딩과 Neo4j 벡터 인덱스 구축
- 벡터 검색과 그래프 탐색을 결합한 하이브리드 검색
- 관계 경로와 원문 출처를 포함한 답변 생성
2. 전체 청크를 처리하면서 만난 무료 티어 제한
먼저 기존에 일부만 처리했던 삼성전자 사업보고서 전체 청크를 추출했다.
그런데 약 20개 청크를 처리한 시점에 다음과 같은 오류가 발생했다.
429 RESOURCE_EXHAUSTED
Quota exceeded
처음에는 요청을 너무 빠르게 보낸 문제라고 생각했다.
하지만 에러 내용을 자세히 확인해보니 분당 요청 제한인 RPM(Requests Per Minute)이 아니라, 하루 요청 제한인 RPD(Requests Per Day)에 걸린 것이었다.
같은 Gemini Flash 계열이라도 모델마다 무료 사용량 정책이 달랐다. 당시 사용한 모델은 무료 티어에서 하루 생성 요청 수가 매우 적었고, 요청 사이에 대기 시간을 추가하더라도 해결되지 않는 제한이었다.
모델을 상대적으로 제한이 여유로운 경량 버전으로 변경한 뒤에는 분당 요청 제한만 고려하면 됐다. 분당 제한은 일정 시간 뒤 재시도할 수 있기 때문에 전체 파이프라인을 운영하기가 훨씬 수월했다.
이 과정에서 한 가지를 확실히 배웠다.
API의 무료 티어를 사용할 때는 단순히 무료 여부보다 RPM, RPD, 토큰 제한이 각각 어떻게 적용되는지 확인해야 한다.
RPM은 요청 간격과 재시도로 대응할 수 있지만, RPD는 하루 전체 처리량을 제한한다. 문서 수가 많은 파이프라인에서는 두 제한의 차이가 크다.
3. 중간에 멈춰도 이어서 처리할 수 있게 만들기
LLM API를 사용해 수십 개 이상의 문서를 처리하면 한 번의 실행으로 끝난다는 보장이 없다.
다음과 같은 이유로 중간에 멈출 수 있다.
- API Rate Limit
- 네트워크 오류
- 모델 응답 파싱 실패
- 로컬 프로세스 종료
- 일일 사용량 초과
처음부터 다시 실행하면 이미 처리한 청크까지 반복 호출하게 되고, 무료 API 사용량도 낭비된다.
그래서 각 청크의 추출 결과를 로컬 파일에 저장하고, 이미 처리한 chunk_id는 다음 실행에서 건너뛰도록 만들었다.
cached_ids = {item["chunk_id"] for item in cached_results}

chunks_to_extract = [
    chunk for chunk in chunks
    if chunk["chunk_id"] not in cached_ids
]
복잡한 기능은 아니지만, 전체 파이프라인의 안정성에는 큰 차이가 있었다.
결과적으로 삼성전자 사업보고서의 53개 청크를 모두 처리했고, Neo4j 그래프는 다음 규모로 늘어났다.
노드: 286개
관계: 585개
1편에서 일부 청크만 처리했을 때보다 기업, 제품, 인물, 위험 이벤트 간 연결이 훨씬 다양해졌다.
4. 벡터 검색은 왜 필요한가
지식그래프에 기업과 관계가 저장돼 있더라도 사용자의 질문을 바로 Cypher 쿼리로 바꾸기는 어렵다.
예를 들어 사용자는 다음처럼 질문할 수 있다.
삼성전자가 사업적으로 가장 주의해야 할 위험은 무엇인가?
그래프에는 RiskEvent, EXPOSED_TO 같은 구조가 저장돼 있지만 사용자는 그래프 스키마를 알지 못한다.
질문의 표현도 매번 다를 수 있다.
주요 위험 요인은?
사업상 리스크는?
어떤 불확실성이 있는가?
실적에 영향을 줄 요소는?
이 문장들은 표현은 다르지만 비슷한 의미를 가진다.
벡터 검색은 질문과 문서 청크를 의미 기반으로 비교해 관련 가능성이 높은 문서를 찾아준다. 따라서 사용자가 정확한 엔티티 이름이나 관계 타입을 모르더라도 그래프 탐색을 시작할 위치를 찾을 수 있다.
이번 프로젝트에서는 각 공시 청크를 임베딩해 Neo4j에 저장했다.
임베딩은 문장의 의미를 숫자 벡터로 표현한 것이다. 의미가 비슷한 문장일수록 벡터 공간에서도 가까운 위치에 놓이게 된다.
기본 임베딩 차원은 3,072차원이었지만, 이번 데이터 규모에서는 768차원으로 줄여 사용했다.
config={
    "output_dimensionality": 768
}
현재 데이터가 53개 청크 수준이라 저장 공간이나 검색 속도가 큰 문제는 아니지만, 향후 여러 기업의 공시를 추가할 것을 고려해 처음부터 차원을 낮췄다.
5. Neo4j 하나에서 그래프와 벡터 검색 사용하기
일반적인 RAG 시스템은 문서 임베딩을 별도의 Vector DB에 저장한다.
하지만 이번 프로젝트에서는 Neo4j의 Native Vector Index를 사용했다. 따라서 다음 두 종류의 데이터를 하나의 데이터베이스에서 관리할 수 있다.
Chunk.embedding
→ 의미 기반 벡터 검색

Entity -[RELATION]-> Entity
→ 기업 관계 그래프 탐색
벡터 검색 결과로 나온 청크는 이미 MENTIONED_IN 관계를 통해 엔티티와 연결돼 있다.
Entity
→ MENTIONED_IN
→ Chunk
따라서 벡터 검색으로 관련 청크를 찾은 뒤, 별도의 데이터베이스를 조회하지 않고 바로 연결된 엔티티를 따라갈 수 있다.
Neo4j 벡터 인덱스의 구조는 다음과 같다.
CREATE VECTOR INDEX chunk_embeddings IF NOT EXISTS
FOR (c:Chunk) ON (c.embedding)
OPTIONS {indexConfig: {
    `vector.dimensions`: 768,
    `vector.similarity_function`: 'cosine'
}}
임베딩 작업이 끝난 뒤 인덱스 상태를 확인하니 정상적으로 생성됐다.
state: ONLINE
populationPercent: 100.0
6. 하이브리드 검색: 벡터로 찾고 그래프로 확장하기
이번 단계의 핵심은 벡터 검색과 그래프 검색을 연결하는 것이었다.
동작 과정은 크게 두 단계다.
1단계: 벡터 검색
사용자 질문을 임베딩한 뒤, 의미적으로 가장 유사한 공시 청크를 검색한다.
사용자 질문
→ 질문 임베딩
→ 유사 청크 Top-K 검색
예를 들어 다음 질문이 들어왔다고 가정한다.
삼성전자의 주요 위험 요인은 무엇인가?
벡터 검색은 위험, 경쟁, 시장 환경, 가격 변동과 관련된 청크를 찾아낸다.
벡터 검색만 사용하는 일반적인 RAG라면 이 청크들을 LLM에 전달하고 바로 답변을 생성한다.
하지만 FinGraph Analyst는 여기서 한 단계를 더 진행한다.
2단계: 그래프 탐색
검색된 청크에 어떤 엔티티가 연결돼 있는지 확인한다.
관련 Chunk
← MENTIONED_IN
Entity
그다음 해당 엔티티를 시작점으로 주변 관계를 1-Hop 확장한다.
삼성전자
→ EXPOSED_TO
→ 경쟁 심화

삼성전자
→ EXPOSED_TO
→ 불안정한 대외 환경
이 과정을 통해 질문과 직접 유사한 문서뿐 아니라, 해당 문서에 등장한 기업·제품·위험 이벤트가 다른 어떤 관계로 연결돼 있는지도 함께 가져올 수 있다.
7. 일반 RAG와 GraphRAG의 차이
벡터 검색 기반의 일반적인 RAG는 질문과 유사한 텍스트를 찾는 데 강하다.
질문
→ 유사 문서 검색
→ 문서 기반 답변
하지만 문서에 포함된 관계를 명시적으로 탐색하지는 않는다.
예를 들어 한 공시에서는 삼성전자와 특정 제품의 관계가 나오고, 다른 공시에서는 그 제품과 다른 기업의 공급 관계가 나올 수 있다.
벡터 검색만 사용하면 두 문서가 모두 검색되지 않는 한 이 연결을 찾기 어렵다.
GraphRAG는 문서에 등장한 엔티티를 그래프의 시작점으로 사용한다.
질문
→ 관련 문서
→ 문서 속 엔티티
→ 연결된 관계
→ 추가 근거
이번 프로젝트의 하이브리드 검색은 다음 구조다.
Vector Search
질문과 관련된 문서 찾기

+

Graph Traversal
문서 속 엔티티의 관계 확장
벡터 검색은 그래프 탐색을 시작할 위치를 찾아주고, 그래프는 문서 검색만으로 드러나지 않는 관계를 확장한다.
이 조합이 GraphRAG의 핵심이라고 생각했다.
8. 그래프를 많이 확장한다고 좋은 것은 아니었다
초기 테스트에서는 검색된 청크에 등장한 모든 엔티티를 기준으로 1-Hop 관계를 가져왔다.
위험 요인 질문 하나에도 약 175개의 관계가 검색되는 경우가 있었다. 그래프 탐색 결과가 많아지면 관련 정보도 늘어나지만, 다음과 같은 문제가 생긴다.
- LLM에 전달할 컨텍스트가 너무 길어짐
- 질문과 직접 관련 없는 관계 포함
- 중요한 근거가 많은 정보 속에 묻힘
- 답변이 불필요하게 길어짐
GraphRAG는 그래프를 많이 탐색하는 것 자체가 목적이 아니다.
질문에 필요한 관계를 적절한 범위로 가져오는 것이 중요하다.
현재는 1-Hop 탐색을 사용하고 있지만, 이후에는 다음과 같은 개선이 필요할 것으로 보인다.
- 관계 타입 필터링
- 질문과 관계의 관련도 계산
- 중복 관계 제거
- 엔티티별 최대 관계 수 제한
- 벡터 점수와 그래프 점수 결합
- 질문 유형별 탐색 방식 분리
예를 들어 위험 요인을 묻는 질문이라면 EXPOSED_TO 관계를 우선하고, 경영진을 묻는 질문이라면 EMPLOYS 관계에 더 높은 가중치를 줄 수 있다.
9. 답변 생성에서 중요했던 것은 근거 분리
검색 결과를 그대로 LLM에 전달하면 답변은 만들 수 있다.
하지만 이번 프로젝트에서는 단순히 자연스러운 답변을 만드는 것보다 다음 두 가지를 반드시 포함하도록 했다.
- 근거가 된 관계 경로
- 관계가 추출된 공시 원문 출처
LLM에 전달하는 컨텍스트도 두 부분으로 분리했다.
[그래프 관계]

삼성전자
-[EXPOSED_TO]->
업체 간 경쟁 심화


[원문 근거]

삼성전자 사업보고서
2026-03-10
II. 사업의 내용 > 7. 기타 참고사항
관련 원문 일부
관계 경로와 원문을 명확히 분리한 이유는 LLM이 그래프 관계와 원문 내용을 혼동하지 않도록 하기 위해서다.
프롬프트에는 다음 원칙을 넣었다.
제공된 컨텍스트만 근거로 답변한다.

컨텍스트에 없는 정보는 추측하지 않는다.

근거가 부족한 경우 확인할 수 없다고 답한다.

답변에는 관계 경로와 공시 출처를 함께 포함한다.
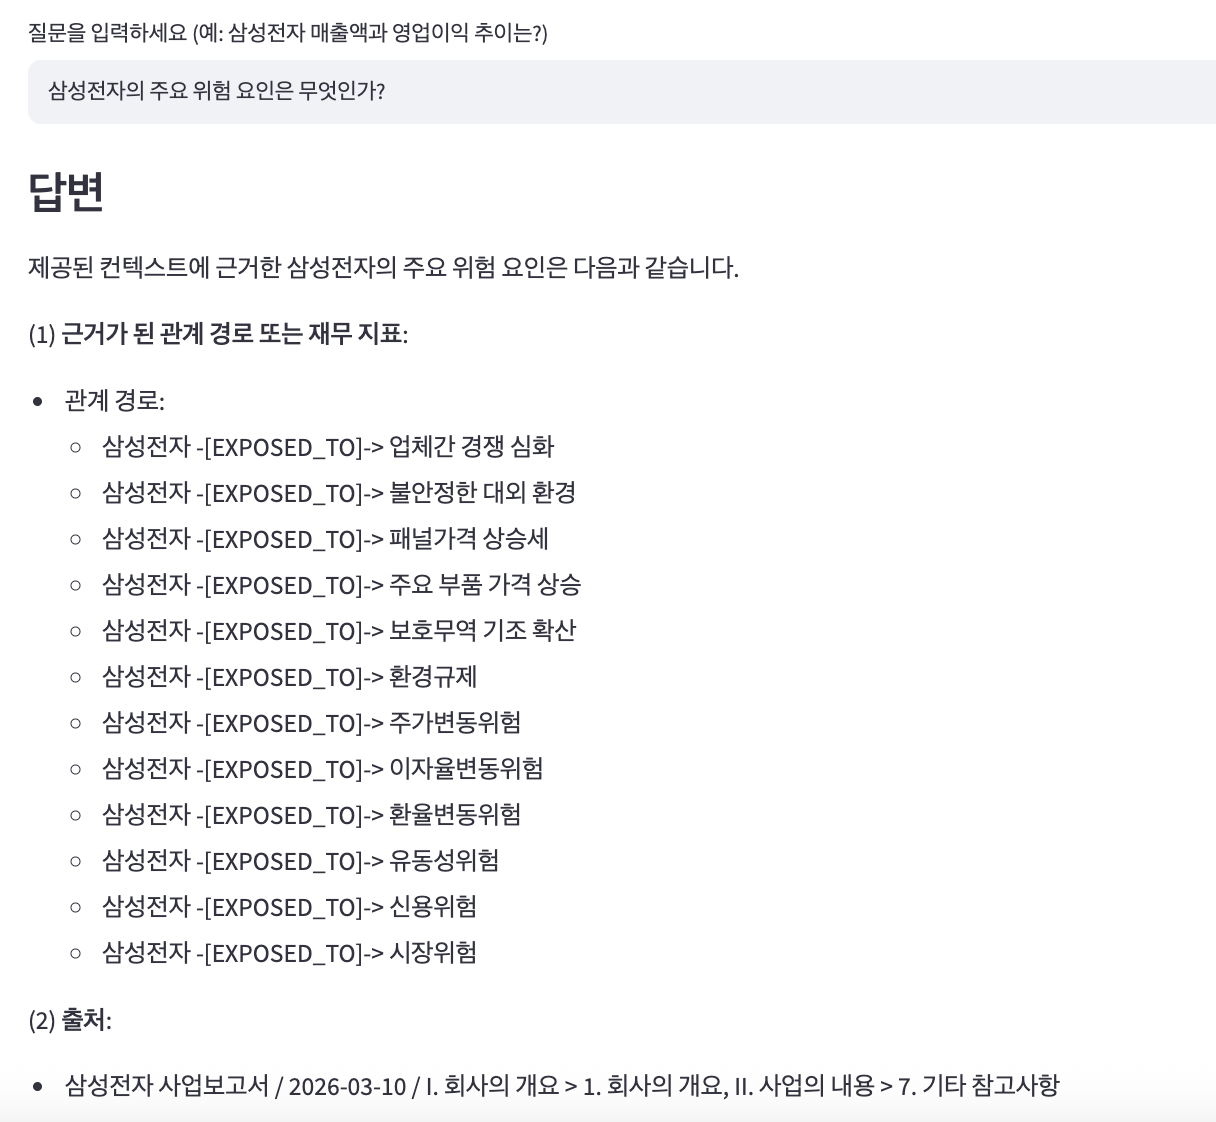
10. 실제 질문 결과
다음 질문으로 테스트했다.
삼성전자의 주요 위험 요인은?
답변은 위험 요인을 요약한 뒤, 각각의 관계 경로와 공시 출처를 함께 제시했다.
주요 위험 요인

- 업체 간 경쟁 심화
- 불안정한 대외 환경
- 패널 가격 상승
그래프 관계는 다음과 같이 표시됐다.
삼성전자
-[EXPOSED_TO]->
업체 간 경쟁 심화

삼성전자
-[EXPOSED_TO]->
불안정한 대외 환경
출처에는 공시명, 공시일, 섹션 정보가 포함됐다.
삼성전자 사업보고서
2026-03-10
II. 사업의 내용 > 7. 기타 참고사항
답변이 자연스럽게 생성되는 것도 중요했지만, 그래프에 저장되지 않은 관계를 임의로 만들어내지 않는지가 더 중요했다.
현재 테스트에서는 관계 경로와 원문 발췌를 분리해 전달하고, 추측 금지 규칙을 명시한 것이 효과가 있었다.
물론 이것만으로 환각이 완전히 사라진다고 볼 수는 없다.
향후에는 생성된 답변의 관계가 실제 Neo4j 검색 결과에 존재하는지 다시 검증하는 후처리도 추가할 수 있다.
11. 답변을 투자 근거로 사용하려면
이번 단계에서 생성한 답변은 공시 내용을 탐색하고 요약하는 데 사용할 수 있다.
하지만 이것을 바로 투자 판단의 근거로 사용하는 것은 어렵다.
현재 그래프에 포함된 정보는 주로 다음과 같다.
- 기업과 계열회사 관계
- 기업과 제품 관계
- 기업과 경영진 관계
- 기업과 위험 이벤트 관계
- 관계가 언급된 공시 원문
반면 투자 판단에는 정량 데이터도 필요하다.
매출
영업이익
부채비율
현금흐름
성장률
밸류에이션
주가 변화
현재 GraphRAG는 정성적인 관계와 공시 문맥을 찾는 데 초점이 맞춰져 있다.
예를 들어 다음 질문에는 답할 수 있다.
삼성전자가 공시에서 언급한 주요 사업 위험은 무엇인가?
하지만 다음 질문에 답하려면 재무 데이터가 필요하다.
이 위험 요인이 최근 실적에 실제로 영향을 줬는가?
그래서 다음 단계에서는 DART의 정량 재무 데이터를 그래프와 연결할 예정이다.
12. Streamlit UI에 질문하기 기능 추가
기존 Streamlit 앱에는 엔티티를 검색하고 그래프를 탐색하는 기능만 있었다.
이번에는 UI를 두 개의 탭으로 나눴다.
st.tabs([
    "엔티티 탐색",
    "질문하기"
])
엔티티 탐색
기존과 동일하게 특정 기업, 인물, 제품을 검색하고 주변 관계를 확인한다.
질문하기
자연어 질문을 입력하면 다음 결과를 보여준다.
생성된 답변

검색된 공시 청크

답변에 사용된 관계 그래프

관계별 원문 근거
질문하기 탭에서도 기존 그래프 렌더링 기능을 그대로 사용했다.
하이브리드 검색이 반환하는 관계 구조를 기존 엔티티 탐색 기능과 같은 형식으로 맞췄기 때문에 별도의 그래프 UI를 새로 만들 필요가 없었다.
source
source_label
rel_type
evidence
target
target_label
처음부터 데이터 반환 구조를 통일해둔 덕분에 검색 방식이 달라져도 동일한 시각화 코드를 사용할 수 있었다.
13. 현재까지 구현 결과
이번 단계까지 구현한 결과는 다음과 같다.
삼성전자 사업보고서
53개 청크 전체 처리

Neo4j 지식그래프
노드 286개
관계 585개

임베딩
768차원

Neo4j Vector Index
ONLINE

하이브리드 검색
구현 완료

근거 기반 답변 생성
구현 완료

Streamlit 질문하기 UI
통합 완료
처음 프로젝트를 시작할 때 정했던 MVP 성공 기준은 다음과 같았다.
사용자가 질문하면 관계 경로와 원문 근거를 포함한 답변을 생성한다.
이번 단계에서 이 기준은 충족했다.
14. 직접 구현하며 정리한 GraphRAG의 구조
이번 프로젝트를 진행하기 전에는 GraphRAG를 벡터 검색에 그래프를 추가한 기술 정도로 이해했다.
실제로 구현해보니 각 검색 방식의 역할은 비교적 분명했다.
벡터 검색
질문과 의미가 비슷한 공시 문서를 찾는다.
질문
→ 관련 문서
그래프 검색
찾은 문서에 등장한 엔티티를 기준으로 관계를 확장한다.
관련 문서
→ 엔티티
→ 관계
원문 근거
그래프 관계가 어느 문장에서 추출됐는지 다시 확인한다.
관계
→ evidence_chunk_id
→ 공시 원문
LLM
검색 결과를 사람이 읽기 쉬운 답변으로 정리한다.
관계 + 원문
→ 근거 기반 답변
결국 이번 프로젝트에서 구현한 GraphRAG는 다음 구조로 정리할 수 있었다.
Vector Search는 시작점을 찾고
Knowledge Graph는 관계를 확장하며
원문 Chunk는 근거를 제공하고
LLM은 이를 답변으로 정리한다.
마무리
이번 단계에서는 FinGraph Analyst에 실제 질문을 입력하고 답변을 생성하는 기능을 추가했다.
단순히 공시 문장을 검색하는 것이 아니라 벡터 검색으로 관련 문서를 찾고, 문서에 등장한 엔티티의 관계를 그래프에서 확장한 뒤, 관계 경로와 원문 출처를 함께 답변에 포함했다.
구현하면서 가장 중요하다고 느낀 부분은 검색 결과의 양보다 답변에 사용된 근거를 다시 추적할 수 있는 구조였다.
그래프가 관계를 보여주더라도 원문이 연결돼 있지 않으면 해당 관계를 신뢰하기 어렵다. 반대로 원문만 검색하면 여러 문서에 흩어진 기업 간 연결을 파악하기 어렵다.
GraphRAG는 이 두 가지를 함께 사용하는 방식이었다.
현재는 공시의 정성적인 내용을 중심으로 답변하고 있다. 다음 글에서는 이 질문하기 기능에 매출, 영업이익, 재무비율 같은 정량 데이터를 연결해 단순 공시 요약이 아니라 실제 투자 분석에 가까운 형태로 확장한 과정을 정리할 예정이다.
'Side Projects > FinGraph Analyst' 카테고리의 다른 글
| GraphRAG는 큰 LLM보다 파이프라인이 중요할까? — RAGU 논문 정리 (0) | 2026.08.19 |
|---|---|
| GraphRAG 실전편 — Neo4j 구축부터 Cypher 활용까지 (0) | 2026.08.13 |
| GraphRAG란 무엇인가 — 벡터 검색에 Knowledge Graph를 더하는 이유 (0) | 2026.08.11 |
| 질문하기를 투자 근거로 만들기: FinGraph Analyst 개발기 3편 — 정량 재무데이터 통합 (0) | 2026.08.06 |
| GraphRAG로 기업 공시 읽기: FinGraph Analyst 개발기 1편 — DART 수집부터 그래프 뷰어까지 (0) | 2026.07.30 |


