최근 몇 년 동안 클라우드 기반 LLM의 성능은 빠르게 발전했다.
나 역시 ChatGPT, Gemini, Claude와 같은 서비스를 사용하면서 클라우드 기반 모델이 주는 편리함과 성능을 직접 경험했다. 별도의 하드웨어를 준비하거나 모델을 최적화하지 않아도 높은 성능의 모델을 바로 사용할 수 있고, 모델이 업데이트될 때마다 더 좋아진 기능을 곧바로 경험할 수 있다는 점은 분명 큰 장점이다.
이러한 서비스를 자주 사용하다 보니, 솔직히 말하면 예전보다 온디바이스 LLM에 대한 흥미는 다소 줄어들었다.
과거에 제한된 디바이스 환경에서 AI 모델을 구동하는 프로젝트에 참여한 경험이있다. 당시에는 모델 크기와 메모리, 추론 속도, 발열과 같은 문제를 하나씩 해결해야 했다. 트레이드 오프로, 성능과 속도를 선택했던 기억이있다. 반면 클라우드 LLM은 이러한 문제를 대부분 서비스 제공자가 처리해 주기 때문에 사용자나 개발자 입장에서는 훨씬 편리하다.
그럼에도 온디바이스 AI 기술이 사라질 것이라고 생각하지는 않는다.
개인정보나 기업 내부 데이터처럼 외부 서버로 보내기 어려운 정보를 처리해야 할 수도 있고, 네트워크 연결이 불안정하거나 인터넷을 사용할 수 없는 환경에서도 AI가 필요할 수 있기 때문이다. 스마트폰뿐 아니라 자동차, 로봇, 드론, 산업 장비와 같은 시스템에서는 서버 연결 없이 즉시 판단해야 하는 상황도 존재한다.
결국 클라우드 LLM과 온디바이스 LLM은 어느 한쪽이 다른 쪽을 완전히 대체한다기보다, 서로 다른 조건에서 필요한 기술로 발전할 가능성이 높다 생각한다.
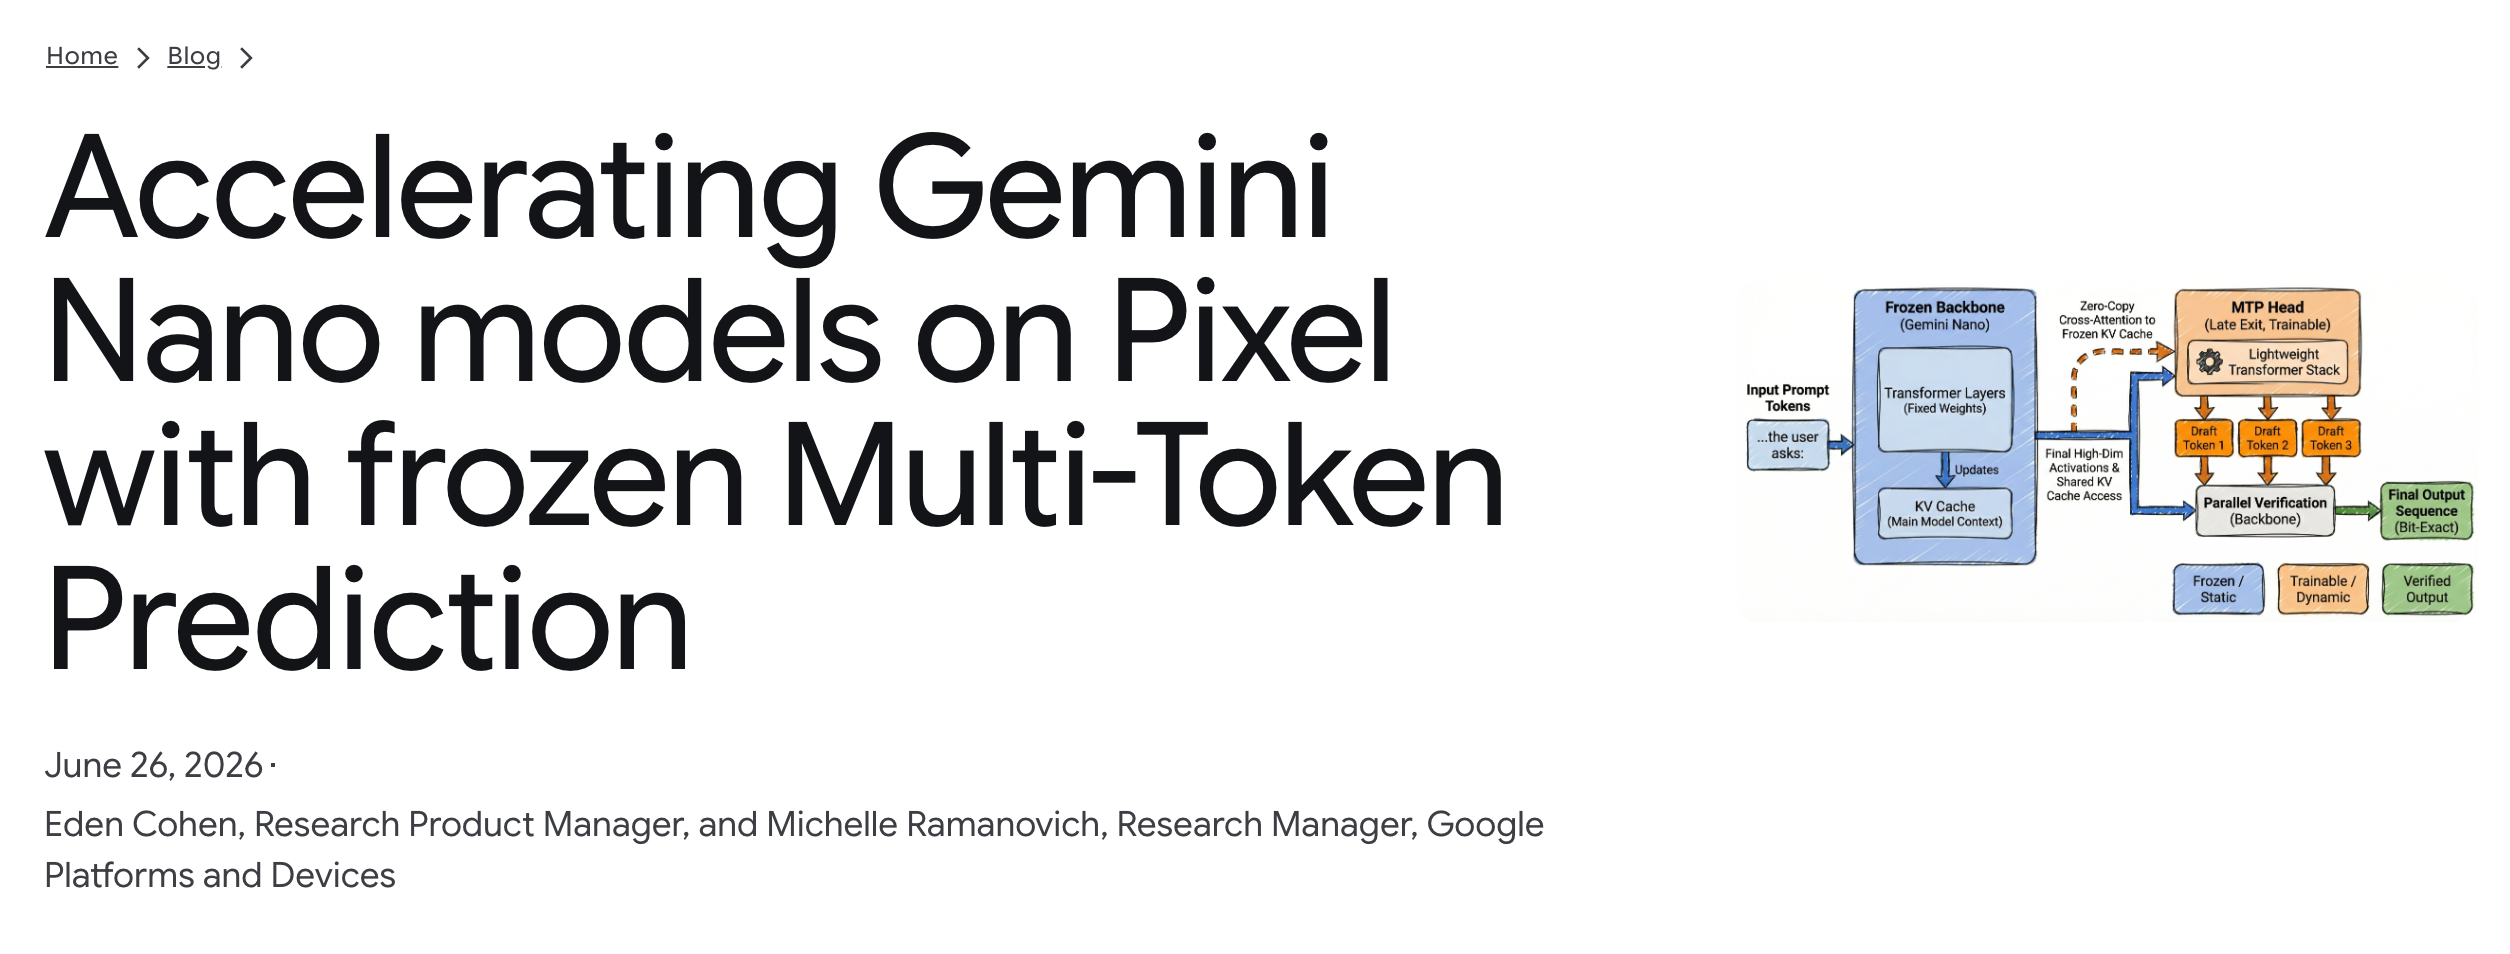
이런 생각을 하던 중 Google Research가 공개한 Frozen Multi-Token Prediction, 줄여서 Frozen MTP 연구를 보게 됐다.
최근에는 모델 성능이 좋아지려면 모델 크기도 커져야 한다는 인식이 자연스럽게 받아들여지고 있다. 실제로 대규모 모델의 성능 향상은 파라미터 수와 연산량, 학습 데이터의 증가와 밀접하게 연결돼 왔다.
그런데 한편으로는 최신 모델의 전반적인 성능이 크게 높아지면서, 그 능력을 더 작은 모델과 제한된 하드웨어에서도 사용할 수 있도록 만드는 연구도 계속되고 있다.
Frozen MTP는 바로 이러한 흐름을 보여주는 연구다.
Google과 Samsung이 확보한 대규모 모바일 AI 환경
이번 연구가 더 흥미롭게 느껴진 이유는 Google이 단순히 연구실에서 모바일 AI를 실험하는 상황이 아니기 때문이다.
Google은 삼성과의 협력을 통해 Gemini를 Galaxy 스마트폰에 적극적으로 통합하고 있다. Galaxy S24에서는 클라우드 기반 Gemini 기능과 함께 온디바이스 작업을 위한 Gemini Nano가 적용됐고, 이후 출시된 Galaxy 기기에서는 Gemini가 삼성의 캘린더, 메모, 리마인더 등과 연결되며 활용 범위가 확대됐다.
Google 입장에서 Galaxy 시리즈는 온디바이스 AI를 대규모 사용자 환경에서 검증할 수 있는 매우 중요한 플랫폼이라고 볼 수 있다.
조금 가볍게 표현하면, Google은 Pixel뿐 아니라 Galaxy라는 꽤 큰 ‘실험 환경’을 확보한 셈이다.
물론 실제 소비자에게 제공되는 제품을 단순한 실험체라고 부르는 것은 정확하지 않다. 다만 수많은 사용자가 다양한 언어와 기능, 하드웨어 환경에서 AI를 사용하기 때문에, 연구 단계의 기술이 실제 제품에서 어떻게 작동하는지 확인할 수 있는 대규모 검증 환경이라는 의미다.
이러한 환경에서는 모델의 정확도만 좋아서는 충분하지 않다.
스마트폰에서 AI 기능이 실제로 사용되려면 다음과 같은 조건도 만족해야 한다.
- 응답이 충분히 빨라야 한다.
- 배터리를 과도하게 사용하지 않아야 한다.
- 메모리 사용량이 제한적이어야 한다.
- 발열이 심하지 않아야 한다.
- 기존 모델의 출력 품질과 안전성이 유지돼야 한다.
Frozen MTP는 이러한 현실적인 모바일 환경의 문제를 해결하기 위한 추론 최적화 기술이다.
스마트폰의 LLM은 왜 느릴까?
일반적인 언어 모델은 문장을 한 번에 완성하지 않는다.
먼저 하나의 토큰을 생성하고, 방금 생성한 결과를 다시 입력으로 사용해 다음 토큰을 생성한다.
예를 들어 다음 문장을 만든다고 생각해 보자.
오늘 날씨가 정말 좋습니다.
모델은 실제로 다음과 비슷한 순서로 문장을 생성한다.
오늘 → 날씨가 → 정말 → 좋습니다
이처럼 앞에서 생성한 결과를 바탕으로 다음 토큰을 하나씩 만드는 방식을 자기회귀 생성, Autoregressive Generation이라고 한다.
문제는 토큰 하나를 만들 때마다 모델을 반복해서 실행해야 한다는 것이다.
서버에서는 강력한 GPU와 충분한 메모리를 사용할 수 있지만, 스마트폰은 RAM과 메모리 대역폭, 전력, 발열에 제약이 있다. 따라서 모델을 여러 번 실행하는 구조는 응답 속도뿐 아니라 배터리 사용량에도 부담을 줄 수 있다.
여러 토큰을 미리 만드는 Speculative Decoding
이 문제를 해결하기 위해 사용되는 대표적인 기술이 Speculative Decoding, 즉 추측 디코딩이다.
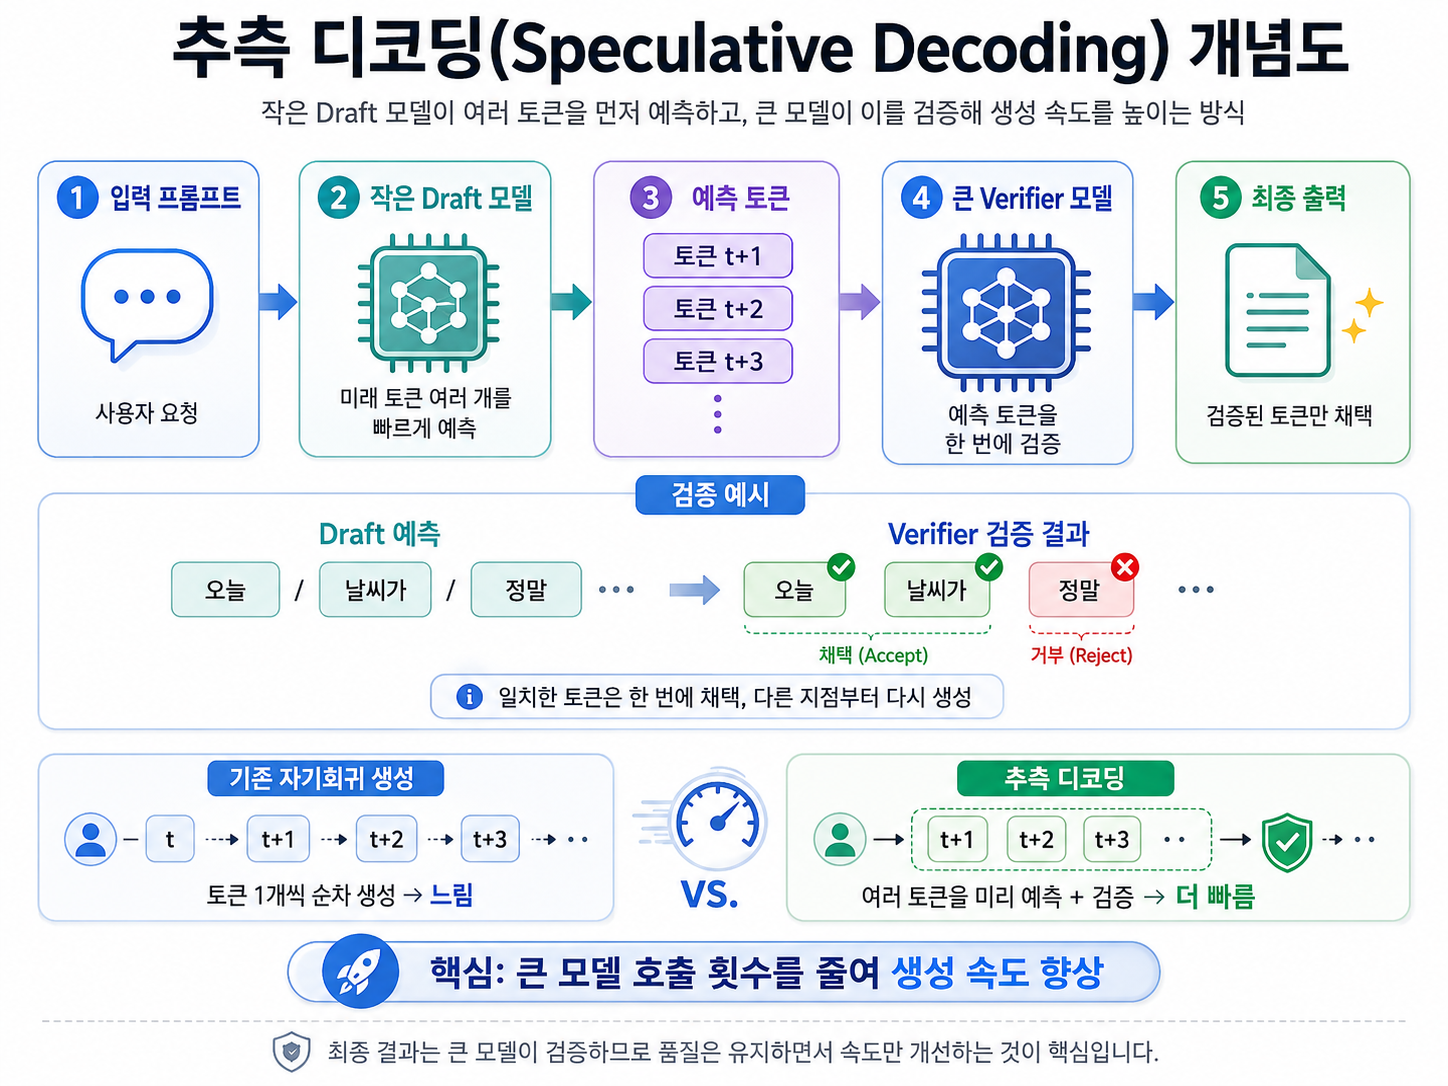
Speculative Decoding에서는 일반적으로 두 종류의 모델을 사용한다.
- 먼저 작고 빠른 모델인 Drafter가 앞으로 나올 가능성이 높은 토큰 여러 개를 미리 제안한다.
- 그다음 실제 답변을 생성하는 큰 모델인 Verifier가 제안된 토큰을 한 번에 검증한다.
작은 Draft 모델 → 미래 토큰 여러 개 제안

큰 Verifier 모델 → 제안된 토큰을 병렬로 검증
Drafter가 제안한 토큰과 큰 모델의 예측이 일치하면 여러 토큰을 한 번에 채택할 수 있다.
반대로 중간에 예측이 달라지는 지점이 나오면 일치하는 부분까지만 받아들이고, 이후에는 큰 모델의 결과를 사용한다.
이 구조를 사용하면 큰 모델을 토큰마다 반복 실행하는 횟수를 줄일 수 있다.
모바일에서는 작은 Draft 모델도 부담이 된다
Speculative Decoding은 효과적이지만 스마트폰에서는 또 다른 문제가 생긴다.
Drafter 역시 하나의 언어 모델이기 때문이다. 메인 모델보다 작더라도 Drafter의 가중치와 실행 메모리, KV Cache를 별도로 유지해야 한다. 서버에서는 감당할 수 있는 크기라도 스마트폰에서는 추가 모델 하나가 상당한 메모리 부담이 될 수 있다.
또한 독립적인 Drafter는 메인 모델이 이미 계산한 내부 정보를 직접 활용하기 어렵다. 메인 모델은 사용자의 입력을 처리하면서 문장의 의미와 요청 조건, 앞뒤 문맥을 hidden state에 담는다. 하지만 별도의 Drafter는 이러한 정보를 공유받지 못하고 입력된 토큰을 바탕으로 미래를 다시 예측해야 한다.
복잡한 요약이나 문장 재작성처럼 조건을 정확히 따라야 하는 작업에서는 Drafter의 예측이 메인 모델과 달라질 가능성이 높아진다.
Google의 해결책: MTP Head를 모델에 연결하기
Google은 별도의 Draft 모델을 실행하는 대신 Gemini Nano의 마지막 부분에 가벼운 Transformer 모듈을 추가했다.
이 모듈을 MTP Head라고 부른다.
전체 구조를 단순화하면 다음과 같다.
사용자 입력
   ↓
Gemini Nano 본체
   ↓
Hidden State와 KV Cache
   ↓
MTP Head가 미래 토큰 여러 개 예측
   ↓
Gemini Nano가 후보를 병렬 검증
   ↓
검증을 통과한 토큰 채택
MTP Head는 Gemini Nano가 이미 계산한 최종 hidden state를 이용해 다음에 나올 토큰 여러 개를 예측한다.
독립적인 Drafter가 입력 문장만 보고 미래를 추측한다면, MTP Head는 메인 모델이 이해한 문맥과 의미 정보를 직접 이용할 수 있다.
Google은 이를 기존 모델의 깊은 레이어에서 빠져나와 미래 토큰을 예측하는 late-exit 방식으로 설명한다.
Frozen 의미
이 연구에서 가장 중요한 단어 중 하나가 Frozen이다.
Google은 기존 Gemini Nano 전체를 다시 학습하지 않았다. 이미 학습이 끝난 Gemini Nano 본체의 가중치는 그대로 동결하고, 새롭게 추가한 MTP Head만 학습했다.
모델 본체까지 다시 학습하면 언어 능력이나 안전성 정렬이 달라지지 않았는지 다시 확인해야 한다. 이미 제품에 배포된 모델이라면 기존 애플리케이션과의 호환성도 재검증해야 한다.
반면 본체를 동결하고 작은 Head만 추가하면 기존 모델의 성질을 유지하면서 추론 방식만 개선할 수 있다.
MTP Head가 틀린 토큰을 제안해도 Gemini Nano 본체가 이를 최종적으로 검증한다. 메인 모델과 일치하지 않는 후보는 폐기되기 때문에, 최종 결과는 기존 Gemini Nano가 생성했을 결과와 동일하게 유지될 수 있다.
따라서 Frozen MTP는 Gemini Nano를 더 똑똑하게 만드는 기술은 아니다.
같은 모델이 같은 답변을 더 빠르고 효율적으로 생성하도록 만드는 기술이다.
KV Cache를 공유하는 Zero-copy Architecture
Frozen MTP의 또 다른 핵심은 Zero-copy Architecture다.
언어 모델은 이전 토큰을 처리하며 계산한 attention 정보를 KV Cache에 저장한다. 이를 이용하면 다음 토큰을 생성할 때 이전 문맥 전체를 다시 계산하지 않아도 된다.
독립적인 Drafter를 사용하면 메인 모델과 Drafter가 각각 별도의 KV Cache를 가져야 한다.
메인 모델의 KV Cache
+
Drafter의 KV Cache
메모리가 제한된 스마트폰에서는 이러한 중복이 부담이 된다.
Google의 MTP Head는 별도의 문맥 Cache를 새로 만들지 않고, Gemini Nano가 이미 생성한 KV Cache를 cross-attention 방식으로 직접 참조한다.
Gemini Nano의 기존 KV Cache
        ↑
MTP Head가 직접 참조
이 구조를 사용하면 독립 Drafter가 사용자의 프롬프트를 다시 처리하는 별도의 prefill 과정도 필요하지 않다.
Google은 임베딩 테이블과 Drafter용 KV Cache, 애플리케이션별 파라미터 등을 제거하면서 독립 Drafter 방식보다 인스턴스당 최대 약 130MB의 메모리를 절약했다고 설명한다.
서버 환경에서는 130MB가 작게 느껴질 수 있지만, 여러 앱과 AI 기능이 동시에 실행되는 스마트폰에서는 의미 있는 차이다.
Pixel에서는 얼마나 빨라졌을까?
Google은 Frozen MTP를 Pixel 9와 Pixel 10 시리즈의 Gemini Nano 기반 기능에 적용했다.
적용 대상에는 AI 알림 요약, 문장 교정, 스마트 답장과 같은 온디바이스 기능이 포함된다.
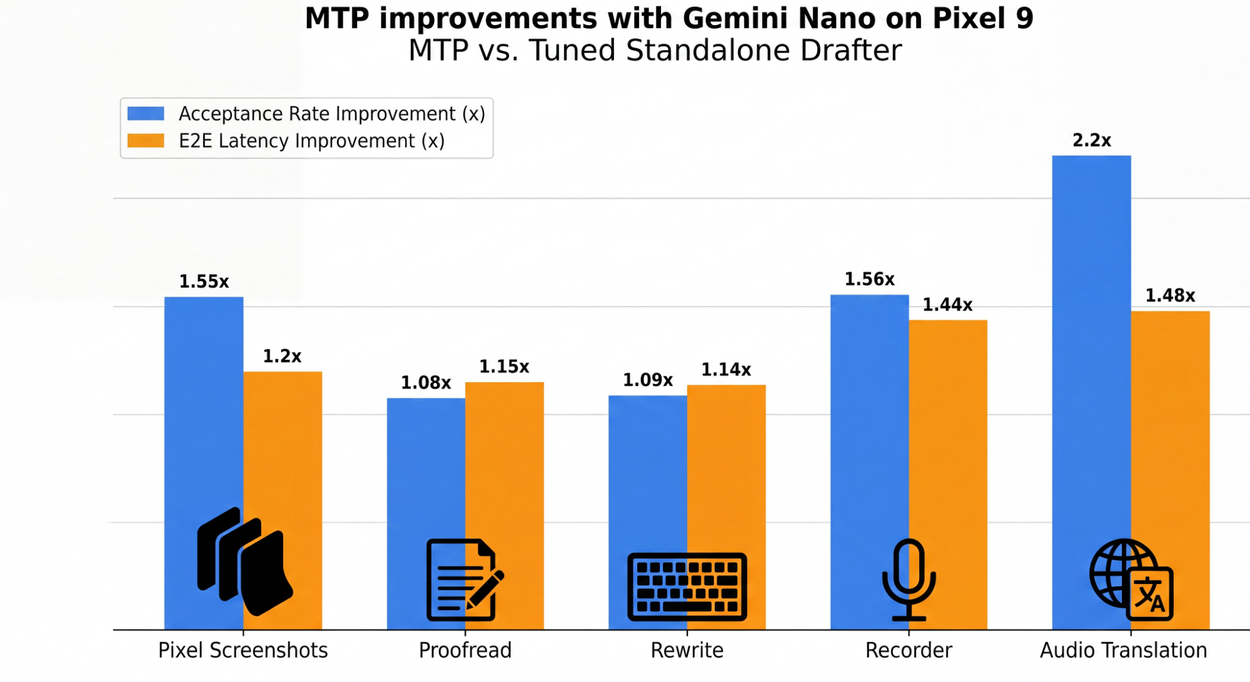
Google의 실험에서는 작업에 따라 Pixel 9에서 기존 독립 Drafter 방식보다 50% 이상의 속도 향상이 관찰됐다.
이 수치는 Frozen MTP를 사용하지 않은 기본 자기회귀 생성과의 비교가 아니라, Google이 이전에 사용하던 애플리케이션별 독립 Drafter와 비교한 결과라는 점은 구분할 필요가 있다.
특히 스마트 답장처럼 출력 형식이 어느 정도 정해진 작업에서는 토큰 후보가 받아들여지는 비율이 최대 55% 개선됐다.
실제 알림 요약과 문장 교정 작업에서는 한 번의 추론 패스마다 평균 약 두 개의 추가 토큰을 미리 맞힌 것으로 나타났다.
한 번에 처리할 수 있는 토큰 수가 늘어나면 무거운 프로세서를 반복해서 실행하는 횟수도 감소한다. 그 결과 생성 속도뿐 아니라 전력 사용량도 줄일 수 있다.
모든 작업에서 같은 효과가 나오는 것은 아니다
Frozen MTP가 항상 여러 토큰을 정확하게 예측하는 것은 아니다.
스마트 답장이나 문장 교정처럼 출력 구조가 어느 정도 정해진 작업에서는 다음 토큰을 비교적 쉽게 예측할 수 있다.
반면 창작 글쓰기나 복잡한 추론처럼 다음 문장이 여러 방향으로 이어질 수 있는 작업에서는 후보 토큰이 거절될 가능성이 높아진다.
예측이 틀리더라도 최종 답변의 품질이 낮아지는 것은 아니다. 메인 모델의 검증을 통과하지 못한 토큰은 사용되지 않기 때문이다.
다만 한 번에 채택되는 토큰 수가 줄어들면서 속도 향상 효과는 작아질 수 있다.
따라서 Frozen MTP의 실제 성능은 모델 자체뿐 아니라 작업의 종류와 출력의 예측 가능성에도 영향을 받는다.
작은 모델을 더 잘 사용하는 연구가 중요해지는 이유
대규모 언어 모델의 발전을 보면 모델 크기와 성능이 함께 증가해 온 것이 사실이다.
더 많은 파라미터와 데이터, 연산량을 투입한 모델이 복잡한 추론이나 코딩, 멀티모달 작업에서 더 좋은 결과를 보여 왔다.
그렇지만 모든 기기와 서비스가 가장 큰 모델을 사용할 수 있는 것은 아니다.

클라우드에서는 높은 성능을 얻을 수 있지만 네트워크 비용과 서버 운영 비용이 발생한다. 개인정보를 서버에 보내기 어려운 경우도 있고, 인터넷 연결이 없는 환경에서는 사용할 수 없다.
반대로 온디바이스에서는 모델 크기에 분명한 한계가 있다.
이 때문에 최근에는 단순히 작은 모델을 만드는 것을 넘어 다음과 같은 연구가 함께 진행되고 있다.
- 지식 증류를 통해 큰 모델의 능력을 작은 모델로 전달하는 방법
- 양자화를 통해 메모리와 연산량을 줄이는 방법
- 특정 작업에 맞게 작은 모델을 학습하는 방법
- KV Cache와 메모리 사용을 최적화하는 방법
- 여러 토큰을 미리 예측해 추론 횟수를 줄이는 방법
Frozen MTP도 이 가운데 마지막 방향에 해당한다.
모델 크기를 직접 줄인 연구는 아니지만, 동일한 Gemini Nano를 더 효율적으로 실행함으로써 제한된 하드웨어에서 체감 성능을 높인다.
결국 작은 모델의 경쟁력은 모델의 정확도만으로 결정되지 않는다.
같은 크기의 모델이라도 얼마나 빠르고 적은 메모리로 실행되는지에 따라 실제 제품에서의 사용 가능성이 크게 달라진다.
Google과 Samsung의 협력이 중요한 이유
Google은 자체 Pixel 기기를 가지고 있지만 글로벌 스마트폰 시장 전체에서 보면 Pixel만으로 확보할 수 있는 사용자 범위에는 한계가 있다.
반면 삼성의 Galaxy 시리즈는 다양한 국가와 가격대, 폼팩터에서 판매된다. Gemini가 Galaxy 스마트폰과 폴더블 기기, 웨어러블, XR 기기 등에 통합되면 Google은 훨씬 다양한 실제 환경에서 AI 기능을 제공할 수 있다.
이것은 단순히 Gemini 앱의 사용자가 늘어나는 것 이상의 의미가 있다. 온디바이스 AI는 다음과 같은 조건에 따라 성능이 달라질 수 있다.
- 기기별 메모리와 프로세서 성능
- 언어와 입력 길이
- 동시에 실행되는 앱의 수
- 배터리와 발열 상태
- 사용자가 요청하는 작업의 종류
Galaxy는 이러한 차이를 가진 대규모 사용자 환경을 제공한다. Frozen MTP와 같은 기술은 연구실의 벤치마크에서만 좋은 결과가 나오는 것으로는 충분하지 않다. 실제 스마트폰에서 메모리를 절약하고, 사용자가 체감할 수 있을 만큼 응답을 빠르게 만들며, 배터리 사용량까지 줄여야 한다. Google과 삼성의 협력이 계속될수록 이러한 추론 최적화 기술도 실제 제품을 통해 더 빠르게 검증되고 개선될 가능성이 있다고 생각된다.
클라우드와 온디바이스는 경쟁 관계만은 아니다
개인적으로는 여전히 대부분의 복잡한 작업에서 클라우드 LLM을 선호한다.
더 큰 모델을 사용할 수 있고, 최신 기능이 빠르게 반영되며, 로컬 하드웨어의 제약을 직접 해결할 필요도 없기 때문이다.
특히 긴 문서 분석이나 복잡한 코딩, 여러 도구를 연결하는 에이전트 작업에서는 클라우드 기반 모델의 장점이 크다. 하지만 모든 요청에 가장 큰 클라우드 모델이 필요한 것은 아니다.
알림 요약이나 문장 교정, 간단한 답장 생성처럼 짧고 반복적인 작업은 스마트폰 안에서 처리하는 편이 더 빠르고 효율적일 수 있다. 개인정보를 외부로 전송하지 않아도 된다는 장점도 있다. 향후에는 두 방식이 다음과 같이 나뉠 가능성이 있다.
짧고 반복적이며 개인정보와 관련된 작업
→ 온디바이스 모델

복잡한 추론과 대규모 문맥이 필요한 작업
→ 클라우드 모델

상황에 따라 두 모델을 함께 사용하는 작업
→ 하이브리드 구조
이런 관점에서 보면 Frozen MTP는 클라우드 LLM을 대체하기 위한 연구라기보다, 온디바이스가 맡을 수 있는 작업의 범위를 조금씩 넓히는 연구에 가까운 것 같다.
마무리
클라우드 기반 LLM의 편리함과 높은 성능을 경험한 뒤에는 온디바이스 LLM이 상대적으로 답답하게 느껴질 수 있다.
나 역시 비슷한 생각을 가지고 있다.
그럼에도 보안이 중요한 환경, 인터넷을 사용할 수 없는 환경, 빠른 로컬 처리가 필요한 시스템에서는 온디바이스 AI가 계속 필요할 것이다.
그리고 최근 대형 모델의 전반적인 성능이 빠르게 높아지면서, 그 능력과 학습 방법을 더 작은 모델에 적용하거나 작은 모델을 더 효율적으로 실행하려는 연구도 함께 발전하고 있다.
Google의 Frozen MTP는 이러한 흐름을 잘 보여준다. Gemini Nano 자체를 더 크게 만들거나 다시 학습하는 대신, 기존 모델의 hidden state와 KV Cache를 활용하는 가벼운 MTP Head를 추가했다. 이를 통해 여러 미래 토큰을 미리 예측하고 검증하여, 같은 결과를 더 적은 연산으로 생성한다.
특히 Google이 Pixel뿐 아니라 삼성 Galaxy 기기에도 Gemini 생태계를 확대하고 있다는 점에서 이번 연구는 더 흥미롭게 느껴졌다.
Google에는 수많은 실제 사용자를 통해 온디바이스 AI를 검증할 수 있는 환경이 생겼고, 사용자는 스마트폰에서 더 빠르고 효율적인 AI 기능을 경험할 가능성이 커졌다.
Frozen MTP는 작은 모델을 더 크게 만드는 연구가 아니라, 이미 충분히 좋아진 작은 모델을 실제 기기에서 더 잘 사용하기 위한 연구다.
현재는 클라우드 LLM이 성능과 편의성에서 분명한 우위를 가지고 있다. 하지만 온디바이스 모델 역시 보안과 연결성, 비용과 응답 지연이라는 분명한 역할을 가지고 있다. 결국 중요한 것은 클라우드와 온디바이스 중 어느 하나만 선택하는 것이 아니라, 각각의 장점에 맞게 모델을 배치하는 일일 것이다.
참고 자료
- Google Research, Accelerating Gemini Nano models on Pixel with frozen Multi-Token Prediction
https://research.google/blog/accelerating-gemini-nano-models-on-pixel-with-frozen-multi-token-prediction/ - Google, Android is reimagining your phone with Gemini
https://blog.google/products-and-platforms/platforms/android/android-gemini-google-ai/ - Google, Pixel 8 Pro — the first smartphone with AI built in
https://blog.google/products-and-platforms/devices/pixel/pixel-feature-drop-december-2023/ - Samsung Newsroom, Samsung and Google Cloud Join Forces To Bring Generative AI to Samsung Galaxy S24 Series
https://news.samsung.com/global/samsung-and-google-cloud-join-forces-to-bring-generative-ai-to-samsung-galaxy-s24-series - Google, New Gemini app features coming to Android devices
https://blog.google/products-and-platforms/products/gemini/new-gemini-app-updates-android/ - Google, A more intelligent Android on Samsung Galaxy S26
https://blog.google/products-and-platforms/platforms/android/samsung-unpacked-2026/
'Tech Notes' 카테고리의 다른 글
| Kimi K3 웨이트 공개: 2.8조 파라미터 오픈웨이트 모델의 구조와 특징 (0) | 2026.07.28 |
|---|---|
| Claude Fable 5가 말하는 Agentic Coding의 핵심: 내가 모르는 것을 먼저 찾는 일 (0) | 2026.07.07 |
| Loop Engineering: AI에게 질문하는 것을 넘어, 일을 끝내는 구조 만들기 (0) | 2026.06.23 |
| AI 구독료는 정말 비싼 걸까? 토큰 가격을 보며 든 생각 (0) | 2026.06.16 |
| Claude Code, OpenCode, Codex CLI로 보는 LLM Agent 오케스트레이션 (0) | 2026.06.12 |


