Moonshot AI가 2026년 7월 27일, Kimi K3의 전체 모델 웨이트를 Hugging Face에 공개했다.
LINK >> https://huggingface.co/moonshotai/Kimi-K3
moonshotai/Kimi-K3 · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co
Kimi K3는 총 2.8조 개의 파라미터를 가진 Mixture-of-Experts 모델이다. 단순히 규모만 큰 모델은 아니다. Kimi Delta Attention, Attention Residuals, Stable LatentMoE와 같은 새로운 구조를 적용하고, 텍스트와 이미지를 함께 이해하는 멀티모달 기능과 최대 100만 토큰의 컨텍스트를 지원한다.
이번 공개를 통해 API에서만 사용할 수 있었던 Kimi K3를 외부 연구기관과 기업도 직접 분석하고 배포할 수 있게 됐다. 다만 체크포인트 크기가 약 1.56TB에 달하기 때문에 일반적인 개인용 GPU에서 실행할 수 있는 모델은 아니다.
오픈소스가 아닌 오픈웨이트 모델
Moonshot AI는 Kimi K3를 오픈웨이트 모델로 소개한다.
오픈웨이트란 학습이 끝난 모델의 파라미터, 즉 모델이 학습한 결과물을 다운로드할 수 있도록 공개하는 방식을 의미한다. 기업이나 연구기관은 공개된 웨이트를 자체 서버에 배포하거나 추가 파인튜닝하고, 모델 내부 구조를 분석할 수 있다.
하지만 학습 데이터와 전체 사전학습 과정이 모두 공개됐다는 의미는 아니다. 따라서 Kimi K3는 완전히 재현 가능한 오픈소스 모델이라기보다는, 프런티어급 모델의 가중치를 공개한 오픈웨이트 모델이라고 보는 것이 정확하다.
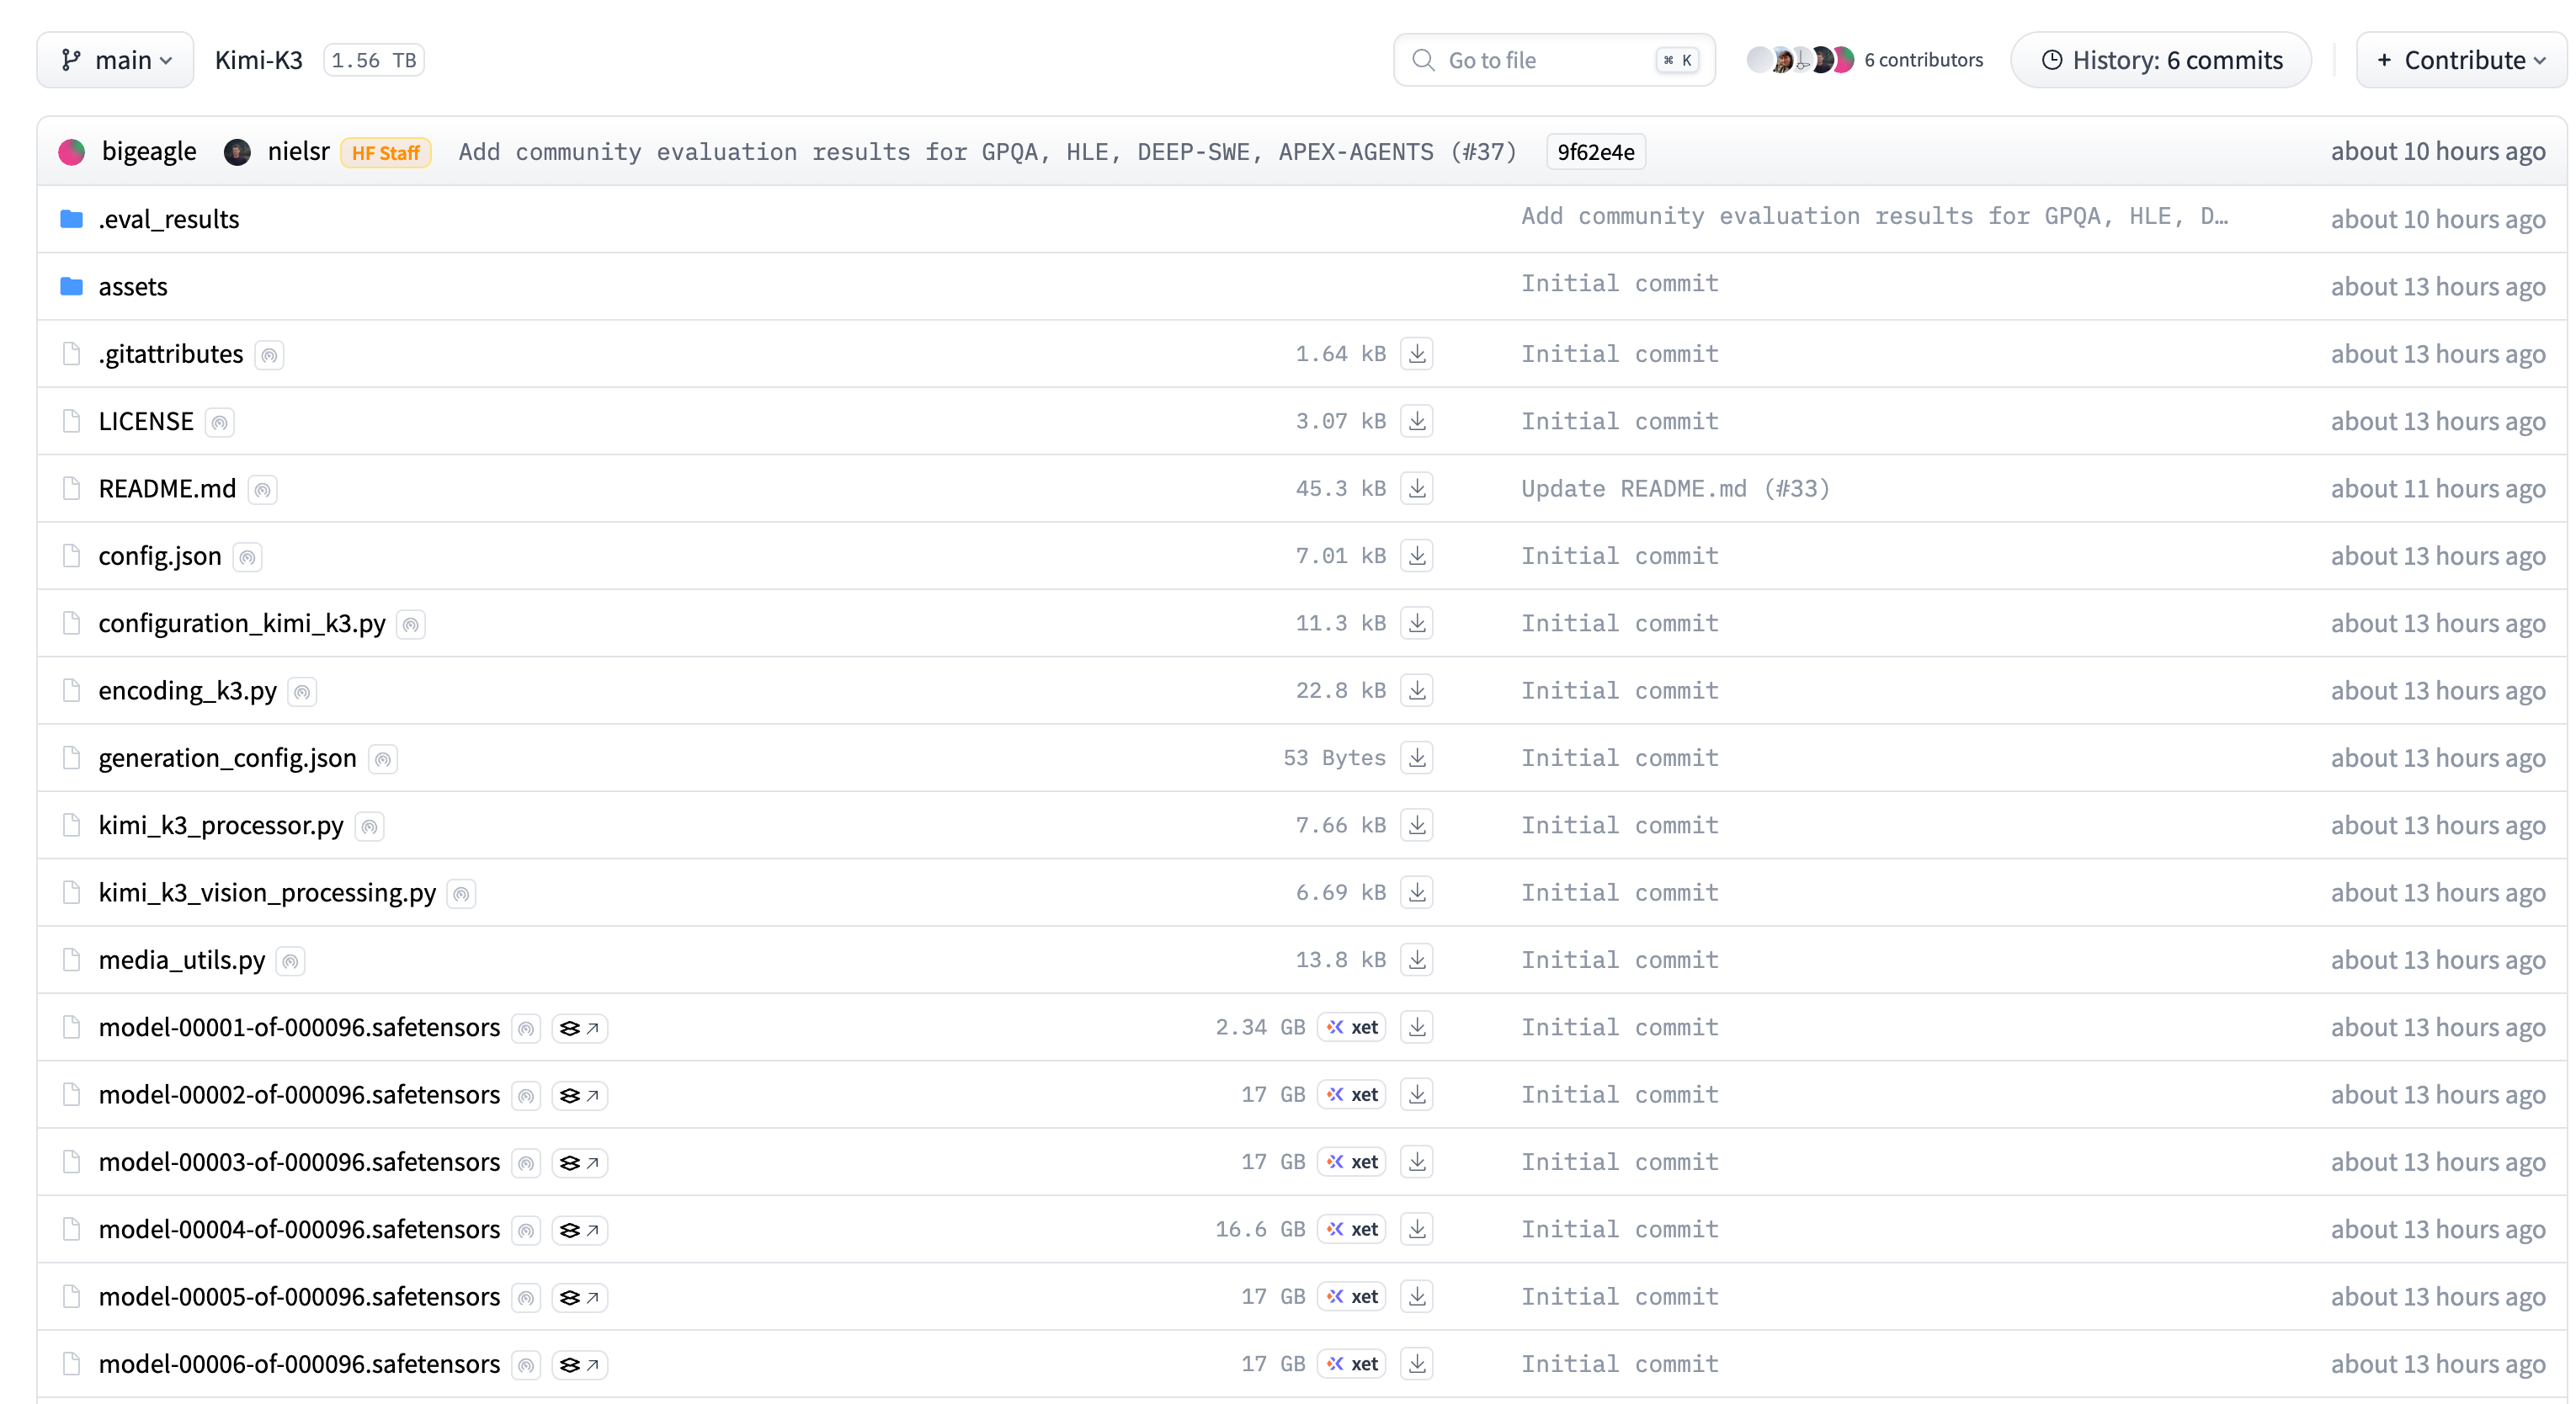
Hugging Face에는 약 1.56TB의 파일이 공개됐으며, 실제 모델 웨이트는 총 96개의 safetensors 파일로 분리돼 있다. 모델 설정 파일, 토크나이저, 이미지 처리 코드와 Kimi K3 전용 모델 구현 코드도 함께 포함돼 있다.
Kimi K3의 주요 사양
Kimi K3의 핵심 사양은 다음과 같다.
| 항목 | 사양 |
| 전체 파라미터 | 2.8T |
| 토큰당 활성 파라미터 | 104B |
| 전체 레이어 | 93개 |
| KDA 레이어 | 69개 |
| Gated MLA 레이어 | 24개 |
| 전체 전문가 | 896개 |
| 토큰당 선택 전문가 | 16개 |
| 공유 전문가 | 2개 |
| Attention Head | 96개 |
| Vocabulary | 약 160K |
| 최대 컨텍스트 | 1,048,576 토큰 |
| 비전 인코더 | MoonViT-V2 |
| 비전 인코더 파라미터 | 401M |
| 가중치 정밀도 | MXFP4 |
| 활성값 정밀도 | MXFP8 |
전체 파라미터는 2.8조 개지만, 한 토큰을 처리할 때 모든 파라미터를 계산하지는 않는다. 실제로는 약 1,040억 개의 파라미터가 활성화된다.
MoE: 필요한 전문가만 선택하는 구조
Kimi K3는 MoE, Mixture of Experts 구조를 사용한다.
MoE는 하나의 거대한 모델 안에 여러 개의 전문가 네트워크를 구성하고, 입력 토큰마다 필요한 전문가 일부만 선택해 계산하는 방식이다. 모든 파라미터를 매번 계산하지 않으면서 모델 전체 용량을 크게 확장할 수 있다는 장점이 있다.
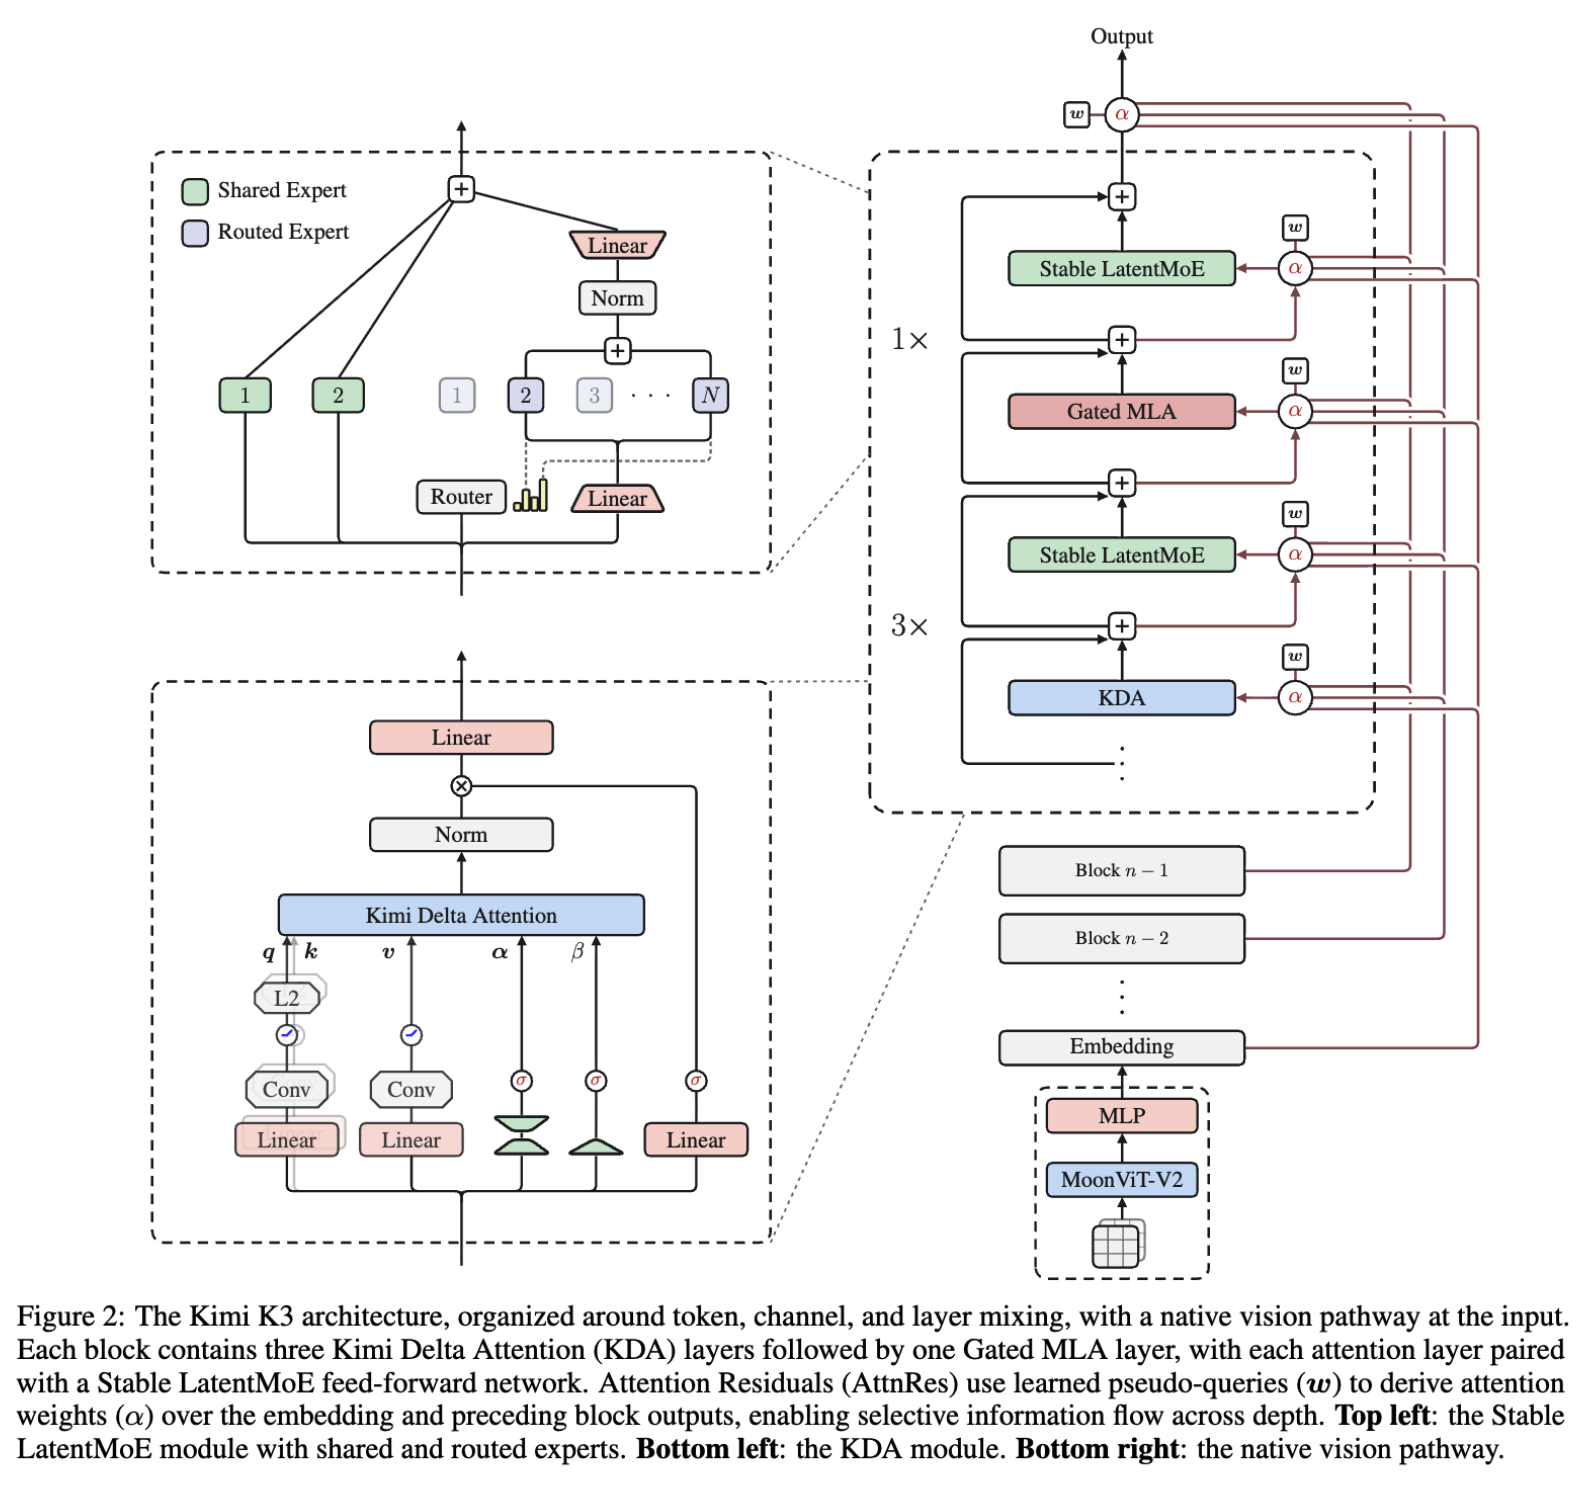
Kimi K3에는 총 896개의 전문가가 있으며, 각 토큰은 이 중 16개를 선택한다. 여기에 항상 사용되는 공유 전문가 2개와 Attention 계층 등이 함께 계산된다.
따라서 단순히 896개 중 16개라는 비율만 보고 전체 파라미터의 약 1.8%만 계산한다고 이해하면 정확하지 않다. 공식 모델 카드에 명시된 실제 활성 파라미터는 104B다. 활성 파라미터만 비교해도 일반적인 70B 모델보다 큰 규모다.
Stable LatentMoE: 더 많은 전문가를 안정적으로 사용하기 위한 구조
Moonshot AI는 Kimi K3의 MoE 구조를 Stable LatentMoE라고 부른다.
LatentMoE는 토큰의 전체 표현을 그대로 각 전문가에게 전달하기보다, 더 작은 latent representation으로 압축한 뒤 전문가 연산을 수행하는 방식이다. 여기서 latent는 입력 정보를 압축한 내부 표현을 의미한다.
이 방식은 전문가 수를 크게 늘리면서도 각 전문가의 계산 부담을 줄이는 데 목적이 있다. Moonshot AI는 Kimi K3가 896개 전문가 중 16개를 선택하는 높은 희소성을 사용하면서도 안정적인 학습이 가능하도록 설계했다고 설명한다.
공식 발표에 따르면 이러한 구조 변화와 학습 방식 개선을 통해 Kimi K2 대비 전체 스케일링 효율이 약 2.5배 향상됐다. 여기서 스케일링 효율은 같은 수준의 연산 자원을 사용했을 때 모델 성능을 얼마나 효과적으로 높일 수 있는지를 의미한다.
KDA: 긴 문맥을 효율적으로 처리하는 Attention
KDA는 Kimi Delta Attention의 약자다.
기존 Transformer의 Attention은 이전 토큰의 Key와 Value를 KV Cache에 저장한다. 문맥이 길어질수록 저장해야 하는 데이터와 연산량도 증가한다. KDA는 모든 과거 토큰의 정보를 그대로 보관하기보다, 이전 정보를 압축된 상태로 업데이트하는 Linear Attention 계열의 구조다. 긴 문서를 처리할 때 KV Cache와 Attention 연산 부담을 줄이는 것이 목적이다.
Kimi K3의 전체 93개 레이어 중 69개 레이어가 KDA로 구성돼 있다. 대부분의 레이어에서 효율적인 KDA를 사용하고, 일정한 간격으로 더 정밀한 Attention 구조를 배치하는 방식이다.
Gated MLA: 필요한 과거 정보를 정밀하게 다시 확인
MLA는 Multi-head Latent Attention의 약자다.
MLA는 Key와 Value를 더 작은 latent vector로 압축해 KV Cache 사용량을 줄이는 Attention 구조다. Kimi K3는 MLA에 출력 게이트를 추가한 Gated MLA를 사용한다.
게이트는 현재 입력에 따라 Attention 결과를 얼마나 사용할지 조절하는 장치다. 모든 Attention 결과를 동일하게 반영하지 않고, 필요한 정보의 비중을 동적으로 조절한다.
Kimi K3에는 총 24개의 Gated MLA 레이어가 들어간다. 설정 파일을 보면 KDA 레이어 사이에 주기적으로 MLA 레이어가 배치돼 있다.
쉽게 설명하면 KDA가 긴 문맥을 효율적으로 압축해 읽는 역할을 맡고, Gated MLA는 중간중간 특정 토큰 관계를 더 정밀하게 확인하는 역할을 맡는 구조다.
AttnRes: 이전 레이어의 정보를 선택해서 사용하는 Residual 구조
AttnRes는 Attention Residuals의 줄임말이다.
일반적인 Transformer에서는 각 레이어의 출력에 이전 hidden state를 더하는 Residual Connection을 사용한다. 이 구조는 깊은 모델의 학습을 안정화하지만, 레이어 수가 많아지면 이전 정보가 계속 누적되면서 중요한 표현이 희석될 수 있다.
AttnRes는 이전 레이어의 정보를 단순히 모두 더하는 대신, Attention을 이용해 현재 레이어에 필요한 이전 표현을 선택한다.
Kimi K3의 설정에는 12개 레이어 단위의 Attention Residual block이 적용돼 있다. 모델이 93개 레이어까지 깊어져도 초기 레이어와 중간 레이어의 정보를 더 선택적으로 가져오기 위한 구조다.
100만 토큰 컨텍스트
Kimi K3는 최대 1,048,576토큰, 약 100만 토큰의 컨텍스트를 지원한다.
컨텍스트 윈도는 모델이 한 번의 작업에서 참고할 수 있는 입력과 대화 기록의 최대 범위를 의미한다. 컨텍스트가 길수록 대규모 코드 저장소, 여러 문서, 긴 대화 기록을 한 작업 안에서 처리하기 유리하다.
Moonshot AI는 Kimi K3를 짧은 질문에 답하는 챗봇보다는 장시간 이어지는 코딩과 리서치, 도구 사용 작업에 초점을 맞춰 설계했다.
다만 최대 컨텍스트 길이를 지원한다는 것과 100만 토큰 전체를 항상 동일한 정확도로 활용한다는 것은 별개의 문제다. 실제 성능은 입력 구조, 검색 방식, 추론 엔진과 컨텍스트 관리 전략에 따라 달라질 수 있다. 공식 평가에서도 일부 장기 작업에는 컨텍스트 압축 전략이 함께 사용됐다.
네이티브 멀티모달과 MoonViT-V2
Kimi K3는 텍스트 모델에 별도의 이미지 모델을 단순 연결한 방식이 아니라, 학습 단계부터 시각 정보를 함께 처리하도록 설계된 네이티브 멀티모달 모델이다.
비전 인코더로는 약 4억100만 개의 파라미터를 가진 MoonViT-V2가 사용된다. ViT는 Vision Transformer의 약자로, 이미지를 여러 개의 패치로 나눠 Transformer 방식으로 처리하는 모델이다.
공식 발표에서는 텍스트, 이미지와 영상 이해 능력을 설명하고 있다. 다만 현재 Hugging Face 모델 카드의 공개 인터페이스와 modality 표시는 텍스트와 이미지 중심이다. 공개 웨이트를 직접 배포할 경우 영상 입력 지원 여부는 사용하는 추론 엔진과 전처리 구현을 함께 확인할 필요가 있다.
MXFP4와 MXFP8: 저정밀도까지 고려한 학습
Kimi K3의 가중치는 MXFP4, 활성값은 MXFP8 형식을 사용한다.
- MXFP4: 가중치를 표현하는 4비트 계열의 저정밀 부동소수점 형식
- MXFP8: 모델 연산 중 생성되는 활성값을 표현하는 8비트 계열 형식
- Activation: 각 레이어의 연산 과정에서 생성되는 중간값
정밀도를 낮추면 모델 파일 크기와 메모리 사용량, 연산량을 줄일 수 있다. 하지만 단순히 학습이 끝난 모델을 4비트로 변환하면 성능이 크게 떨어질 수 있다.
Kimi K3는 이를 줄이기 위해 SFT 단계부터 QAT, Quantization-Aware Training을 적용했다. QAT는 학습 과정에서 낮은 정밀도로 변환될 때 발생할 오차를 미리 반영하고 보정하는 방식이다.
코딩과 에이전트 작업에 초점을 둔 모델
Kimi K3의 주요 목적은 단순 질의응답보다 장시간 수행되는 에이전트 작업이다.
Moonshot AI는 Kimi K3가 대규모 저장소를 분석하고, 터미널 도구를 사용하며, 코드를 수정한 뒤 결과를 다시 확인하는 장기 코딩 작업을 수행하도록 설계됐다고 설명한다. 스크린샷을 확인하면서 프런트엔드나 게임을 수정하는 Vision in the Loop 작업도 주요 활용 사례로 제시한다.
공식 모델 카드에서 공개한 주요 결과는 다음과 같다.
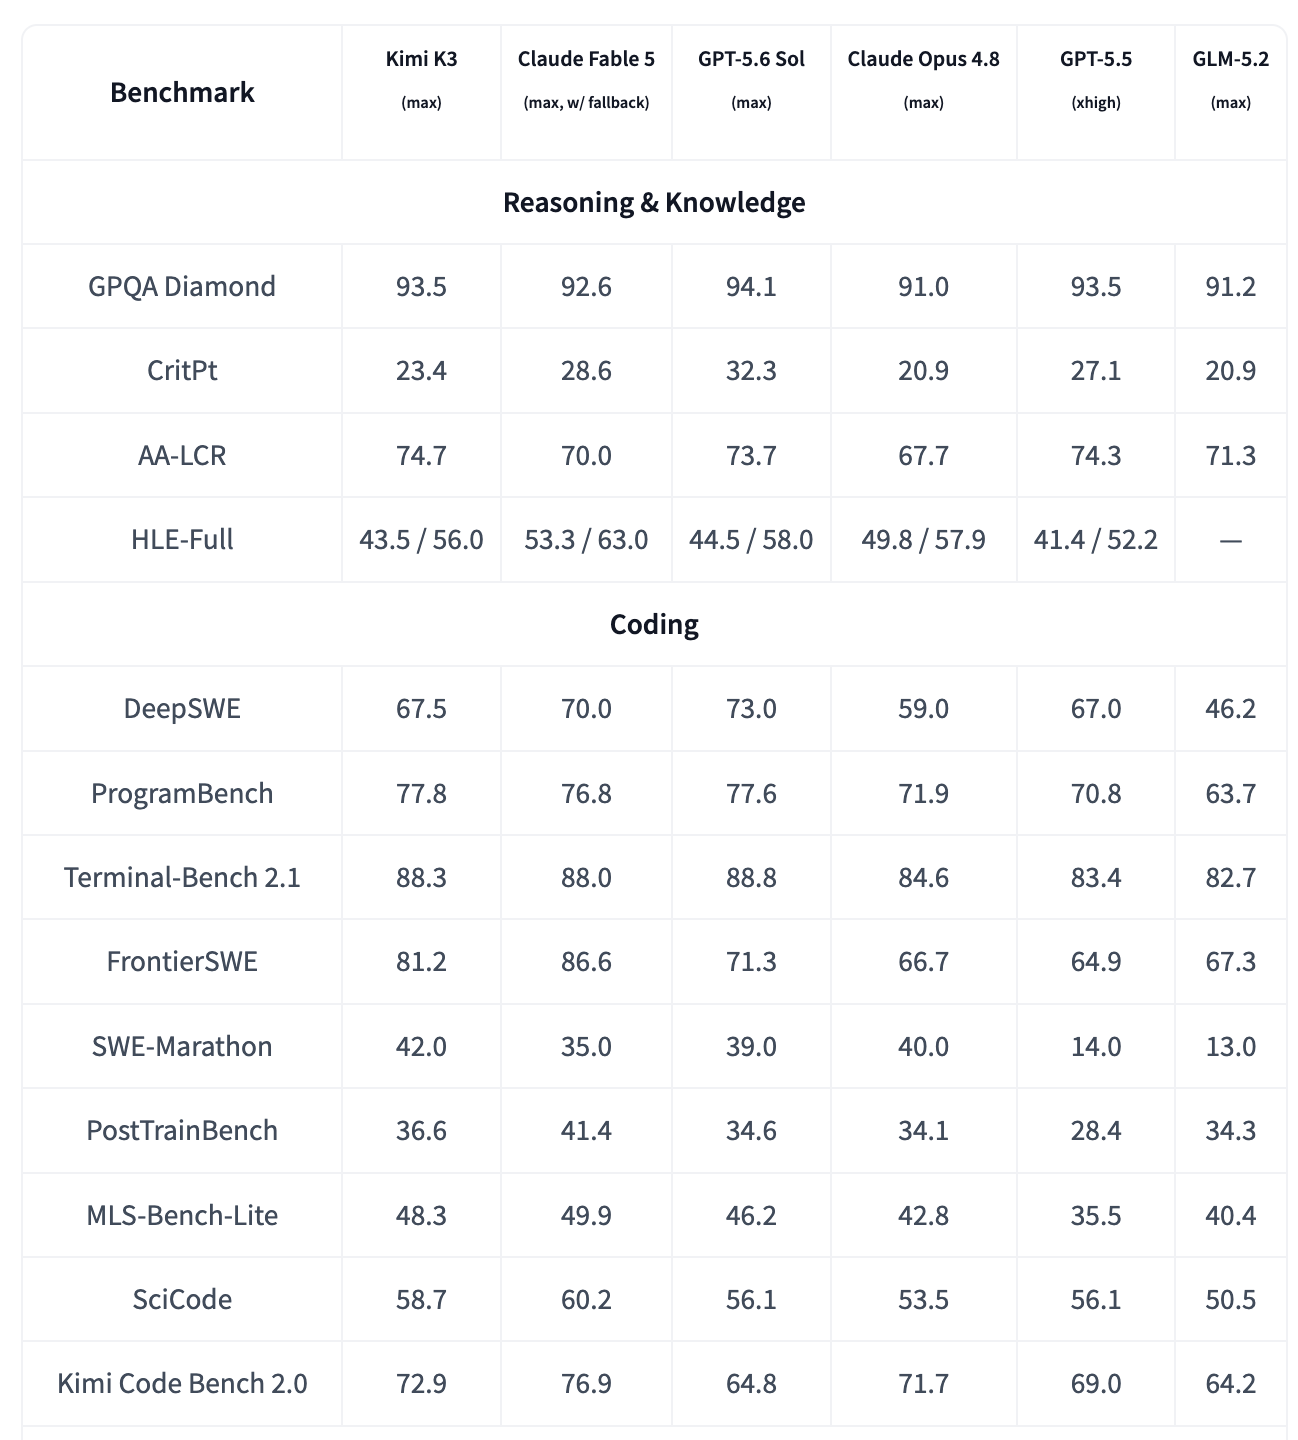
코딩뿐 아니라 브라우저 탐색, MCP 도구 사용, 문서와 이미지 이해에서도 높은 점수를 제시했다. 다만 모델마다 Kimi Code, Claude Code와 Codex 등 서로 다른 에이전트 실행 환경이 사용된 평가도 있어, 수치를 기반 모델의 절대적인 순위로 해석하는 데는 주의가 필요하다.
항상 Thinking이 활성화되는 모델
Kimi K3는 기본적으로 Thinking이 항상 활성화된 추론 모델이다.
API 응답에는 최종 답변인 content와 함께 내부 작업 기록을 나타내는 reasoning_content가 반환된다. 추론 강도는 low, high, max 중에서 설정할 수 있으며 기본값은 max다.
특히 멀티턴 대화나 도구 호출에서는 이전 assistant 응답을 그대로 다시 전달해야 한다. 최종 답변만 저장하는 것이 아니라 reasoning_content와 tool_calls까지 포함한 전체 메시지를 대화 기록에 유지해야 한다.
Moonshot AI는 이를 Preserved Thinking History라고 표현한다. 이전 작업 과정이 누락되면 모델이 과거에 어떤 판단을 했는지 연결하지 못해 장기 작업의 일관성이 낮아질 수 있다.
직접 배포할 수 있지만 최소 8개의 최상위 GPU가 필요하다
Kimi K3는 Hugging Face에서 전체 웨이트를 내려받아 자체 인프라에 배포할 수 있다. 공식적으로 권장되는 추론 엔진은 vLLM, SGLang, TokenSpeed이며, OpenAI 호환 API 형태로 서버를 구성할 수도 있다.
하지만 오픈웨이트라는 사실이 곧 일반적인 워크스테이션에서 실행할 수 있다는 의미는 아니다. Kimi K3는 MXFP4로 양자화됐음에도 약 1.5TB에 이르는 가중치를 가지고 있다. 여기에 모델 실행을 위한 작업 메모리, KDA 상태, MLA의 KV Cache와 동시 요청 처리 공간까지 추가로 필요하다.
특히 100만 토큰 컨텍스트를 활용하려면 모델 가중치를 메모리에 올리는 것만으로는 부족하다. 입력 길이와 동시 사용자 수가 늘어날수록 KV Cache와 KDA 상태 저장에 필요한 메모리도 증가한다.
vLLM 공식 배포 가이드에서는 NVIDIA 환경 기준으로 최소 8개의 GB300 GPU를 요구한다. AMD 환경에서는 최소 8개의 MI350X 또는 MI355X GPU가 필요하다. 이 구성은 모델을 실행할 수 있는 최소 단위에 가까우며, 실제 서비스 트래픽을 처리하려면 멀티노드 구성을 사용하도록 안내하고 있다.
SGLang이 제시한 하드웨어별 배포 구성은 다음과 같다.
| GPU 종류 | 권장 GPU 수 | 기본 구성 |
| NVIDIA B300 | 8개 | 단일 노드, 8 GPU |
| NVIDIA GB300 | 8개 | 2노드, 노드당 4 GPU |
| NVIDIA B200 | 16개 | 2노드, 노드당 8 GPU |
| NVIDIA GB200 | 16개 | 4노드, 노드당 4 GPU |
| NVIDIA H200 | 16개 | 2노드, 노드당 8 GPU |
| NVIDIA H100 80GB | 32개 | 4노드, 노드당 8 GPU |
| AMD MI350X·MI355X | 8개 | 단일 노드, 8 GPU |
GPU 수가 다른 이유는 GPU마다 제공하는 HBM 용량과 Kimi K3의 MXFP4 연산 지원 수준이 다르기 때문이다. B300과 GB300 같은 최신 Blackwell 계열은 대용량 HBM과 MXFP4 연산에 최적화돼 있어 적은 수의 GPU로 배포할 수 있다. 반면 H100은 GPU당 메모리 용량이 상대적으로 작기 때문에 최대 32개가 필요하다.
Kimi K3처럼 가중치가 1TB를 훨씬 넘는 모델은 GPU의 연산 성능뿐 아니라 전체 HBM 용량도 중요하다.
여러 GPU에 모델을 나눠 올릴 때는 GPU 사이의 통신 속도도 중요하다. Kimi K3의 MoE 구조에서는 토큰마다 선택된 전문가가 서로 다른 GPU에 위치할 수 있기 때문에, GPU 사이에서 데이터가 지속적으로 이동한다. 따라서 NVLink, NVSwitch 또는 RDMA와 같은 고속 인터커넥트가 필요하다. vLLM 역시 멀티노드 환경에서 NVLink나 RDMA에 맞는 통신 백엔드를 사용하도록 안내한다.
SGLang은 사용 목적에 따라 배포 방식도 구분한다.
- Low-Latency: 대화형 서비스처럼 응답 지연을 줄이는 구성
- Balanced: 지연 시간과 처리량 사이의 균형을 맞춘 기본 구성
- High-Throughput: 다수의 요청을 동시에 처리하기 위한 대규모 구성
- Long-Context: 긴 문서와 대규모 코드 저장소를 처리하기 위한 구성
다만 SGLang 문서에 제시된 하드웨어 조합과 명령어는 배포를 시작하기 위한 참고 구성이다. 문서에서도 최종 공개 웨이트와 현재 코드 조합에 대한 모든 처리량과 정확도가 검증된 것은 아니므로, 실제 서비스에 적용하기 전에 사용하는 하드웨어와 워크로드에서 다시 측정할 것을 권고한다.
결국 Kimi K3는 개인용 PC에서 실행하는 로컬 LLM과는 방향이 다르다. 직접 배포는 가능하지만, 현실적인 대상은 대규모 GPU 클러스터를 보유한 연구기관, 클라우드 사업자와 대기업이다.
개발자가 모델을 단순히 사용해보려는 목적이라면 자체 서버를 구축하기보다 Moonshot AI의 API나 Kimi Code를 사용하는 편이 현실적이다. 반면 모델 구조 분석, 사내 데이터 기반의 파인튜닝, 보안상 외부 API를 사용할 수 없는 환경이나 대규모 자체 서비스가 목적이라면 오픈웨이트 공개의 장점을 활용할 수 있다.
라이선스도 확인해야 한다
Kimi K3 웨이트와 관련 코드는 자체 Kimi K3 License로 공개됐다.
모델 사용, 수정, 파인튜닝, 배포와 파생 모델 제작이 허용되며 상업적 제품에도 적용할 수 있다. 하지만 Apache 2.0이나 MIT처럼 조건이 거의 없는 라이선스는 아니다.
최근 연속 12개월 동안 전체 매출이 2,000만달러를 넘는 사업자가 Kimi K3를 Model-as-a-Service 형태로 제공하려면 Moonshot AI와 별도 계약을 체결해야 한다. 또한 월간 활성 사용자 1억명 이상이거나 월 매출 2,000만달러 이상인 상업 서비스는 UI에 Kimi K3 명칭을 표시해야 한다.
내부 사용이나 Moonshot AI의 공식 서비스 및 인증 추론 파트너를 통한 사용에는 일부 예외가 적용된다.
마무리
Kimi K3는 단순히 파라미터 수를 크게 확장한 모델이 아니다.
896개의 전문가를 사용하는 Stable LatentMoE, 긴 컨텍스트를 위한 Kimi Delta Attention, 정밀한 정보 검색을 보완하는 Gated MLA, 깊은 모델의 정보 흐름을 개선하는 Attention Residuals가 함께 적용됐다. 여기에 네이티브 멀티모달, 100만 토큰 컨텍스트와 MXFP4 기반 QAT까지 포함됐다.
이번 웨이트 공개를 통해 외부에서도 이러한 구조를 직접 분석하고 추론 엔진을 최적화하거나, 특정 업무에 맞게 파인튜닝할 수 있게 됐다.
다만 1.56TB에 달하는 모델 크기를 고려하면 Kimi K3는 대중적인 로컬 LLM과는 방향이 다르다. 누구나 쉽게 실행하는 소형 오픈 모델이라기보다, 대규모 인프라를 가진 기업과 연구기관이 자체적으로 운영할 수 있도록 공개된 프런티어급 오픈웨이트 모델에 가깝다.
Kimi K3의 공개가 중요한 이유도 여기에 있다. API를 통해 결과만 확인하는 수준을 넘어, 3조 파라미터급 모델이 실제로 어떤 구조로 설계되고 배포되는지를 외부 개발자와 연구자가 직접 확인할 수 있는 사례가 등장했다.
참고 자료
moonshotai/Kimi-K3 · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co
Kimi K3 - Kimi API Platform
Kimi K3 is our flagship model for long-horizon coding and end-to-end knowledge work, with a 1M-token context window and industry-leading intelligence. The Kimi API Platform provides K3, K2.7 Code, K2.6 and other large language model APIs, supporting long c
platform.kimi.ai
Kimi K3 Tech Blog: Open Frontier Intelligence
Today, we are introducing Kimi K3 — our most capable model. Kimi K3 is a 2.8T-parameter model built on our Kimi Delta Attention and Attention Residuals, with native vision capabilities and a 1-million-token context window. It is the world's first open 3T
www.kimi.com
'Tech Notes' 카테고리의 다른 글
| Qwen3.8-Max 공개: 16일 동안 코딩하는 2.4조 파라미터 AI 모델 (0) | 2026.08.03 |
|---|---|
| Claude Code의 컨텍스트 엔지니어링이 바뀌었다: 더 많이 넣는 대신 필요한 순간에 불러오기 (0) | 2026.07.28 |
| Claude Fable 5가 말하는 Agentic Coding의 핵심: 내가 모르는 것을 먼저 찾는 일 (0) | 2026.07.07 |
| 클라우드 LLM 시대에도 온디바이스 AI가 필요한 이유: Google Frozen MTP (0) | 2026.06.29 |
| Loop Engineering: AI에게 질문하는 것을 넘어, 일을 끝내는 구조 만들기 (0) | 2026.06.23 |


