최근 AI타임스에서 AI 구독료와 토큰 가격에 대한 흥미로운 기사를 읽었다.
https://www.aitimes.com/news/articleView.html?idxno=211728
"월 200불로 1만4000불 토큰 제공"…챗GPT·클로드 '구독료' 실체 - AI타임스
오픈AI와 앤트로픽의 월정액 구독 서비스가 실제 사용량 기준으로는 수천~수만달러 상당의 AI 연산 비용을 제공하고 있는 것으로 나타났다. AI 모델 사용량이 폭증
www.aitimes.com
기사의 핵심은 간단하다.
우리가 매달 내는 ChatGPT나 Claude의 구독료가 겉으로 보기에는 비싸 보이지만, 실제 제공되는 토큰 사용량을 API 가격 기준으로 환산하면 오히려 매우 저렴한 구조일 수 있다는 내용이다.
예를 들어 월 200달러 수준의 고급 구독 플랜은 사용자가 허용된 한도까지 모두 사용한다는 전제에서 수천 달러에서 많게는 1만 달러 이상의 API 사용량을 제공하는 것으로 추산된다. 즉, 개인 사용자가 체감하는 구독료는 비싸지만, 헤비 유저 관점에서는 오히려 서비스 제공사가 상당한 비용을 부담하는 구조에 가깝다.
이 지점에서 한 가지 생각이 들었다.
지금의 AI 구독료는 정말 비싼 걸까, 아니면 오히려 아직은 싸게 제공되고 있는 걸까?
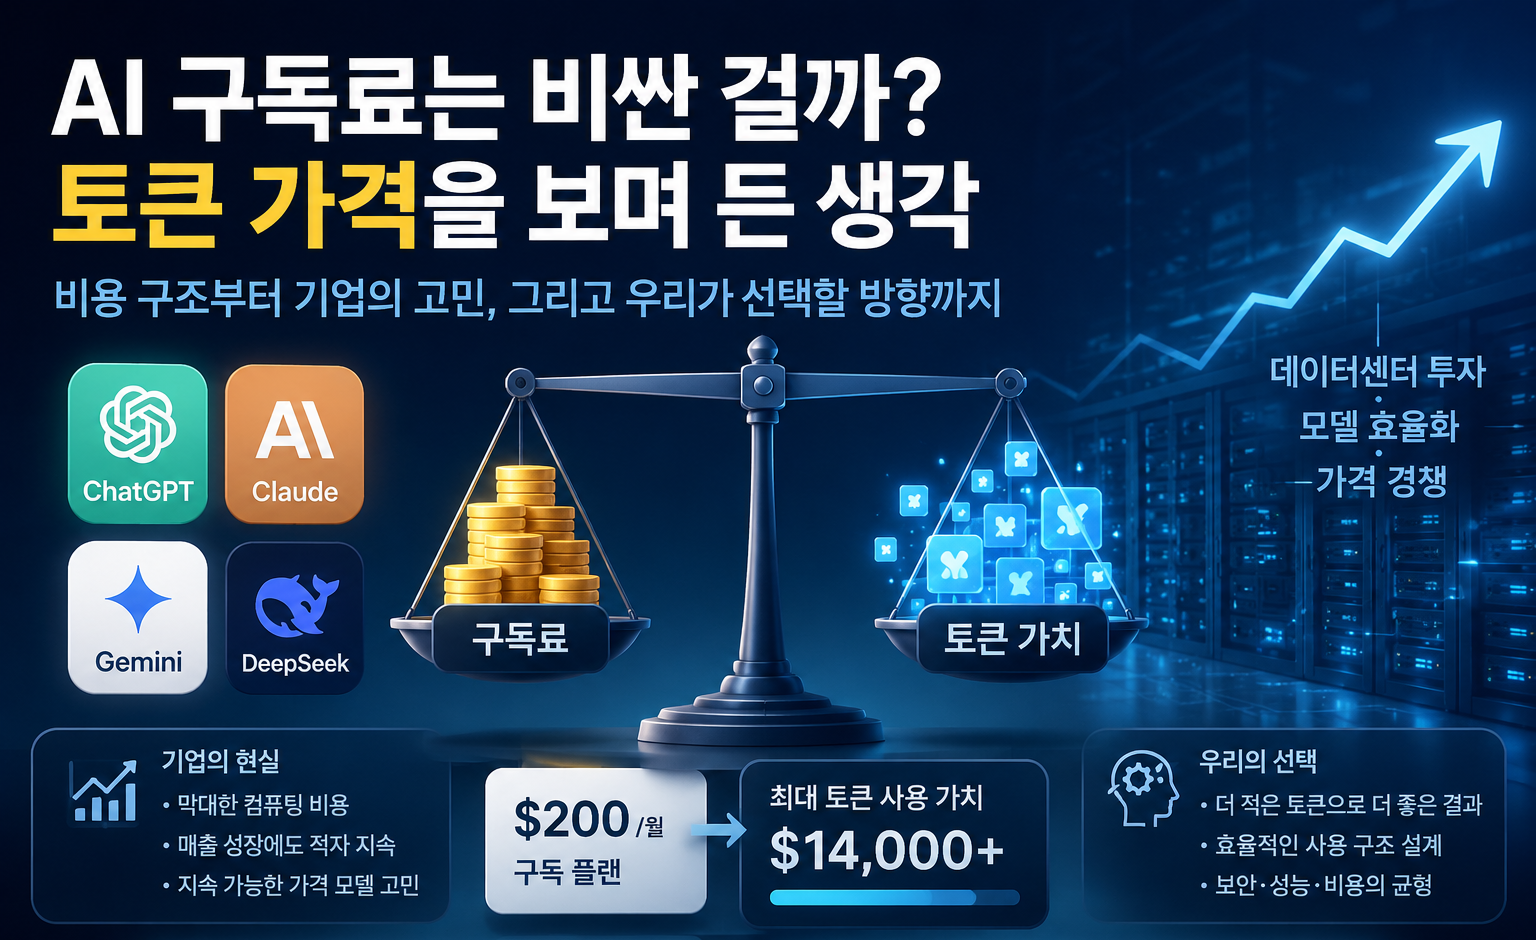
구독료는 비싸 보이지만, 많이 쓰는 사람에게는 싸다
개인 사용자 입장에서 월 20달러, 100달러, 200달러짜리 AI 구독료는 분명 부담스럽게 느껴진다. 특히 ChatGPT, Claude, Gemini, Perplexity처럼 여러 서비스를 동시에 구독하면 매달 나가는 비용이 꽤 커진다.
하지만 매일 업무에 AI를 적극적으로 사용하는 사람이라면 이야기가 조금 달라진다.
문서 요약, 회의 준비, 코드 작성, 번역, 데이터 분석, 아이디어 정리, 이메일 작성 등 다양한 업무에 AI를 계속 활용한다면 구독료 대비 얻는 생산성은 상당히 크다. 실제로 나 역시 초기 GPT부터 사용해오면서, AI가 업무 속도를 얼마나 크게 바꾸는지 체감하고 있다.
문제는 이런 구독 모델이 모든 사용자가 한도를 끝까지 쓰지는 않는다는 전제 위에 있다는 점이다.
대부분의 사용자는 구독료를 내더라도 제공되는 사용량을 전부 쓰지는 않는다. 반면 일부 헤비 유저는 거의 매일 많은 양의 토큰을 사용한다. 서비스 제공사 입장에서는 전체 사용자 평균으로 비용을 맞추는 구조일 가능성이 크다.
그런데 AI 활용이 점점 일상화되고, 더 많은 사용자가 헤비 유저에 가까워진다면 어떻게 될까?
그때는 지금의 구독료 구조가 계속 유지되기 어려울 수도 있다.
OpenAI와 Anthropic도 비용 압박을 받고 있다
OpenAI와 Anthropic은 현재 AI 시장을 이끄는 대표적인 기업이지만, 동시에 막대한 비용을 감당하고 있는 기업이기도 하다.
두 회사 모두 비상장사이기 때문에 공식 감사 재무제표처럼 확정된 수치를 확인하기는 어렵다. 다만 FT, WSJ 등 주요 외신 보도 기준으로 보면, OpenAI와 Anthropic 모두 모델 개발과 추론에 필요한 컴퓨팅 비용으로 인해 큰 손실 또는 손실 압박을 받고 있는 것으로 보인다.
특히 최신 AI 모델은 학습 비용뿐 아니라 실제 사용자가 질문할 때마다 발생하는 추론 비용도 크다.
사용자가 더 긴 문서를 넣고, 더 복잡한 요청을 하고, 에이전트처럼 여러 단계를 수행하는 작업을 맡길수록 토큰 사용량은 계속 늘어난다.
즉, AI 기업 입장에서 비용은 단순히 “모델을 한 번 학습시키는 비용”에서 끝나지 않는다.
사용자가 계속 사용할수록 운영 비용도 함께 발생한다.
이런 구조를 생각하면 현재의 AI 구독료는 단순히 비싸다고만 보기 어렵다. 오히려 시장 확대와 사용자 확보를 위해 어느 정도 낮게 책정된 가격일 수도 있다.
앞으로 AI 가격은 오를까, 내려갈까?
개인적으로는 AI 가격이 한 방향으로만 움직이지는 않을 것 같다.
한쪽에서는 가격 인상 압력이 있다.
최신 모델은 더 강력해지고 있지만, 그만큼 더 많은 연산 자원을 필요로 한다. 특히 고급 추론 모델, 코딩 에이전트, 리서치 에이전트, 장문 문서 분석, 멀티모달 작업처럼 복잡한 요청은 단순한 챗봇 응답보다 훨씬 많은 비용을 발생시킨다.
앞으로 사용자가 AI에게 더 많은 일을 맡기게 되면, 서비스 제공사는 현재의 월정액 구독만으로 모든 사용량을 감당하기 어려워질 수 있다. 이 경우 일정 수준 이상의 사용량에 대해서는 가격 인상, 사용량 제한, 종량제 강화, 고급 기능 분리 같은 변화가 생길 가능성이 있다.
반대로 가격 인하 요인도 있다.
AI 기업들이 대규모 데이터센터를 구축하고 있고, 하드웨어 성능도 계속 개선되고 있다. 모델 최적화, 경량화, 추론 효율 개선, 오픈소스 모델 경쟁도 계속되고 있다. 이런 흐름은 장기적으로 토큰 단가를 낮추는 방향으로 작용할 수 있다.
결국 중요한 것은 “AI 가격이 오른다” 또는 “AI 가격이 내려간다”처럼 단순하게 볼 문제가 아니라는 점이다.
기본적인 모델 사용 비용은 낮아질 수 있다.
하지만 최상위 모델, 장시간 에이전트 작업, 고성능 추론, 기업용 보안 환경, 대규모 자동화 작업은 여전히 비싼 영역으로 남을 수 있다.
즉, AI 가격은 전체적으로 낮아지는 부분과 비싸지는 부분이 동시에 생길 가능성이 크다.
DeepSeek가 보여준 가격 충격, 하지만 보안 문제도 남아 있다
이번 기사에서는 DeepSeek 관련 내용도 언급되었다.
DeepSeek는 비교적 낮은 비용으로 높은 성능을 보여주면서 AI 시장에 큰 가격 압박을 준 모델이다. 실제로 일부 기업들은 기존에 사용하던 고가 모델 대신 DeepSeek 계열 모델을 활용해 비용을 크게 줄였다는 사례도 나오고 있다.
이런 흐름은 분명 긍정적이다.
AI 모델 선택지가 많아지고, 특정 기업의 모델에만 의존하지 않아도 되며, 가격 경쟁이 생기기 때문이다.
하지만 실무 환경에서는 단순히 가격만으로 모델을 선택하기 어렵다.
특히 기업이나 공공기관에서는 데이터 보안, 개인정보, 내부 문서 유출 가능성, 국가별 규제, 모델 제공사의 관할권 문제를 함께 고려해야 한다. 아무리 저렴하고 성능이 좋아도, 민감한 데이터를 다루는 환경에서는 바로 도입하기 어려운 경우가 있다.
그래서 아직은 많은 기업들이 보안과 신뢰성 측면에서 비중국계 모델을 선호하는 흐름도 남아 있다고 생각한다.
결국 가격이 낮은 모델이 등장하는 것은 반가운 일이지만, 모든 상황에서 그 모델을 바로 사용할 수 있는 것은 아니다.
특히 업무 자동화나 기업 내부 데이터 분석처럼 민감한 정보를 다루는 경우에는 가격, 성능, 보안 사이에서 균형을 잡아야 한다.
이제는 “많이 쓰는 것”보다 “잘 쓰는 구조”가 중요해질 수 있다
이 흐름을 보면서 내가 느낀 것은 하나다.
앞으로는 단순히 더 좋은 모델을 찾는 것만으로는 충분하지 않을 수 있다.
AI를 얼마나 많이 쓰느냐보다, 어떻게 하면 더 적은 토큰으로 만족할 만한 결과를 얻을 수 있는지가 중요해질 것 같다.
지금까지는 GPT가 좋은지, Claude가 좋은지, Gemini가 좋은지, DeepSeek가 저렴한지 비교하는 데 집중했다. 물론 모델 선택은 여전히 중요하다. 하지만 비용 구조가 점점 중요해진다면, 모델을 사용하는 방식 자체도 함께 고민해야 한다.
예를 들면 이런 것들이다.
매번 긴 문서를 통째로 넣는 대신 필요한 부분만 찾아서 넣는 방식, 반복되는 배경 설명을 계속 입력하지 않고 요약하거나 캐싱해서 재사용하는 방식, 쉬운 작업은 저렴한 모델에 맡기고 어려운 판단만 고급 모델에 맡기는 방식, 하나의 큰 요청을 작은 단계로 나누어 실패 비용을 줄이는 방식 등이 있다.
또한 에이전트형 작업에서는 더더욱 이런 고민이 필요하다.
사용자가 보기에는 질문 하나를 입력한 것처럼 보이지만, 내부적으로는 검색, 계획, 실행, 검토, 재시도 과정이 여러 번 반복될 수 있다. 이 과정에서 사용자가 직접 인식하지 못하는 토큰 비용이 계속 발생할 수 있다.
따라서 앞으로는 AI를 무작정 많이 쓰는 것보다, AI가 불필요하게 많은 토큰을 쓰지 않도록 작업 구조를 설계하는 것이 중요해질 수 있다.
하네스 엔지니어링도 그중 하나의 방법일 수 있다
내가 이전에 하네스 엔지니어링 관련 글을 정리했던 것도 이런 문제의식과 연결되어 있다.
다만 하네스 엔지니어링이 모든 문제의 정답이라고 생각하는 것은 아니다.
AI 비용을 줄이고 효율을 높이는 방법은 여러 가지가 있다. 모델 라우팅, 프롬프트 최적화, RAG, 캐싱, 워크플로우 분리, 작은 모델 활용, 오픈소스 모델 도입, 내부 데이터 정리, 사용량 모니터링 등 다양한 접근이 가능하다.
하네스 엔지니어링은 그중 하나의 관점이라고 볼 수 있다.
좋은 모델을 고르는 것에서 끝나는 것이 아니라, 그 모델을 어떤 입력과 연결할지, 어떤 도구를 붙일지, 어떤 순서로 실행할지, 어디에서 사람의 검토를 넣을지, 어떤 작업은 자동화하고 어떤 작업은 사람이 판단할지 설계하는 방식이다.
즉, AI를 하나의 독립된 챗봇으로만 보는 것이 아니라 업무 흐름 안에 배치된 하나의 엔진으로 보는 것이다.
엔진 자체의 성능도 중요하지만, 그 엔진을 어떻게 연결하고 제어하느냐에 따라 실제 결과와 비용은 크게 달라질 수 있다.
이런 의미에서 하네스 엔지니어링은 앞으로 AI를 더 효율적으로 쓰기 위한 여러 방법 중 하나로 볼 수 있다.
개인 사용자와 기업 모두에게 필요한 고민
AI 가격이 앞으로 어떻게 조정될지는 아직 알 수 없다.
데이터센터 구축과 모델 최적화로 가격이 낮아질 수도 있고, 반대로 고급 모델과 에이전트 기능은 더 비싼 요금제로 분리될 수도 있다. 구독료는 유지되더라도 사용량 제한이 더 세분화될 수도 있고, 기업용 기능은 보안과 관리 기능을 포함해 더 높은 가격으로 제공될 수도 있다.
중요한 것은 사용자가 이 변화를 수동적으로 받아들이기만 해서는 안 된다는 점이다.
개인 사용자라면 자신이 어떤 작업에 AI를 쓰고 있는지, 어떤 작업에서 실제 생산성이 높아지는지, 굳이 고급 모델을 쓰지 않아도 되는 작업은 무엇인지 점검할 필요가 있다.
기업이라면 더 체계적인 고민이 필요하다.
어떤 업무에 어떤 모델을 쓸 것인지, 내부 데이터는 어디까지 외부 모델에 보낼 수 있는지, 비용은 어떻게 모니터링할 것인지, 보안상 민감한 업무는 어떤 환경에서 처리할 것인지, 반복 업무는 어떻게 표준화할 것인지 정리해야 한다.
결국 AI 활용 능력은 단순히 “좋은 모델을 많이 쓰는 능력”이 아니라 “업무에 맞게 적절한 모델과 구조를 선택하는 능력”에 가까워질 것 같다.
마무리
AI 구독료는 겉으로 보기에는 비싸다.
하지만 실제 토큰 사용량을 기준으로 보면, 많이 쓰는 사용자에게는 지금 가격이 오히려 저렴한 구조일 수 있다.
OpenAI와 Anthropic 같은 주요 AI 기업들도 막대한 컴퓨팅 비용과 손실 압박을 받고 있는 것으로 보인다. 그렇기 때문에 앞으로 AI 가격은 어떤 방식으로든 조정될 가능성이 있다고 생각한다.
물론 데이터센터 구축, 하드웨어 발전, 모델 최적화, DeepSeek와 같은 저가 모델의 등장으로 가격이 낮아지는 영역도 분명 생길 것이다. 하지만 보안, 신뢰성, 고급 추론, 에이전트 작업까지 고려하면 모든 AI 사용 비용이 단순히 싸지기만 할 것이라고 보기는 어렵다.
그래서 앞으로는 AI를 더 많이 쓰는 것만큼이나, 더 효율적으로 쓰는 방법을 고민해야 할 것 같다.
적은 토큰으로도 충분히 좋은 결과를 얻는 구조,
업무에 따라 적절한 모델을 선택하는 방식,
보안과 비용을 함께 고려하는 AI 활용 전략,
그리고 필요하다면 하네스 엔지니어링과 같은 설계 관점까지.
AI를 잘 쓰는 능력은 점점 단순한 프롬프트 작성 능력을 넘어설 것 같다.
앞으로는 어떤 모델을 쓰느냐뿐만 아니라, 그 모델을 어떤 구조 안에서 얼마나 효율적으로 활용하느냐가 더 중요해질 수 있다.
참고 자료
AI타임스, “월 200불로 1만4000불 토큰 제공”…챗GPT·클로드 ‘구독료’ 실체
https://www.aitimes.com/news/articleView.html?idxno=211728
Financial Times, OpenAI spending hit $34bn last year ahead of planned IPO
https://www.ft.com/content/e15b0d7e-ff6b-4f16-ba7a-4068feddb828
The Wall Street Journal, An Inside Look at OpenAI and Anthropic’s Finances Ahead of Their IPOs
https://www.wsj.com/tech/ai/openai-anthropic-ipo-finances-04b3cfb9
Reuters, Australia bans DeepSeek on government devices citing security concerns
https://www.reuters.com/technology/australia-bans-deepseek-government-devices-citing-security-concerns-2025-02-04/
Reuters, Governments, regulators increase scrutiny of DeepSeek
https://www.reuters.com/technology/artificial-intelligence/governments-regulators-increase-scrutiny-deepseek-2025-02-06/
arXiv, Tiered Super-Moore’s Law: Price Evolution, Production Frontiers, and Market Competition in Large Language Model Inference Services
https://arxiv.org/abs/2603.28576
arXiv, The Price of Progress: Algorithmic Efficiency and the Falling Cost of AI Inference
https://arxiv.org/abs/2510.04821
'Tech Notes' 카테고리의 다른 글
| 클라우드 LLM 시대에도 온디바이스 AI가 필요한 이유: Google Frozen MTP (0) | 2026.06.29 |
|---|---|
| Loop Engineering: AI에게 질문하는 것을 넘어, 일을 끝내는 구조 만들기 (0) | 2026.06.23 |
| Claude Code, OpenCode, Codex CLI로 보는 LLM Agent 오케스트레이션 (0) | 2026.06.12 |
| LLM 에이전트 시대의 오케스트레이션: 여러 작업과 도구를 하나의 흐름으로 연결하기 (0) | 2026.06.10 |
| LLM 에이전트 시대의 하네스 엔지니어링: 모델을 일하는 시스템으로 만드는 실행 틀 (0) | 2026.06.08 |


