LLM Agent에서 Harness Engineering이 왜 등장했는지, 어떤 역할을 하는지, 실제 서비스와 업무 자동화에서 어떻게 사용되는지 쉽게 정리합니다.
요즘 LLM을 활용한 서비스는 단순히 질문에 답하는 챗봇에서 점점 벗어나고 있다.
이제 LLM은 문서를 읽고, 파일을 수정하고, 코드를 실행하고, 검색을 수행하고, 이메일 초안을 만들고, 때로는 여러 도구를 조합해 하나의 업무를 끝까지 처리한다.
이런 흐름에서 최근(?)까지는 아니지만 자주 볼 수 있는 개념이 있다.
바로 하네스 엔지니어링(Harness Engineering)이다.
처음 들으면 조금 생소하다. 하네스라고 하면 전기 배선이나 케이블 묶음을 떠올릴 수도 있다. 하지만 LLM과 에이전트 문맥에서의 하네스는 전혀 다른 의미다.
LLM에서 하네스는 모델을 감싸고 있는 실행 틀, 통제 구조, 작업 환경을 의미한다.
쉽게 말해, LLM이 단순히 답변만 하는 것이 아니라 실제 작업을 수행할 수 있도록 도구, 권한, 상태, 검증, 로그, 실패 복구를 관리하는 시스템이다.
한 문장으로 정리하면 다음과 같다.
하네스 엔지니어링은 LLM을 그냥 호출하는 것이 아니라, LLM이 안전하고 반복 가능하게 일할 수 있도록 실행 환경을 설계하는 일이다.
1. 왜 하네스라는 개념이 등장했을까?
초기의 LLM 활용은 비교적 단순했다.
사용자가 질문을 하면 모델이 답변했다.
사용자 질문
  ↓
LLM 답변
예를 들어 이런 식이다.
사용자: 이 문장 영어로 번역해줘.
LLM: ...
이 단계에서는 프롬프트가 가장 중요했다. 어떻게 질문해야 더 좋은 답변이 나오는지, 어떤 역할을 부여해야 하는지가 핵심이었다.
그래서 한동안은 프롬프트 엔지니어링(Prompt Engineering)이 큰 관심을 받았다.
하지만 LLM 활용이 실제 업무 자동화와 에이전트로 확장되면서 문제가 달라졌다. 이제 사용자는 단순히 “답변해줘”가 아니라 이런 요청을 한다.
이 프로젝트 코드에서 오류를 찾아서 수정하고 테스트까지 돌려줘.
또는
사내 문서에서 특정 요구사항을 찾아 요약하고 근거까지 표시해줘.
이런 요청은 단순 답변이 아니다.
LLM이 여러 단계를 거쳐 실제 작업을 수행해야 한다.
파일 읽기
문서 검색
도구 호출
결과 해석
코드 수정
테스트 실행
실패 시 재시도
최종 결과 검증
이때 모델에게 모든 것을 자유롭게 맡기면 위험하다.
LLM은 그럴듯한 답변을 잘하지만, 실제 시스템에서는 다음과 같은 문제가 생길 수 있다.
- 존재하지 않는 파일을 읽었다고 말할 수 있다.
- 테스트를 실행하지 않았는데 성공했다고 말할 수 있다.
- 권한이 없는 데이터에 접근하려고 할 수 있다.
- 외부 도구의 결과를 잘못 해석할 수 있다.
- 실패한 작업을 성공한 것처럼 마무리할 수 있다.
- 중요한 파일이나 데이터를 잘못 수정할 수 있다.
그래서 LLM이 실제 행동을 하기 위해서는 “무엇을 할 수 있고, 무엇을 하면 안 되는지”를 정해주는 실행 구조가 필요하다.
이 구조가 바로 Agent Harness다.
2. 하네스는 프롬프트와 무엇이 다를까?
프롬프트는 LLM에게 말로 지시하는 것이다.
예를 들면 다음과 같다.
너는 시니어 개발자야.
코드를 분석하고 오류를 찾아줘.
답변은 간결하게 작성해.
반면 하네스는 LLM이 실제로 행동하는 환경을 설계하는 것이다.
예를 들면 다음과 같다.
LLM은 src 폴더 안의 파일만 읽을 수 있다.
LLM은 package-lock.json은 수정하면 안 된다.
코드를 수정한 후에는 반드시 테스트를 실행해야 한다.
테스트가 실패하면 최대 3번까지 재시도할 수 있다.
운영 서버 배포는 사람 승인이 필요하다.
최종 답변에는 변경한 파일과 테스트 결과를 포함해야 한다.
즉, 프롬프트가 말의 규칙이라면,
하네스는 행동의 규칙이다.
프롬프트 엔지니어링이 “LLM에게 어떻게 말할 것인가”에 가깝다면,
하네스 엔지니어링은 “LLM이 어떤 환경에서 어떻게 행동하게 만들 것인가”에 가깝다.
3. Agent Harness란 무엇인가?
LLM 에이전트에서 하네스는 보통 다음과 같은 역할을 한다.
사용자 요청
  ↓
LLM 판단
  ↓
도구 사용 여부 결정
  ↓
하네스가 권한 확인
  ↓
도구 실행
  ↓
결과를 다시 LLM에게 전달
  ↓
다음 행동 판단
  ↓
검증 후 최종 응답
LLM은 판단을 담당한다.
도구는 실제 행동을 담당한다.
하네스는 그 사이에서 실행 흐름을 관리한다.
조금 더 쉽게 비유하면 다음과 같다.
LLM = 뇌
Tool = 손과 발
Memory = 작업 기억
Harness = 몸 전체를 통제하는 실행 시스템
LLM이 아무리 똑똑해도, 손과 발이 없으면 실제 업무를 처리할 수 없다.
반대로 손과 발을 너무 자유롭게 움직이게 하면 위험할 수 있다.
하네스는 LLM이 도구를 사용할 수 있게 해주면서도, 안전한 범위 안에서만 움직이도록 제한한다.
4. 하네스 엔지니어링의 핵심 구성요소
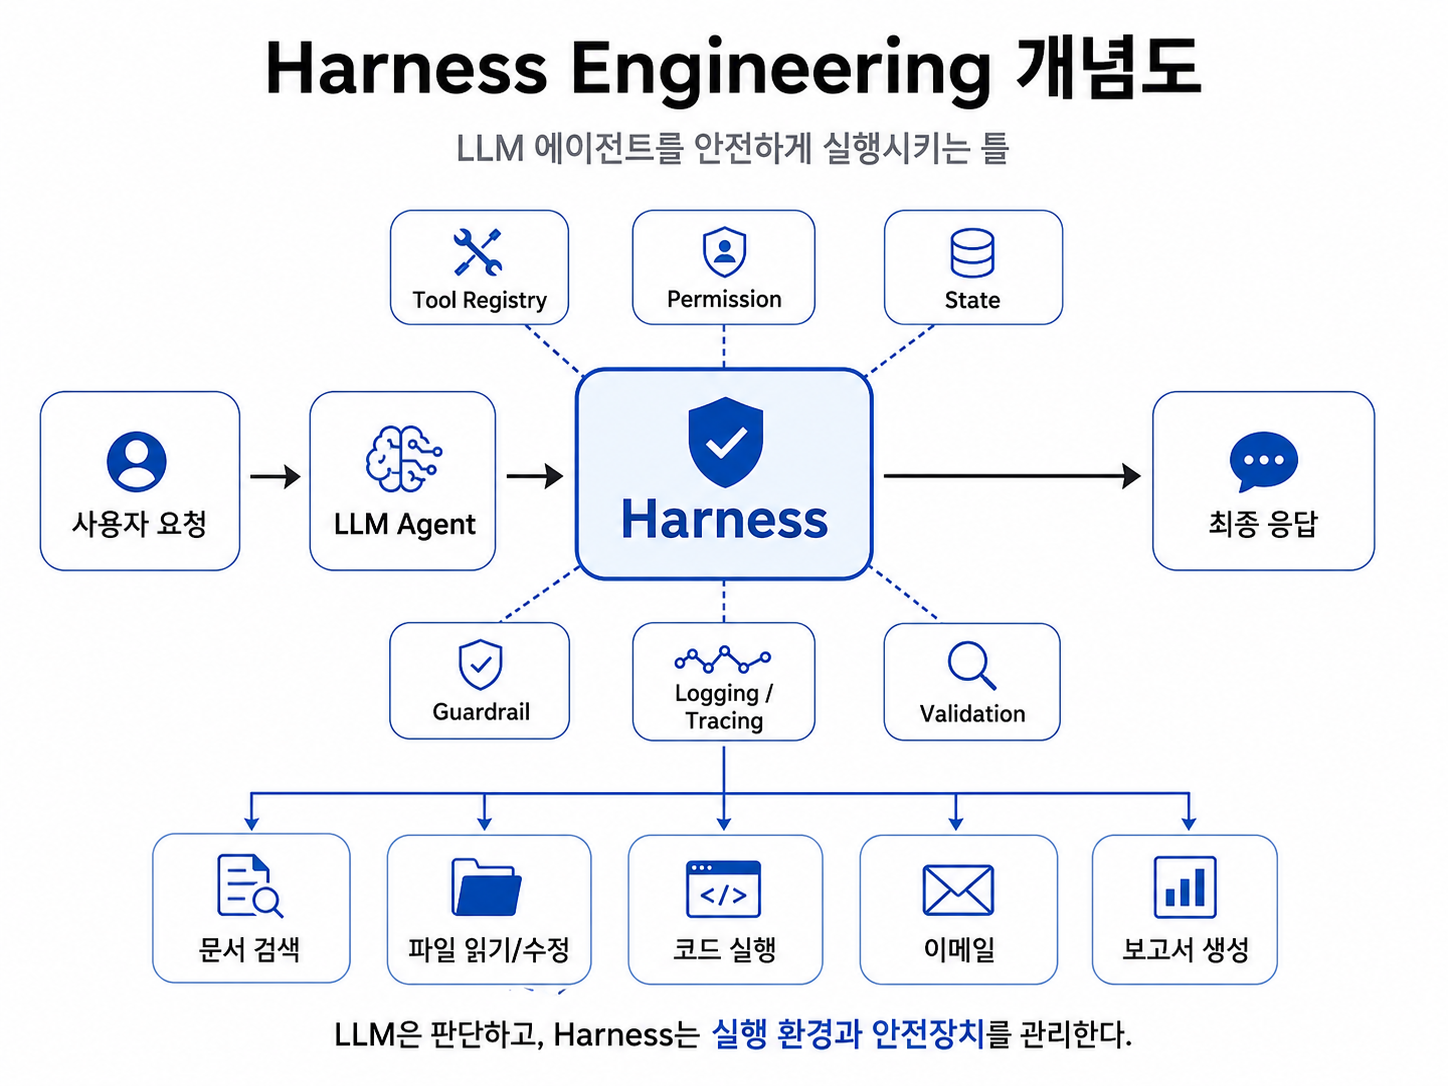
LLM 에이전트에서 하네스를 설계할 때는 보통 다음 요소들을 고려한다.
4.1 Tool Registry
에이전트가 사용할 수 있는 도구 목록이다.
예를 들면 다음과 같다.
read_file
write_file
search_docs
search_web
run_python
run_test
send_email
create_excel
call_manager
display_map
Tool Registry는 단순히 도구 이름만 모아두는 것이 아니다.
각 도구가 어떤 입력을 받고, 어떤 출력을 반환하며, 어떤 상황에서 사용할 수 있는지를 정의한다.
예를 들어 문서 검색 도구는 다음과 같이 정의할 수 있다.
Tool: search_docs
Input: 검색어
Output: 관련 문서 조각 목록
Rule: 사내 문서 질문에만 사용
이렇게 도구를 명확히 정의해야 LLM이 적절한 도구를 선택할 수 있다.
4.2 Permission System
에이전트가 할 수 있는 일과 할 수 없는 일을 나누는 권한 시스템이다.
예를 들어 코딩 에이전트라면 다음과 같은 권한이 필요하다.
허용:
- 파일 읽기
- 일부 파일 수정
- 테스트 실행
- 로그 확인

금지:
- 운영 DB 삭제
- 비밀키 출력
- 전체 시스템 파일 수정
- 사용자 승인 없는 배포
에이전트가 실제 작업을 수행할수록 권한 관리는 중요해진다.
특히 파일 수정, 이메일 전송, 결제, 배포, 외부 API 호출처럼 부작용이 있는 작업은 반드시 제한이 필요하다.
4.3 State Management
에이전트가 현재 어디까지 작업했는지 기억하는 구조다.
사람이 업무를 할 때도 지금 어떤 파일을 봤는지, 어떤 오류를 발견했는지, 어떤 테스트가 실패했는지 기억해야 한다.
에이전트도 마찬가지다.
현재 작업 목표
읽은 파일 목록
사용한 도구 결과
발견한 오류
수정한 내용
실패한 테스트 로그
다음에 해야 할 일
이런 상태가 관리되지 않으면 에이전트는 같은 작업을 반복하거나, 이전 결과를 잊고 엉뚱한 결정을 할 수 있다.
4.4 Execution Loop
에이전트의 핵심은 반복 실행이다.
단순 챗봇은 한 번 답변하고 끝난다.
하지만 에이전트는 보통 여러 번 생각하고 행동한다.
생각한다
도구를 선택한다
도구를 실행한다
결과를 본다
다음 행동을 결정한다
다시 실행한다
완료 조건을 확인한다
이 반복 구조를 흔히 agent loop라고 볼 수 있다.
예를 들어 코딩 에이전트는 다음처럼 움직인다.
1. 관련 파일을 찾는다.
2. 코드를 읽는다.
3. 문제 원인을 추론한다.
4. 코드를 수정한다.
5. 테스트를 실행한다.
6. 실패하면 로그를 읽고 다시 수정한다.
7. 성공하면 변경 내용을 요약한다.
하네스는 이 반복이 무한히 돌지 않도록 제한하고, 언제 종료할지도 관리한다.
4.5 Guardrail
Guardrail은 에이전트가 위험한 행동을 하지 않도록 막는 안전장치다.
예를 들면 다음과 같다.
개인정보가 포함된 답변은 차단한다.
운영 환경 파일은 수정하지 못하게 한다.
외부 이메일 전송 전에는 사용자 승인을 받는다.
검색 결과에 없는 내용을 사실처럼 말하지 못하게 한다.
Guardrail은 입력 단계에 적용될 수도 있고, 도구 실행 전후에 적용될 수도 있고, 최종 출력 직전에 적용될 수도 있다.
즉, 하네스는 단순히 “작업을 잘 하게 하는 구조”가 아니라, “잘못된 작업을 막는 구조”이기도 하다.
4.6 Logging & Tracing
에이전트가 어떤 판단을 했고, 어떤 도구를 사용했으며, 어떤 결과를 받았는지 기록하는 기능이다.
일반적인 LLM 답변에서는 결과만 보면 된다.
하지만 에이전트에서는 과정이 중요하다.
예를 들어 최종 결과가 맞더라도, 중간에 권한 없는 파일을 읽었다면 문제가 될 수 있다.
또는 결과가 틀렸을 때 어디서 잘못되었는지 추적해야 한다.
그래서 하네스는 다음과 같은 정보를 기록한다.
어떤 프롬프트가 사용되었는가?
어떤 도구가 호출되었는가?
도구 입력값은 무엇이었는가?
도구 출력값은 무엇이었는가?
어느 단계에서 실패했는가?
재시도는 몇 번 발생했는가?
최종 결과는 어떤 기준으로 통과되었는가?
이 기록이 있어야 에이전트를 디버깅하고 개선할 수 있다.
4.7 Evaluation & Regression Test
하네스는 실행뿐 아니라 평가에도 사용된다.
LLM 서비스는 프롬프트 하나만 바뀌어도 결과가 달라질 수 있다.
모델 버전이 바뀌어도 성능이 달라질 수 있다.
검색 top-k, chunk size, tool 설명이 조금만 바뀌어도 결과 품질이 바뀔 수 있다.
그래서 에이전트 시스템에서는 다음과 같은 평가가 필요하다.
이전보다 정확도가 떨어지지 않았는가?
문서에 없는 내용을 말하지 않는가?
도구를 올바른 순서로 사용하는가?
금지된 행동을 하지 않는가?
실패했을 때 적절히 복구하는가?
비용과 응답 시간은 허용 범위 안인가?
하네스는 이런 평가를 자동화해서, LLM 앱도 일반 소프트웨어처럼 테스트하고 배포할 수 있게 만든다.
5. 실제 예시 1: 코딩 에이전트
가장 이해하기 쉬운 예시는 코딩 에이전트다.
사용자가 이렇게 요청했다고 하자.
로그인 버튼을 눌러도 반응이 없는 문제를 고쳐줘.
일반 LLM이라면 이렇게 답할 수 있다.
onClick 핸들러가 연결되어 있는지 확인해보세요.
AuthContext 또는 라우팅 로직도 확인해보는 것이 좋습니다.
나쁘지 않은 답변이지만, 실제로 문제를 해결한 것은 아니다.
하네스가 있는 코딩 에이전트는 다르게 동작한다.
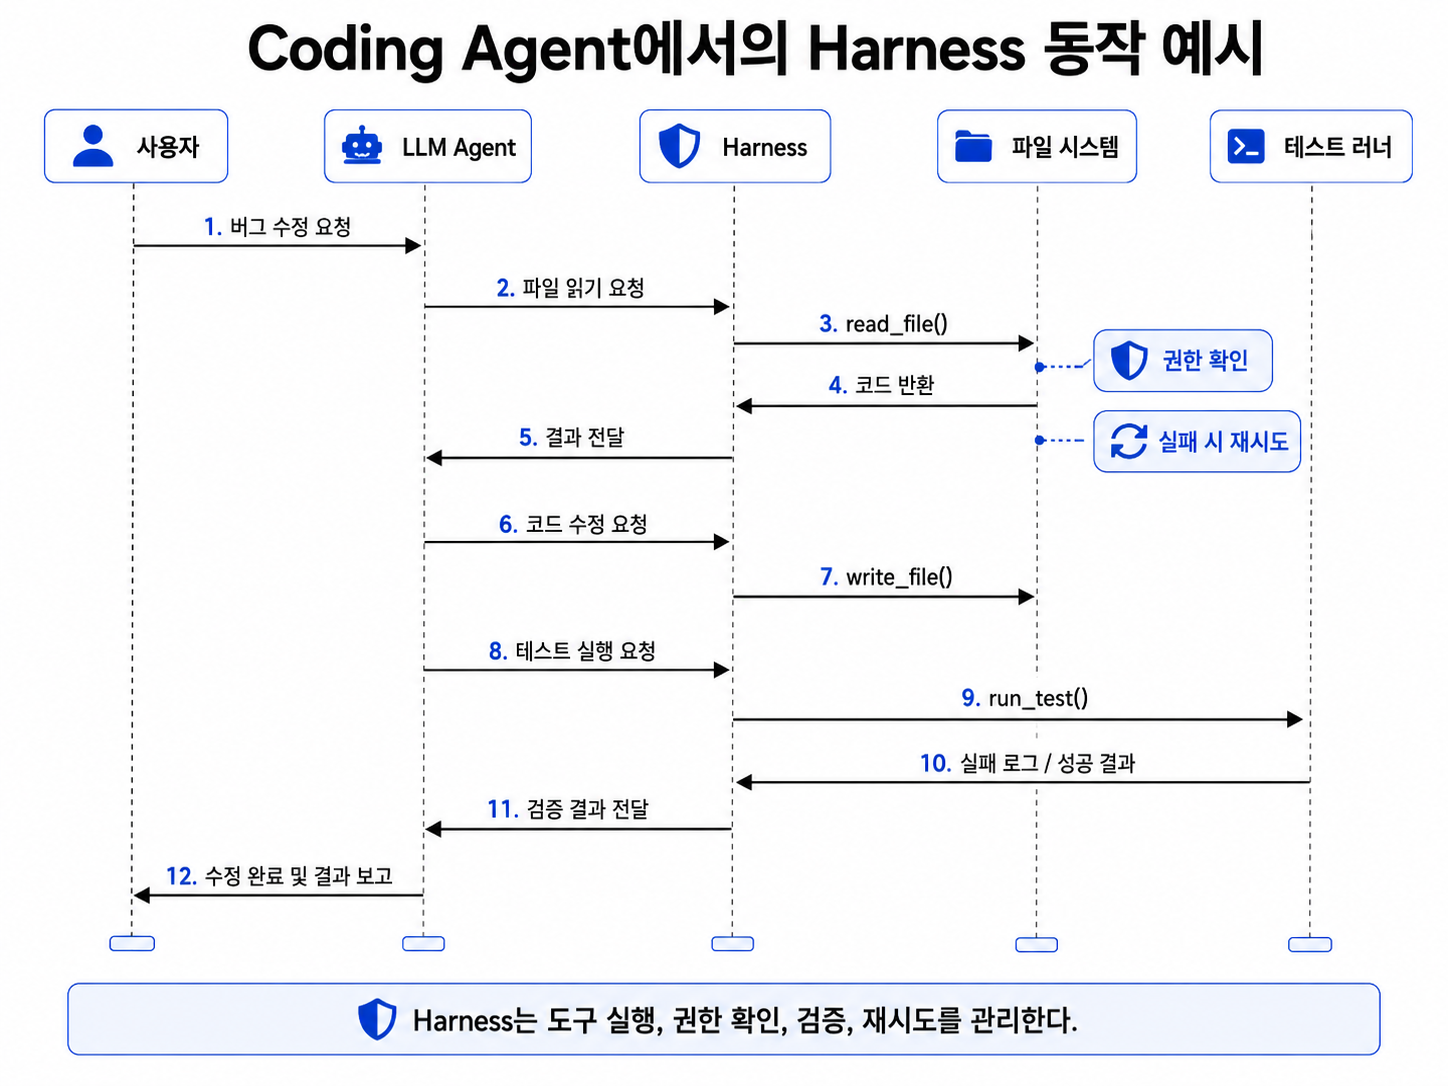
여기서 하네스는 다음을 관리한다.
어떤 파일을 읽을 수 있는가?
어떤 파일을 수정할 수 있는가?
어떤 명령어를 실행할 수 있는가?
테스트 실패 시 몇 번까지 재시도할 수 있는가?
작업 완료 전 어떤 검증을 해야 하는가?
즉, 코딩 에이전트의 성능은 모델의 추론 능력만으로 결정되지 않는다.
파일 접근, 테스트 실행, 로그 해석, 수정 권한, 실패 복구를 관리하는 하네스가 함께 있어야 실제로 쓸 수 있는 에이전트가 된다.
6. 실제 예시 2: 사내 문서 검색 Agent
이번에는 RAG 기반 문서 검색 에이전트를 생각해보자.
사용자가 이렇게 묻는다.
신입사원 출퇴근 지침을 온보딩 문서에서 찾아서 정리해줘.이때 LLM이 기억에 의존해 답변하면 위험하다.
문서에 없는 내용을 만들어낼 수도 있기 때문이다.
하네스가 있는 문서 검색 에이전트는 다음과 같이 동작한다.
1. 사용자 질문을 검색어로 변환한다.
2. 사내 문서 저장소에서 관련 문서를 검색한다.
3. 관련 문서 조각을 가져온다.
4. LLM이 문서 기반으로만 요약한다.
5. 답변에 근거 문서를 포함한다.
6. 문서에 없는 내용은 확인 필요로 표시한다.
여기서 하네스는 다음 규칙을 강제할 수 있다.
검색 결과가 없으면 추측하지 않는다.
답변에는 반드시 문서명을 포함한다.
근거가 부족한 항목은 "확인 필요"로 표시한다.
외부 웹 검색은 사용하지 않는다.
기밀 문서는 권한이 있을 때만 검색한다.
이런 구조가 있어야 RAG 에이전트가 단순히 “그럴듯한 답변”을 하는 것이 아니라, 실제 문서 기반의 신뢰 가능한 업무 도구가 된다.
7. 실제 예시 3: 로봇 Agent
하네스 엔지니어링은 로봇 Agent에서도 중요하게 사용될 수 있다.
예를 들어 실내 안내 로봇에게 사용자가 다음과 같이 요청했다고 해보자.
회의실 A로 가서 비어 있는지 확인하고, 사람이 있으면 방해하지 말고 돌아와줘.이때 에이전트는 여러 정보를 읽어야 한다.
현재 위치 확인
회의실 위치 검색
이동 경로 생성
주변 장애물 확인
카메라 또는 센서 상태 확인
회의실 점유 여부 판단
사용자에게 결과 보고
이때 LLM은 사용자의 요청을 이해하고 다음 행동을 판단할 수 있다.
하지만 LLM이 로봇의 이동이나 모터 제어를 직접 실행하면 위험할 수 있다.
그래서 중간에 하네스가 필요하다.
하네스는 LLM이 사용할 수 있는 기능을 제한하고, 실제 행동이 안전한지 확인한다.
사용자 요청
  ↓
LLM Agent
  ↓
Harness
  ├─ 위치 정보 확인
  ├─ 지도 검색
  ├─ 센서 상태 확인
  ├─ 이동 가능 여부 검증
  ├─ 안전 정책 확인
  └─ 결과 보고
  ↓
로봇 제어 시스템
예를 들어 하네스는 다음과 같은 조건을 확인할 수 있다.
장애물이 없는가?
사람과의 안전 거리가 확보되었는가?
센서 값이 정상인가?
접근 가능한 구역인가?
조건이 만족되면 로봇 제어 시스템에 이동 요청을 전달하고, 조건이 맞지 않으면 이동을 중단하거나 사용자에게 확인을 요청한다.
즉, 로봇 Agent에서 LLM은 “무엇을 해야 하는지”를 판단하고, 하네스는 “그 행동을 실제로 해도 되는지”를 검증한다.
이처럼 하네스는 LLM의 판단이 실제 물리 세계에서 안전하게 실행되도록 돕는 실행 틀이자 안전장치라고 볼 수 있다.
8. 하네스 엔지니어링에서 설계해야 하는 질문들
하네스 엔지니어링은 결국 다음 질문에 답하는 일이다.
1) 에이전트는 어떤 도구를 사용할 수 있는가?
파일 읽기
파일 수정
문서 검색
웹 검색
코드 실행
DB 조회
이메일 작성
보고서 생성
2) 각 도구는 어떤 조건에서 사용할 수 있는가?
문서 검색은 항상 가능
파일 수정은 특정 폴더에서만 가능
이메일 전송은 사용자 승인 필요
DB 삭제는 금지
운영 서버 배포는 관리자 승인 필요
3) 에이전트는 무엇을 기억해야 하는가?
현재 목표
지금까지 사용한 도구
중간 결과
실패한 시도
사용자 선호
작업 완료 조건
4) 실패했을 때 어떻게 해야 하는가?
다시 시도할 것인가?
다른 도구를 사용할 것인가?
사용자에게 확인할 것인가?
작업을 중단할 것인가?
이전 상태로 되돌릴 것인가?
5) 결과가 맞는지 어떻게 검증할 것인가?
테스트가 통과했는가?
파일이 실제로 생성되었는가?
문서 근거가 포함되었는가?
금지된 정보가 포함되지 않았는가?
비용과 시간이 허용 범위 안인가?
이 질문에 대한 답이 명확할수록 에이전트는 더 안정적으로 동작한다.
9. 하네스가 약하면 어떤 문제가 생길까?
좋은 모델을 사용하더라도 하네스가 약하면 실제 서비스 품질은 낮아질 수 있다.
예를 들어 다음과 같은 문제가 발생할 수 있다.
도구를 잘못 선택한다.
필요한 도구를 호출하지 않는다.
도구 결과를 무시하고 답변한다.
실패한 작업을 성공했다고 말한다.
같은 행동을 계속 반복한다.
권한 없는 정보에 접근한다.
중간 과정이 기록되지 않아 디버깅이 어렵다.
이런 문제는 모델만 바꾼다고 해결되지 않는다.
실행 구조 자체를 개선해야 한다.
그래서 에이전트 시스템에서는 “어떤 모델을 쓸 것인가”만큼이나 “어떤 하네스를 설계할 것인가”가 중요해지고 있다.
10. 하네스 엔지니어링과 오케스트레이션의 차이
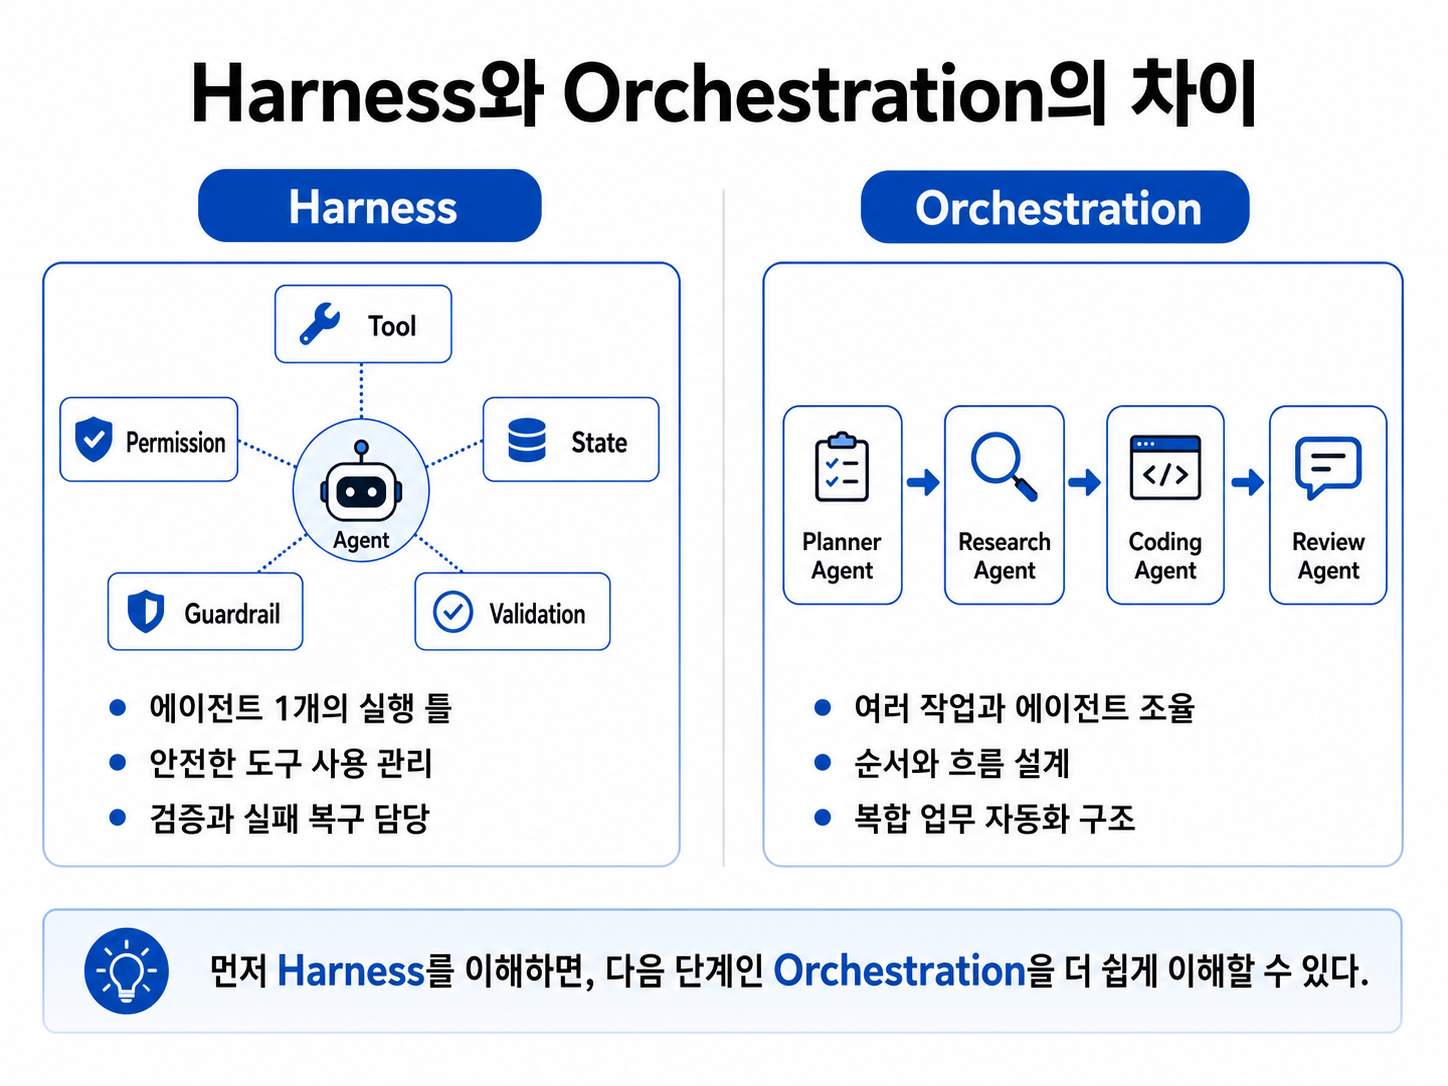
여기서 자연스럽게 다음 개념으로 넘어가게 된다.
바로 오케스트레이션(Orchestration)이다.
하네스와 오케스트레이션은 비슷해 보이지만 관심사가 조금 다르다.
하네스는 하나의 에이전트가 안전하게 실행되도록 감싸는 구조에 가깝다.
반면 오케스트레이션은 여러 작업, 여러 도구, 여러 에이전트를 어떤 순서와 구조로 연결할 것인가에 더 가깝다.
즉, 하네스가 “에이전트 하나가 어떻게 안전하게 일할 것인가”에 가깝다면,
오케스트레이션은 “여러 에이전트와 작업 흐름을 어떻게 조율할 것인가”에 가깝다.
조금 비유하면 다음과 같다.
하네스 = 한 명의 작업자가 안전하게 일하도록 만든 작업 장비와 규칙
오케스트레이션 = 여러 작업자를 어떤 순서로 배치하고 협업시킬지 정하는 운영 방식
그래서 에이전트 시스템을 이해할 때는 먼저 하네스를 이해하는 것이 좋다.
LLM이 어떤 도구를 사용할 수 있고, 어떤 권한을 가지며, 어떤 방식으로 검증되는지를 알아야 그다음에 여러 에이전트를 엮는 구조도 이해할 수 있기 때문이다.
11. 정리
LLM 에이전트 시대에는 모델 자체만으로는 충분하지 않다.
좋은 모델이 있어도 실행 환경이 부실하면 실제 업무에 쓰기 어렵다.
반대로 모델 성능이 아주 압도적이지 않더라도, 하네스가 잘 설계되어 있으면 더 안정적인 시스템을 만들 수 있다.
하네스 엔지니어링은 LLM이 실제 작업을 수행하기 위해 필요한 실행 틀을 설계하는 일이다.
핵심 요소는 다음과 같다.
도구 정의
권한 관리
상태 관리
실행 루프
가드레일
로그와 트레이싱
평가와 검증
실패 복구
결국 하네스는 LLM을 단순한 답변 생성기에서 실제로 일할 수 있는 에이전트로 바꿔주는 구조다.
앞으로 LLM 서비스는 단순히 “어떤 모델을 썼는가”보다 “그 모델을 어떤 하네스 안에서 실행시키는가”가 더 중요해질 가능성이 크다.
다음 글에서는 이 하네스 위에서 여러 에이전트와 도구를 어떻게 연결하고 조율하는지, 즉 오케스트레이션(Orchestration)에 대해 정리해보려고 한다.
'Tech Notes' 카테고리의 다른 글
| 클라우드 LLM 시대에도 온디바이스 AI가 필요한 이유: Google Frozen MTP (0) | 2026.06.29 |
|---|---|
| Loop Engineering: AI에게 질문하는 것을 넘어, 일을 끝내는 구조 만들기 (0) | 2026.06.23 |
| AI 구독료는 정말 비싼 걸까? 토큰 가격을 보며 든 생각 (0) | 2026.06.16 |
| Claude Code, OpenCode, Codex CLI로 보는 LLM Agent 오케스트레이션 (0) | 2026.06.12 |
| LLM 에이전트 시대의 오케스트레이션: 여러 작업과 도구를 하나의 흐름으로 연결하기 (0) | 2026.06.10 |


