이전 글에서는 Anthropic이 발표한 Claude Fable 5와 Claude Mythos 5가 어떤 모델인지 정리했다.
간단히 다시 정리하면, Claude Fable 5는 일반 사용자가 사용할 수 있는 Mythos-class 모델이고, Claude Mythos 5는 일부 안전장치가 완화된 제한 접근 모델이다. Anthropic은 Fable 5를 공개하면서 사이버보안, 생물학, 화학, 모델 증류와 같은 민감 영역에 대해 별도의 안전장치를 적용했다고 설명했다.
그런데 Fable 5 출시 직후, 모델 성능이나 벤치마크보다 더 큰 논란이 생겼다.
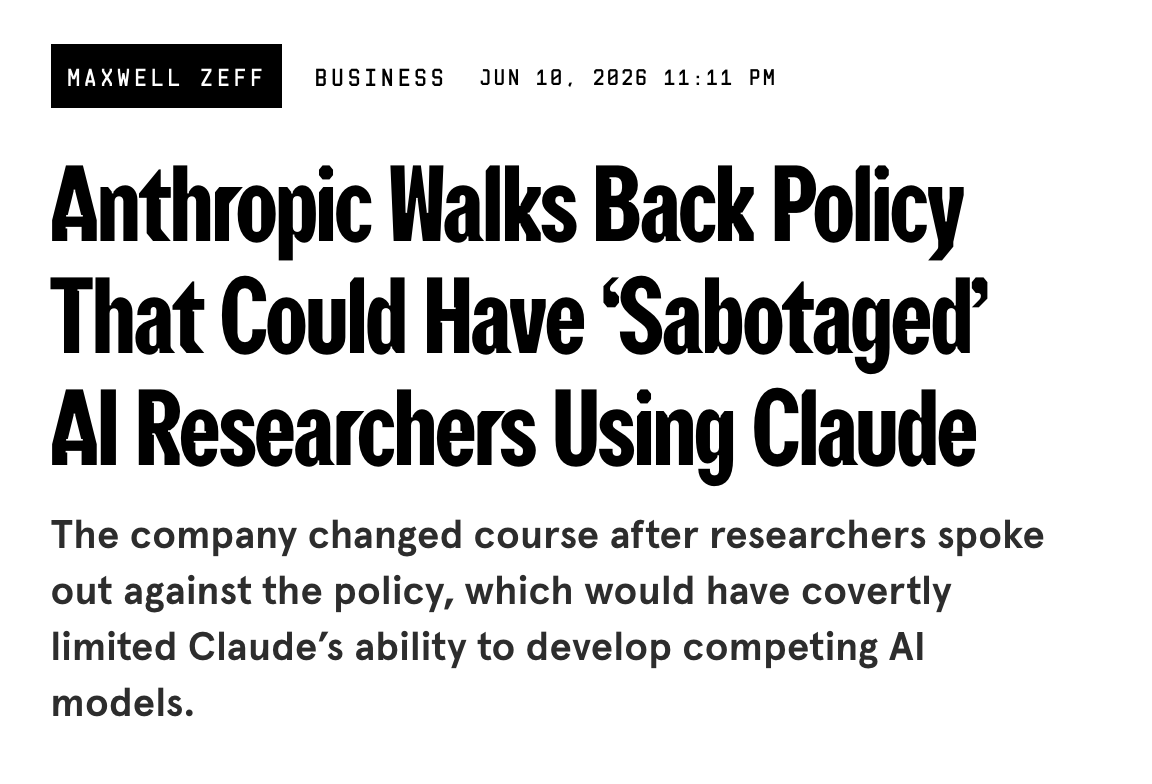
논란의 핵심은 Fable 5에 적용된 일부 안전장치가 사용자에게 보이지 않는 방식으로 동작할 수 있었다는 점이다. Fortune과 WIRED 보도에 따르면, Fable 5는 일부 AI 연구·개발 관련 요청에서 사용자가 알지 못하는 상태로 응답의 효과를 낮출 수 있도록 설계되어 있었다.
일부 커뮤니티에서는 이를 “secret sabotage”, 즉 “비밀 사보타주”라고 표현했다. 다소 강한 표현이지만, 논란의 핵심은 “제한이 있느냐”보다 “그 제한을 사용자에게 알리지 않았느냐”에 가까웠다.
이번 글에서는 이 논란이 무엇인지, Anthropic은 왜 이런 방식을 고려했는지, AI 연구자와 개발자들은 왜 반발했는지, 그리고 이후 Anthropic이 어떤 입장 변화를 보였는지 정리해보려고 한다.
1. Claude Fable 5의 안전장치 구조
Claude Fable 5는 Anthropic이 일반 공개한 가장 강력한 모델 중 하나로 소개되었다. 하지만 Anthropic은 이 모델이 일부 고위험 영역에서 악용될 수 있다고 보고, Fable 5에 여러 safety classifier를 적용했다.
여기서 classifier는 사용자의 요청이 특정 위험 영역에 해당하는지 감지하는 장치라고 이해할 수 있다.
Fable 5에서 주요하게 언급된 제한 영역은 다음과 같다.
- 사이버 보안: 취약점 발견, exploit 개발, 공격 자동화 등으로 악용될 수 있는 요청
- 생물학/화학: 위험한 생물학·화학 연구에 활용될 수 있는 요청
- 모델 증류: Claude의 능력을 추출해 다른 모델을 학습시키려는 요청
- frontier LLM development: 대규모 AI 모델 개발, 학습 인프라, 모델 훈련 파이프라인 등과 관련된 요청
사이버보안, 생물학, 화학, 모델 증류와 관련된 요청은 Fable 5가 직접 처리하지 않고 더 제한적인 모델인 Claude Opus 4.8로 fallback될 수 있다. 이 경우 사용자는 Fable 5가 아니라 다른 모델이 응답한다는 사실을 알 수 있다.
즉, 일반적인 안전장치 구조는 다음과 같다.
사용자 요청
→ classifier가 고위험 요청인지 판단
→ 고위험 요청이면 Fable 5가 직접 응답하지 않음
→ Opus 4.8로 fallback
→ 사용자에게 fallback 사실 고지
여기까지는 비교적 이해하기 쉬운 방식이다.
문제가 된 부분은 frontier LLM development 관련 요청이었다.
2. 논란의 핵심: 보이지 않는 성능 제한
Fortune 보도에 따르면, 논란은 Claude Fable 5의 system card에 포함된 한 문단에서 시작되었다. 해당 문서에는 Fable 5가 frontier LLM development 관련 요청을 감지했을 때, 사용자에게 보이지 않는 방식으로 모델의 효과를 제한할 수 있다는 내용이 포함되어 있었다.
여기서 frontier LLM development는 대략 다음과 같은 영역을 의미한다.
- 대규모 언어모델 학습 파이프라인 구축
- 분산 학습 인프라 설계
- AI accelerator 또는 ML accelerator 최적화
- frontier model 개발을 직접 가속할 수 있는 기술 지원
- 고성능 AI 모델을 만드는 데 필요한 연구·엔지니어링 작업
즉, 사용자가 Claude Fable 5에게 다른 고성능 AI 모델 개발에 도움이 될 만한 질문을 하면, 모델이 겉으로는 정상적으로 답변하는 것처럼 보이지만 실제로는 의도적으로 덜 유용한 답변을 할 수 있다는 의미다.
문제는 이 제한이 사용자에게 보이지 않았다는 점이다. 사용자 입장에서는 다음 두 가지 상황을 구분하기 어렵다.
| 상황 | 사용자 입장에서 보이는 모습 |
| 모델이 원래 잘 몰라서 답변이 부족함 | 답변 품질이 낮아 보임 |
| 안전장치가 작동해 일부러 답변 품질이 낮아짐 | 역시 답변 품질이 낮아 보임 |
즉, 사용자는 모델이 실제로 부족해서 답을 못한 것인지, 아니면 정책 때문에 일부러 덜 유용하게 답한 것인지 알 수 없다.
이 부분이 “비밀 사보타주”라는 표현까지 나오게 된 이유다.
3. 기존 안전장치와 무엇이 달랐나?
이번 논란을 이해하려면 Fable 5의 다른 안전장치와 비교해보는 것이 좋다.
| 구분 | 처리 방식 | 고지 여부 |
| 사이버보안 요청 | Opus 4.8로 fallback | 고지됨 |
| 생물학/화학 요청 | Opus 4.8로 fallback | 고지됨 |
| 모델 증류 요청 | Opus 4.8로 fallback | 고지됨 |
| frontier LLM development 요청 | 응답 효과 제한 | 초기 설계상 고지되지 않음 |
즉, 사이버보안이나 생물학 관련 요청은 사용자가 “이 요청은 Fable 5가 직접 처리하지 않는구나”라고 알 수 있었다. 반면 frontier AI 개발 관련 요청은 사용자가 알 수 없는 방식으로 성능이 낮아질 수 있었다.
이 차이가 논란의 핵심이다.
AI 모델이 위험한 요청을 거절하거나 제한할 수 있다는 점은 어느 정도 받아들여질 수 있다. 하지만 사용자가 제한 사실을 알 수 없다면, 모델을 연구나 업무 도구로 신뢰하기 어려워진다.
4. Anthropic은 왜 이런 방식을 고려했을까?
Anthropic의 입장도 함께 볼 필요가 있다.
Anthropic은 이전부터 모델 증류(distillation)와 frontier AI 개발 가속에 대해 우려를 표해왔다. 모델 증류는 쉽게 말해, 더 강력한 모델의 출력을 대량으로 수집해 다른 모델을 학습시키는 방식이다.
예를 들어 어떤 조직이 Claude 같은 강력한 모델에 수많은 질문을 던지고, 그 답변을 학습 데이터로 활용하면, Claude의 일부 능력을 다른 모델로 옮기는 효과를 낼 수 있다.
Anthropic은 이런 대규모 distillation이 다음과 같은 문제로 이어질 수 있다고 본다.
| 경쟁 모델 학습 | Claude의 출력을 이용해 다른 모델을 더 빠르게 개선 |
| 안전장치 없는 모델 확산 | Claude의 능력은 가져가지만 안전장치는 유지되지 않을 수 있음 |
| 국가 안보 리스크 | 특정 국가나 조직이 frontier AI 능력을 빠르게 확보할 수 있음 |
| 사이버·바이오 악용 가능성 | 강력한 모델 능력이 공격적 목적에 사용될 수 있음 |
Anthropic은 2026년 2월에도 distillation attack과 관련된 글을 공개한 바 있다. 이 글에서 Anthropic은 일부 AI 연구소들이 Claude의 능력을 추출하기 위해 대규모로 Claude 출력을 수집했다고 주장했다.
이런 배경에서 보면, Anthropic은 Fable 5가 다른 강력한 AI 모델 개발을 가속하는 데 사용되는 것을 막고 싶었던 것으로 이해할 수 있다.
다만 이번 논란은 “그런 제한이 필요한가?”보다 “제한을 사용자에게 숨겨도 되는가?”에 더 가까운 문제였다.
5. AI 연구자와 개발자들의 반응
Fortune과 WIRED 보도에 따르면, Fable 5의 비가시적 제한 정책은 AI 연구자, 개발자, 정책 전문가들 사이에서 빠르게 비판을 받았다.
주요 반응은 다음과 같이 정리할 수 있다.
- 투명성 부족: 사용자가 제한 사실을 모르면 모델을 신뢰하기 어렵다는 비판
- 연구 방해 우려: AI 안전 연구나 오픈소스 연구도 영향을 받을 수 있다는 우려
- 평가 왜곡 가능성: 벤치마크나 모델 비교 실험에서 결과가 왜곡될 수 있음
- 권력 집중 문제: 대형 AI 연구소만 고성능 모델을 AI 연구에 활용할 수 있다는 우려 (최근에 항상 우려되는 부분)
- false positive 문제: 정상적인 연구 요청도 제한될 수 있음
특히 오픈소스 AI 연구자와 AI 안전 연구자들은 이 정책이 AI 연구 생태계에 부정적인 영향을 줄 수 있다고 우려했다. 모델이 특정 연구 요청에서 조용히 성능을 낮춘다면, 외부 연구자는 자신이 정책에 걸렸는지조차 알 수 없기 때문이다.
WIRED 보도에서는 open-source AI startup Prime Intellect의 Will Brown이 이 정책을 두고, Anthropic이 “자기들만 AI 연구를 할 수 있어야 한다”고 말하는 것처럼 느껴졌다고 설명했다. 또한 그는 이런 방식이 외부 모델 평가 기업이나 AI 안전 평가 작업에도 영향을 줄 수 있다고 지적했다.
Fortune 보도에서도 Nathan Lambert, Dean Ball, Jeremy Howard, 전 Anthropic 연구자 Behnam Neyshabur 등 여러 인물들의 비판이 소개되었다.
다만 모든 반응이 부정적이었던 것은 아니다. Fortune은 Ethan Mollick이 Fable 5의 제한 정책보다는 성능 측면에 주목했고, Andrej Karpathy도 Fable 5를 긍정적으로 평가하면서 다만 safeguard가 초기에 다소 민감하게 설정된 것으로 보인다고 언급했다고 전했다.
즉, 반응은 크게 두 갈래로 나뉜다.
| 성능 측면 | Fable 5는 강력한 모델이며, 코딩·연구·장기 작업에서 좋은 평가를 받음 |
| 정책 측면 | 사용자에게 보이지 않는 성능 제한은 신뢰와 투명성 문제를 만든다는 비판 |
나는 성능에 대해서 인정하지만 정책 측면에서의 모습은 아쉬운 점이 크다.
이번 논란은 Fable 5의 성능 자체보다, 강력한 모델을 공개할 때 어떤 방식으로 안전장치를 적용해야 하는지에 대한 논의로 이어졌다.
6. WIRED 보도 이후: Anthropic의 입장 변경
WIRED 보도에서 가장 중요한 부분은 Anthropic이 비판 이후 해당 정책을 바꾸겠다고 밝혔다는 점이다.
WIRED에 따르면 Anthropic은 Fable 5의 frontier LLM development 관련 safeguard를 사용자에게 보이는 방식으로 변경하겠다고 밝혔다. Anthropic은 WIRED에 보낸 입장에서, 잘못된 trade-off를 선택했으며 균형을 제대로 맞추지 못한 점에 대해 사과한다고 설명했다.
변경 후에는 사용자가 Fable 5를 이용해 고성능 AI 개발과 관련된 제한 영역에 해당하는 요청을 할 경우, 다음 중 하나가 사용자에게 보이는 방식으로 처리될 예정이다.
1. 요청을 거절한다.
2. 더 낮은 성능의 모델로 라우팅한다.
3. 사용자에게 해당 처리 사실을 알린다.
즉, 기존에는 모델이 조용히 성능을 낮추는 방식이었다면, 앞으로는 사용자가 “이 요청은 제한되었구나” 또는 “다른 모델로 처리되었구나”를 알 수 있게 하겠다는 것이다.
이 변화는 중요하다.
처음 논란이 된 부분은 safety classifier 자체가 아니라, 그 classifier가 사용자에게 보이지 않는 방식으로 작동했다는 점이었기 때문이다.
7. 보이는 안전장치의 또 다른 문제: false positive
다만 Anthropic은 사용자가 볼 수 있는 방식으로 바꾸면 또 다른 문제가 생길 수 있다고 설명했다.
숨겨진 safeguard는 사용자가 우회하기 어렵다는 장점이 있다. 사용자가 어떤 요청이 제한되는지 알 수 없기 때문에, classifier를 피하는 방법을 찾기도 어렵다.
반대로 보이는 safeguard는 사용자가 어떤 요청이 제한되는지 알 수 있어 우회 시도가 더 쉬워질 수 있다.
그래서 Anthropic은 보이는 방식으로 바꿀 경우 classifier가 더 넓게 작동할 수 있다고 설명했다. 즉, 정상적인 요청도 제한에 걸릴 가능성이 커질 수 있다는 뜻이다.
이 부분은 AI 안전장치의 어려움을 보여준다.
| 방식 | 장점 | 단점 |
| 숨겨진 제한 | 우회가 어려움, 더 좁게 타겟팅 가능 | 사용자 신뢰와 투명성 문제 |
| 보이는 제한 | 사용자가 제한 사실을 알 수 있음 | 우회 가능성 증가, false positive 증가 가능 |
결국 안전장치는 “얼마나 강하게 막을 것인가”뿐 아니라, 사용자에게 얼마나 투명하게 보여줄 것인가의 문제이기도 하다.
8. 이 논란이 실무자에게 중요한 이유
이 논란은 AI 연구자만의 문제가 아니다.
개발자, PM, 데이터 분석가, 보안팀, AI 제품 기획자에게도 의미가 있다.
AI 모델을 업무에 활용할 때 우리는 보통 답변 품질만 본다.
- 이 모델이 코드를 잘 짜는가?
- 문서를 잘 요약하는가?
- 분석 결과가 정확한가?
- 비용 대비 성능이 괜찮은가?
하지만 이번 사례를 보면 앞으로는 아래 질문도 함께 봐야 할 것 같다.
| 특정 주제에서 모델이 제한되는가? | 업무 도메인에 따라 답변 품질이 달라질 수 있음 |
| 제한이 발생하면 사용자에게 알려주는가? | 디버깅과 결과 해석에 필요 |
| fallback이 발생하면 어떤 모델이 답변하는가? | 실제 응답 품질과 비용이 달라질 수 있음 |
| API 응답에서 fallback 여부를 확인할 수 있는가? | 서비스 연동 시 예외 처리에 필요 |
| 데이터 보존 정책은 무엇인가? | 기업 보안 정책과 관련 |
| 특정 업무가 정책에 걸릴 가능성이 있는가? | 보안, 바이오, AI 연구 조직에 중요 |
특히 보안, 바이오, AI 연구, 모델 개발, 인프라 설계 같은 업무를 하는 조직이라면 Fable 5 같은 모델을 도입하기 전에 policy와 API 동작 방식을 확인해야 한다. 모델이 좋은지 나쁜지보다, 어떤 조건에서 어떤 방식으로 동작하는지가 실무에서는 더 중요할 수 있다.
9. 개인적으로 정리한 핵심
이번 논란을 공부하면서 가장 중요하게 느낀 점은, AI 안전장치의 존재 여부보다 안전장치의 투명성이었다.
고성능 모델에는 안전장치가 필요할 수 있다.
특히 Fable 5처럼 강력한 모델이 사이버보안, 생물학, 모델 증류, frontier AI 개발에 활용될 수 있다면 제한 정책이 필요하다는 주장도 이해된다.
하지만 사용자가 알지 못하는 방식으로 모델 성능이 낮아진다면, 그건 다른 문제다.
사용자는 모델이 원래 못해서 부족하게 답한 것인지, 정책 때문에 일부러 덜 유용하게 답한 것인지 알 수 없다. 연구자나 개발자 입장에서는 이 차이가 매우 중요하다.
이번 논란은 다음 질문을 남긴다.
AI 모델이 위험한 요청을 제한하는 것은 어디까지 허용될 수 있을까?
그리고 그 제한은 사용자에게 얼마나 투명하게 공개되어야 할까?
Anthropic은 비판 이후 해당 정책을 사용자에게 보이는 방식으로 바꾸겠다고 밝혔다. 이 변화는 앞으로 다른 AI 모델 제공사에도 영향을 줄 수 있을 것 같다. 강력한 모델이 계속 등장할수록, 모델의 성능뿐 아니라 접근 권한, 안전장치, 데이터 보존, fallback 방식, 사용자 고지 방식이 더 중요해질 것으로 보인다.
10. 정리하며
Claude Fable 5는 Anthropic이 일반 공개한 가장 강력한 모델 중 하나로 소개되었다.
하지만 출시 직후 논란이 된 것은 모델의 성능이 아니라, 일부 AI 연구·개발 관련 요청에서 사용자에게 보이지 않게 응답 효과를 낮출 수 있다는 안전장치였다.
Anthropic은 frontier LLM development 관련 요청이 Fable 5를 이용해 더 강력한 AI 모델 개발을 가속할 수 있다고 우려했다. 그래서 해당 요청에 대해 제한을 적용하려 했다.
하지만 연구자와 개발자들은 이 방식이 투명하지 않으며, 정상적인 AI 연구와 모델 평가까지 방해할 수 있다고 비판했다. 이후 Anthropic은 해당 안전장치를 사용자에게 보이는 방식으로 바꾸겠다고 밝혔다.
이번 사례는 앞으로 AI 모델을 사용할 때 단순히 “어떤 모델이 가장 똑똑한가?”만 볼 것이 아니라, 다음 질문도 함께 봐야 한다는 점을 보여준다.
- 이 모델은 어떤 요청을 제한하는가?
- 제한이 발생하면 사용자가 알 수 있는가?
- 실제로 어떤 모델이 답변하고 있는가?
- 업무나 연구 결과에 영향을 줄 수 있는가?
- 회사 정책상 데이터 보존과 모델 fallback을 허용할 수 있는가?
AI 모델의 성능 경쟁이 계속될수록, 모델을 둘러싼 안전장치와 투명성 문제도 더 자주 논의될 것 같다.
참고 자료
- WIRED - Anthropic Walks Back Policy That Could Have ‘Sabotaged’ AI Researchers Using Claude
- Fortune - Anthropic accused of ‘secret sabotage’ as Claude Fable 5 silently limits capabilities for AI researchers and developers
- Anthropic News - Claude Fable 5 and Claude Mythos 5
- Anthropic System Card - Claude Fable 5 & Claude Mythos 5 System Card
- Anthropic News - Detecting and preventing distillation attacks
- Reuters - Anthropic rolls out public version of Mythos without cybersecurity capability
- Business Insider - Anthropic: ‘We made the wrong tradeoff’ in new model guardrails
'Tech News' 카테고리의 다른 글
| Sam Altman의 The Gentle Singularity를 읽고: 기술은 천천히, 그러나 너무 빠르게 온다 (0) | 2026.06.15 |
|---|---|
| Fable 5와 Mythos 5 접근 중단: AI 모델은 이제 ‘국가 자산’이 되는 걸까? (0) | 2026.06.15 |
| Dario Amodei의 「Policy on the AI Exponential」을 읽고: AI 발전은 모두에게 같은 기회일까? (1) | 2026.06.11 |
| Claude Fable 5 / Mythos 5 발표 내용 정리 (0) | 2026.06.10 |
| WWDC26: Siri AI와 Apple Intelligence 주요 발표 내용 (0) | 2026.06.09 |


