지금까지 다섯 편에서는 시장조사, 요구사항 정의, 태스크 자동화, 멀티 에이전트 하네스처럼 개발 프로세스와 구조를 주로 다뤘다.
이번 글은 조금 다르다.
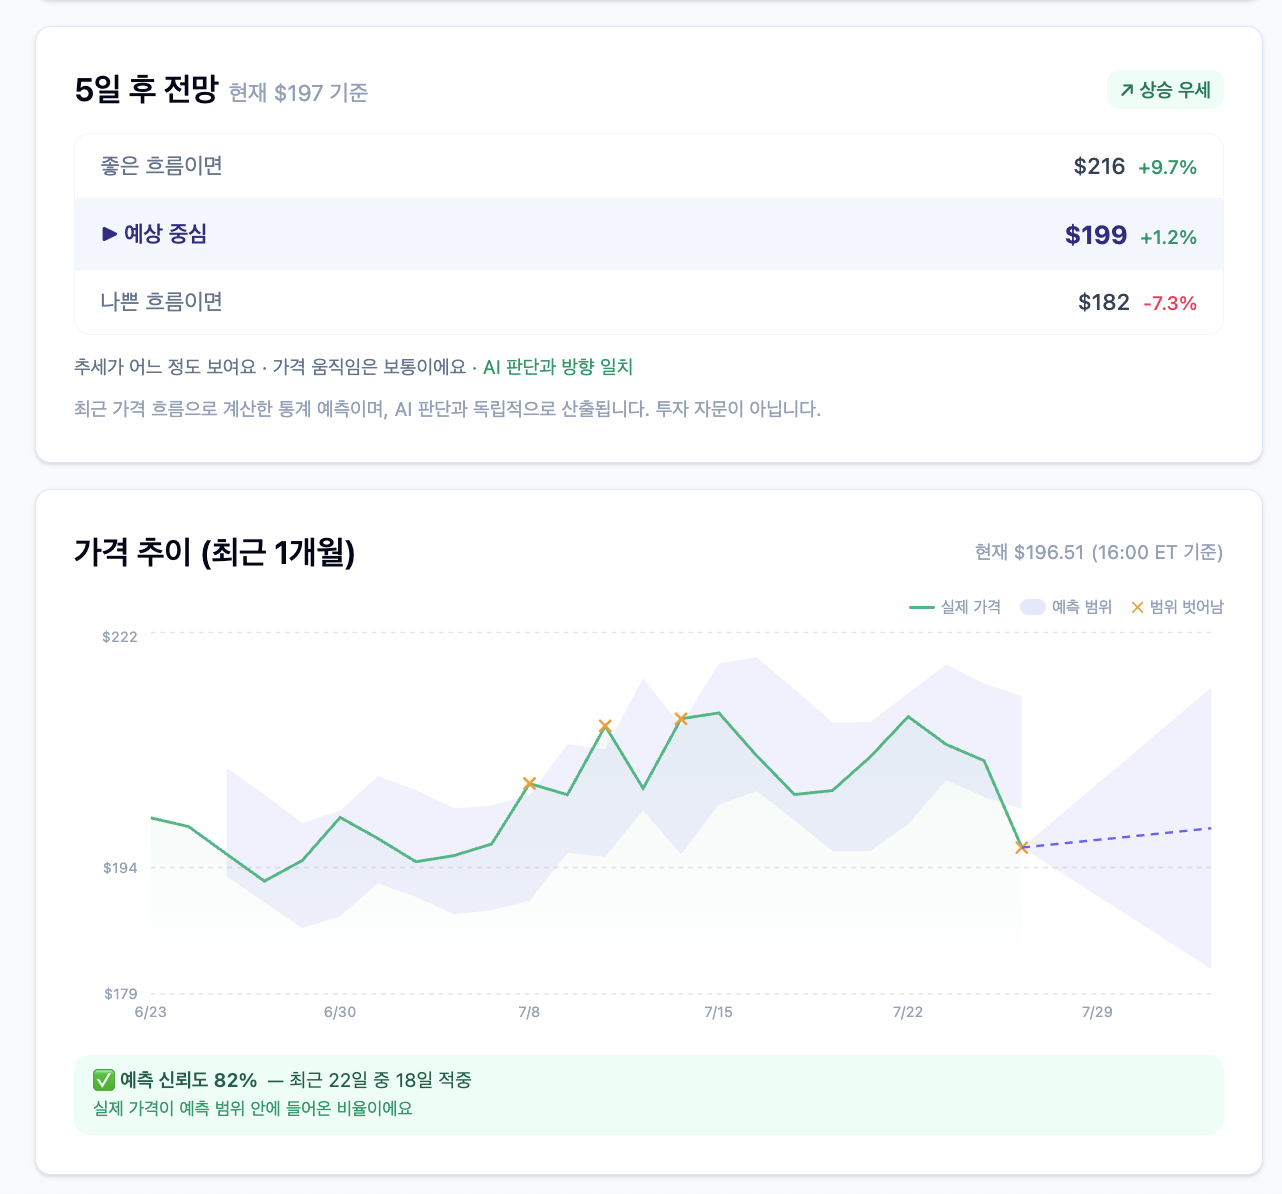
직접 만든 통계 예측 모델이 예상보다 훨씬 낮은 성능을 보였고, 이를 세 단계에 걸쳐 다시 설계한 과정을 정리한다.
아직 이 모듈은 완성된 상태가 아니다. 실측 데이터가 쌓일 때마다 계속 검증하고 수정하고 있다. 따라서 이번 글은 완료 보고서라기보다 현재까지의 개발 회고에 가깝다.
1. Gemini와 별도로 동작하는 통계 예측 모듈
이 프로젝트에는 Gemini의 판단과 독립적으로 동작하는 통계 예측 모듈이 있다.
src/lib/quant/ 아래에 외부 라이브러리 없이 순수 TypeScript로 구현했으며, 다음 정보를 계산해 추천 카드에 전달한다.
- 보유 기간 이후의 예상 가격
- 예상 가격 범위
- 상승·하락 시나리오
- 변동성 기반 리스크 범위
LLM이 뉴스와 시장 맥락을 해석한다면, 이 모듈은 가격 데이터만으로 정량적인 참고값을 제공하는 역할이다.
두 모듈을 분리한 이유는 LLM의 판단 결과와 통계 계산 결과를 서로 독립적으로 확인하기 위해서다. Gemini가 긍정적인 전망을 내더라도 통계 모델은 별도의 가격 범위와 변동성을 계산한다.
문제는 첫 번째 버전을 실제 데이터로 검증했을 때 나타났다.
2. Version 1: 교과서대로 만들었지만 Random Walk보다 못했다
초기 모델은 예상 가격과 예상 범위를 각각 계산하도록 구성했다.
예상 가격 계산
최근 21거래일을 기준으로 두 모델의 예측값을 평균냈다.
- Holt’s Double Exponential Smoothing
Holt 방식은 시계열에서 현재 수준과 추세를 함께 추정하는 알고리즘이다.
단순 이동평균이 최근 값의 평균만 본다면, Holt 방식은 다음 두 요소를 별도로 관리한다.
1. Level: 현재 가격 수준
2. Trend: 최근 가격이 상승하거나 하락하는 속도
이번 모델에서는 다음 파라미터를 사용했다.
α = 0.5, β = 0.3
α는 새로운 가격을 현재 수준에 얼마나 빠르게 반영할지를 결정하고, β는 최근 추세 변화에 얼마나 민감하게 반응할지를 결정한다.
값이 클수록 최근 데이터에 더 민감하게 반응한다. - Linear Regression 기반 추세 외삽
Linear Regression, 즉 선형회귀는 데이터에 가장 잘 맞는 직선을 구하는 방식이다.
최근 거래일을 x, 해당 날짜의 종가를 y로 두고 다음과 같은 직선을 계산한다.
예상 가격 = 절편 + 기울기 × 거래일
기울기가 양수이면 최근 가격이 상승 추세였다는 의미이고, 음수이면 하락 추세였다는 의미다.
이 직선을 현재 데이터 구간 밖의 미래까지 연장해 가격을 계산하는 것을 외삽(extrapolation)이라고 한다.
예를 들어 최근 주가에 하루 평균 1달러씩 상승하는 직선이 만들어졌다면, 5일 뒤 가격은 현재 가격보다 약 5달러 높을 것으로 예측한다.
문제는 최근 추세가 미래에도 같은 속도로 이어진다는 보장이 없다는 점이다.
최근 21일 하락 → 음의 기울기 계산 → 이후 보유 기간에도 계속 하락한다고 예측
실제 시장이 곧바로 반등하면, 이 추세 외삽은 큰 방향 편향을 만든다.
예상 범위 계산
예상 가격 주변의 범위는 EWMA 변동성을 사용해 계산했다.
EWMA는 Exponentially Weighted Moving Average의 약자로, 과거 데이터보다 최근 데이터에 더 큰 가중치를 주는 방식이다.
이번 모델에서는 RiskMetrics에서 널리 알려진 다음 감쇠 계수를 사용했다.
λ = 0.94λ가 1에 가까울수록 과거 데이터의 영향이 천천히 줄어든다.
변동성은 일별 로그 수익률을 기준으로 계산했다.
log return = ln(오늘 종가 / 어제 종가)일반 수익률보다 여러 기간의 수익률을 더하기 편하고, 통계 모델에서 다루기 쉬워 자주 사용된다.
보유 기간이 길어지면 변동성이 커질 것으로 보고, 다음과 같이 보유일수의 제곱근을 곱했다.
보유 기간 변동성
= 일일 변동성 × √보유일수
이를 Square-root-of-time scaling이라고 한다. 각 날짜의 수익률이 서로 독립적이고 비슷한 분포를 가진다는 가정 아래 사용한다.
최종 예상 범위는 다음처럼 계산했다.
예상 가격 ± 1σ여기서 σ는 표준편차를 의미한다. 수익률이 정규분포를 따른다고 가정하면 ±1σ 안에 실제 값이 들어올 확률은 약 68%다.
구성만 보면 특별히 이상하지 않았다.
하지만 M7 종목을 대상으로 walk-forward 검증을 수행한 결과는 기대와 달랐다.
Walk-forward 검증
검증에는 M7으로 불리는 미국 대형 기술주 7개를 사용했다.
AAPL
MSFT
GOOGL
AMZN
NVDA
META
TSLA
총 39개 예측 구간을 walk-forward 방식으로 평가했다.
Walk-forward 검증은 시계열 데이터에서 미래 정보를 미리 보지 않고, 실제 시간이 흐르는 것처럼 순차적으로 모델을 평가하는 방식이다.
예를 들어 다음과 같이 진행된다.
1~20일 데이터로 21일 예측
→ 실제 21일 가격과 비교

2~21일 데이터로 22일 예측
→ 실제 22일 가격과 비교

3~22일 데이터로 23일 예측
→ 실제 23일 가격과 비교
일반적인 랜덤 데이터 분할은 미래 데이터가 과거 학습 구간에 섞일 수 있기 때문에 시계열 평가에는 적합하지 않을 수 있다.
Walk-forward 방식은 실제 운영 환경과 비슷하게 과거 데이터만 사용한다는 장점이 있다.
검증 결과는 다음과 같았다.
- 범위 적중률: 31%
- 평균 절대 오차: 3.52%
- 방향 편향: +2.90%
- 추세 모델 오차: 3.25%
- Random Walk 기준선: 2.23%
범위 적중률
범위 적중률은 실제 미래 가격이 모델이 제시한 예상 범위 안에 들어온 비율이다.
예상 범위: $95~$105
실제 가격: $102
→ 적중

실제 가격: $110
→ 실패
이론적으로 약 68%를 기대했지만 실제 적중률은 31%에 불과했다.
평균 절대 오차
평균 절대 오차는 예측 가격과 실제 가격의 차이를 절대값으로 계산한 뒤 평균낸 값이다.
이번 글에서는 가격 차이를 비율로 표현했다.
예측 가격: $100
실제 가격: $103
절대 오차: 3%
방향과 상관없이 얼마나 틀렸는지를 보여주는 지표다.
방향 편향
방향 편향은 모델이 지속적으로 한 방향으로 치우쳐 예측하는지를 보여준다.
예를 들어 실제 가격보다 계속 낮게 예측하면 하락 방향 편향이 있다고 볼 수 있다.
이번 모델은 하락 구간에서 학습한 추세를 반등 구간까지 이어가며 큰 편향을 만들었다.
Random Walk 기준선
가장 당황스러웠던 부분은 Random Walk보다도 결과가 나빴다는 점이다.
Random Walk 기준선은 복잡한 모델이 아니다.
미래 가격 ≈ 현재 종가즉, 마지막으로 관측된 가격을 미래 예측값으로 그대로 사용한다.
주가의 단기 움직임이 예측하기 어렵다면, “가격이 크게 바뀌지 않는다”는 단순한 기준선이 의외로 강하다.
그런데 추세를 반영한 모델의 오차는 3.25%, Random Walk의 오차는 2.23%였다.
복잡한 계산을 추가한 결과가 아무것도 하지 않은 기준선보다 더 나빴던 것이다.
3. 문제를 세 단계로 나눠서 수정했다
한 번에 모든 문제를 고치기보다 원인을 세 가지로 나눴다.
1. 범위 적중률 부족 → 밴드 계산 방식 수정
2. 변동성 추정의 표본 효율 부족 → OHLC 기반 추정량 도입
3. 점 예측의 방향 편향 → 추세 감쇠와 Random Walk 수축
각 단계가 끝날 때마다 동일한 M7 데이터로 walk-forward 검증을 다시 수행했다.
4. 1단계: Conformal Prediction으로 예측 범위를 다시 만들었다
가장 먼저 수정한 것은 31%에 불과했던 범위 적중률이었다.
기존 방식은 로그 수익률이 정규분포에 가깝다고 가정하고 ±1σ 범위를 만들었다.
하지만 실제 주가 데이터에는 다음과 같은 특성이 있다.
- Fat Tail > 극단적인 가격 변화가 정규분포에서 예상하는 것보다 자주 발생하는 현상을 의미한다.
정규분포에서는 큰 폭의 급락이나 급등이 매우 드물어야 하지만, 실제 금융시장에서는 이런 움직임이 예상보다 자주 나타난다.
따라서 정규분포 기반 ±1σ 범위는 실제 리스크를 과소평가할 수 있다. - 급격한 변동성 증가
- 시장 국면 전환
- 종목별 변동성 차이
고정된 정규분포 가정만으로는 이런 특성을 충분히 반영하기 어려웠다.
그래서 예측 범위를 최근 실제 오차 분포에서 직접 계산하는 Conformal Prediction 방식으로 변경했다.
Conformal Prediction
Conformal Prediction은 특정 확률분포를 강하게 가정하지 않고, 모델이 과거에 실제로 얼마나 틀렸는지를 이용해 예측 구간을 만드는 방법이다.
쉽게 말하면 다음과 같다.
이 모델이 최근에 보통 어느 정도 틀렸는지를 보고 미래 예측 범위를 정한다.
이번 프로젝트에서는 다음 순서로 적용했다.
- 각 종목의 과거 데이터를 이용해 1일 뒤 가격을 순차적으로 예측한다.
- 예측 가격과 실제 가격의 차이를 저장한다.
- 최근 오차 분포에서 목표 커버리지에 해당하는 분위수를 구한다.
- 해당 값을 보유 기간에 맞게 스케일링한다.
최근 실제 예측 오차 분위수
× √보유일수
= 예측 범위
분위수란?
분위수(quantile)는 데이터를 크기순으로 정렬했을 때 특정 비율에 해당하는 위치의 값이다.
예를 들어 오차의 80% 분위수가 4%라면, 과거 예측 오차의 80%가 4% 이하였다는 의미다.
과거 예측 오차:
1%, 2%, 2%, 3%, 4%, 6%, 8%

80% 분위수 ≈ 6%
이를 바탕으로 예상 가격의 위아래 범위를 정한다.
목표 커버리지는 80%로 설정했다. 이 방식의 장점은 종목마다 최근 실제 오차에 맞춰 밴드 폭이 달라진다는 점이다. 변동성이 큰 종목은 넓은 범위를, 안정적인 종목은 상대적으로 좁은 범위를 갖게 된다.
이 변경만으로 범위 적중률은 다음과 같이 개선됐다.
31% → 60%아직 목표인 80%에는 미치지 못했지만, 정규분포 기반 밴드보다 훨씬 현실적인 범위를 만들 수 있었다.
5. 2단계: Yang-Zhang 변동성으로 OHLC를 모두 활용했다
Conformal Prediction을 사용하더라도 최소 밴드 폭을 위한 변동성 하한값은 필요했다.
기존 EWMA 방식은 종가만 사용했다.
오늘 종가
→ 어제 종가 대비 수익률
→ 변동성 추정
하지만 20~60일 정도의 짧은 데이터 구간에서는 종가만 사용하는 방식의 표본 효율(같은 양의 데이터로 얼마나 안정적인 값을 추정할 수 있는지)이 낮을 수 있다.
프로젝트에는 이미 다음 OHLC 데이터가 저장돼 있었다.
- Open: 시가
- High: 고가
- Low: 저가
- Close: 종가
그래서 Yang-Zhang 변동성 추정량을 도입했다.
Yang-Zhang 변동성
Yang-Zhang 변동성은 시가, 고가, 저가, 종가를 모두 활용하는 변동성 추정 방식이다.
다음 세 가지 요소를 결합한다.
- Overnight Gap
- Open-to-Close 변동
- Rogers-Satchell 변동성
Overnight Gap
Overnight Gap은 전일 종가와 다음 날 시가 사이의 변화다.
전일 종가: $100
다음 날 시가: $105
→ Overnight Gap: +5%
장 마감 이후 발생한 뉴스나 이벤트의 영향을 반영한다.
Open-to-Close 변동
당일 시가에서 종가까지 가격이 얼마나 움직였는지를 측정한다.
Rogers-Satchell 변동성
Rogers-Satchell 추정량은 고가와 저가, 시가와 종가를 함께 사용해 장중 변동성을 계산한다. 단순히 종가끼리 비교하는 것보다 하루 동안의 실제 가격 범위를 더 많이 반영한다.
정리하면 다음과 같다.
Close-to-Close
→ 종가 변화만 사용

Yang-Zhang
→ Overnight Gap
→ 시가-종가 변화
→ 고가-저가 장중 변동
추가 데이터를 수집할 필요도 없었다. TickerPriceHistory에 OHLC가 이미 저장돼 있었기 때문이다.
결과적으로 짧은 관측 구간에서도 변동성 하한값을 더 안정적으로 계산할 수 있게 됐다.
6. 3단계: Damped Trend와 Random Walk Shrinkage로 편향을 줄였다
밴드 적중률은 개선됐지만 점 예측의 방향 편향은 여전히 남아 있었다.
초기 모델은 최근 추세가 미래에도 같은 속도로 이어질 것이라고 가정했다.
최근 하락 추세
→ 보유 기간 내내 같은 속도로 하락한다고 예측
하지만 실제 시장에서는 추세가 약해지거나 빠르게 반전될 수 있다.
이를 해결하기 위해 Damped Trend와 Random Walk Shrinkage를 함께 적용했다.
Damped Trend
Damped Trend는 미래로 갈수록 추세의 영향력을 점점 줄이는 방식이다. 기존 추세 외삽은 기울기를 보유 기간 끝까지 그대로 적용한다.
추세가 하루 -1%
→ 5일 뒤 약 -5%로 외삽
Damped Trend는 첫날에는 추세를 크게 반영하지만, 시간이 지날수록 추세가 약해진다고 가정한다. 감쇠 계수는 다음과 같이 설정했다.
φ = 0.85φ가 1에 가까우면 추세가 천천히 약해지고, 값이 작을수록 빠르게 사라진다.
계산 개념은 다음과 같다.
기존 추세 외삽
Trend × h

Damped Trend
Trend × (φ + φ² + ... + φʰ)
예를 들어 첫날의 추세 영향이 100이라면 다음 날은 85, 그다음 날은 약 72처럼 점차 줄어든다.
Linear Regression에도 같은 감쇠 개념을 적용했다.
Holt와 Linear Regression 두 모델이 모두 “최근 추세가 영원히 이어지지는 않는다”는 같은 원칙을 따르도록 만든 것이다.
Random Walk Shrinkage
Damped Trend를 적용한 뒤에도 Random Walk보다 오차가 컸다. 결국 최근 추세 신호 자체가 약하다는 의미였다. 그래서 최종 예측값을 Random Walk 기준선 쪽으로 당겼다.
통계에서는 이렇게 불안정한 추정값을 안정적인 기준값 쪽으로 이동시키는 것을 수축(shrinkage)이라고 한다.
최종 예측
= w × 추세 예측
+ (1 - w) × 현재 종가
여기서 w는 추세 예측을 얼마나 신뢰할지를 나타낸다.
w = 1.0
→ 추세 예측 100%

w = 0.3
→ 추세 예측 30%
→ 현재 종가 70%
M7 과거 데이터에 대해 가중치를 여러 값으로 바꿔가며 평가했다. (이를 가중치 스윕(weight sweep)이라고 한다.)
| 추세 가중치 | 평균 오차 |
| w = 1.0 | 3.25% |
| w = 0.7 | 감소 |
| w = 0.5 | 감소 |
| w = 0.3 | 2.33% |
추세 가중치를 낮출수록 오차가 줄어드는 경향이 나타났다. 이를 확인하여 최종적으로 다음 비율을 사용했다.
추세 모델 30%
Random Walk 70%
모델이 방향을 강하게 주장하기보다, 현재 가격을 중심으로 약한 추세만 반영하도록 바꾼 것이다.
7. 최종 결과: 범위는 개선됐고, Random Walk와의 격차는 줄었다
동일한 M7 데이터로 다시 walk-forward 평가를 수행했다.
| 지표 | Ver. 1 | Ver. 2 |
| 범위 적중률 | 31% | 85% |
| 목표 커버리지 | 68% | 80% |
| 평균 절대 오차 | 3.52% | 2.38% |
| 방향 편향 | +2.90% | +1.30% |
| Random Walk 오차 | 2.23% | 2.23% |
범위 적중률은 31%에서 85%로 개선됐다.
점 예측 오차도 3.52%에서 2.38%까지 줄었고, 방향 편향도 절반 이상 감소했다.
다만 Random Walk 기준선인 2.23%를 완전히 이기지는 못했다.
Version 1
3.52%

Version 2
2.38%

Random Walk
2.23%
그래도 초기에는 기준선보다 크게 뒤처졌지만, 현재는 격차를 상당히 줄인 상태다.
이 결과를 보면서 복잡한 모델을 추가하는 것보다 강한 기준선과 비교하고, 필요하면 그 기준선 쪽으로 수축시키는 것이 더 중요하다는 점을 다시 확인했다.
8. 왜 ARIMA나 LSTM을 사용하지 않았나
성능이 부족하다면 더 복잡한 모델을 추가하는 방법도 있다.
예를 들면 다음과 같다.
- ARIMA > ARIMA는 자기 자신의 과거 값과 과거 오차를 이용해 미래 값을 예측하는 전통적인 시계열 모델이다.
데이터에 추세나 자기상관이 충분히 존재하면 유용하지만, 파라미터 선택과 정상성 검토가 필요하다. - Prophet
- LSTM > LSTM은 긴 시퀀스의 패턴을 학습하도록 설계된 순환신경망 계열 모델이다.
충분한 학습 데이터가 있다면 복잡한 비선형 패턴을 학습할 수 있지만, 20~60개 정도의 짧은 시계열만으로는 과적합 위험이 크다. - Transformer 기반 시계열 모델
현재 모델이 복잡한 알고리즘을 배제한 이유는 다음과 같다.
데이터가 적다
각 예측에 사용하는 데이터는 약 20~60거래일이다.
복잡한 모델이 안정적인 패턴을 학습하기에는 부족한 길이다.
Serverless 환경에 맞아야 한다
이 프로젝트는 요청 시 빠르게 계산돼야 한다.
현재 모델은 외부 라이브러리나 별도 학습 서버 없이 밀리초 단위로 실행된다.
설명 가능성이 중요하다
각 예측은 다음 구성요소로 나눠 설명할 수 있다.
Damped Trend
Conformal Error Quantile
Yang-Zhang Volatility
Random Walk Shrinkage
이 구조는 지표를 지나치게 신비화하지 않는다는 프로젝트 원칙과도 맞는다.
조금 더 높은 정확도를 기대하며 설명하기 어려운 모델을 추가하기보다, 현재 수준에서 오차와 한계를 명확히 보여주는 편을 선택했다.
9. 아직 검증 중인 부분
이 모듈은 아직 완결된 상태가 아니다.
현재 계속 확인하고 있는 부분은 다음과 같다.
최소 데이터 기준
현재는 유효 종가가 20거래일 미만이면 예측값을 반환하지 않는다.
valid prices < 20
→ prediction = null
데이터가 너무 적으면 추세, 변동성, 오차 분위수 모두 불안정해지기 때문이다. 하지만 IPO 직후 종목이나 신규 상장 종목에는 지나치게 보수적인 기준일 수 있다.
20일이 적절한지 계속 관찰하고 있다.
Sigma Floor와 Conformal Band의 관계
소표본에서 Conformal 분위수가 지나치게 좁아지는 것을 막기 위해 Yang-Zhang 변동성 기반 하한값을 적용한다.
최종 밴드 폭
= max(Conformal Quantile, Volatility Floor)
두 값 중 더 큰 쪽을 사용해 밴드가 지나치게 좁아지는 것을 방지한다. 다만 반대로 특정 종목에서 Conformal 밴드가 지나치게 넓어지는 경우가 있는지는 아직 데이터가 부족하다.
추세 가중치 0.3의 일반화
현재 w = 0.3은 M7 데이터에서 가장 안정적인 값이었다.
하지만 이 값이 대형 기술주에만 맞는 것인지, 다른 산업과 중소형주에도 적용할 수 있는지는 검증하지 못했다.
향후 관심종목 데이터가 충분히 쌓이면 종목군별로 다시 평가할 예정이다.
마무리
이번 모델 개선 과정에서 가장 크게 배운 점은 모델이 복잡하다고 반드시 기준선보다 좋아지는 것은 아니라는 사실이었다.
첫 번째 버전은 이론적으로 익숙한 방법을 조합했지만, 실제 데이터에서는 Random Walk보다도 낮은 성능을 보였다.
이후 다음 순서로 모델을 다시 구성했다.
정규분포 기반 밴드
→ Conformal Prediction

종가 기반 EWMA 변동성
→ Yang-Zhang OHLC 변동성

무제한 추세 외삽
→ Damped Trend

추세 중심 예측
→ Random Walk Shrinkage
그 결과 범위 적중률과 방향 편향은 크게 개선됐지만, 점 예측은 아직 Random Walk와 비슷한 수준이다.
이번 편의 결론은 “좋은 예측 모델을 완성했다”가 아니다.
기준선보다 못한 모델을 발견했고, 그 사실을 숨기지 않고 다시 검증 가능한 구조로 고쳤다.
시장조사, PRD, SRS, 태스크 자동화, 멀티 에이전트 하네스는 한 번 구조를 잡으면 비교적 안정적으로 유지할 수 있었다.
반면 정량 모델은 실제 데이터가 쌓일 때마다 계속 다시 평가해야 했다.
이 시리즈는 이번 글로 일단 마무리하지만, 예측 모듈은 데이터가 더 쌓이면 후속 글에서 다시 다룰 예정이다.
프로젝트 저장소
AI Stock Alarm App
https://github.com/hy2207/ai-stock-alarm-app
GitHub - hy2207/ai-stock-alarm-app
Contribute to hy2207/ai-stock-alarm-app development by creating an account on GitHub.
github.com
(2026-07-28일자) 후기
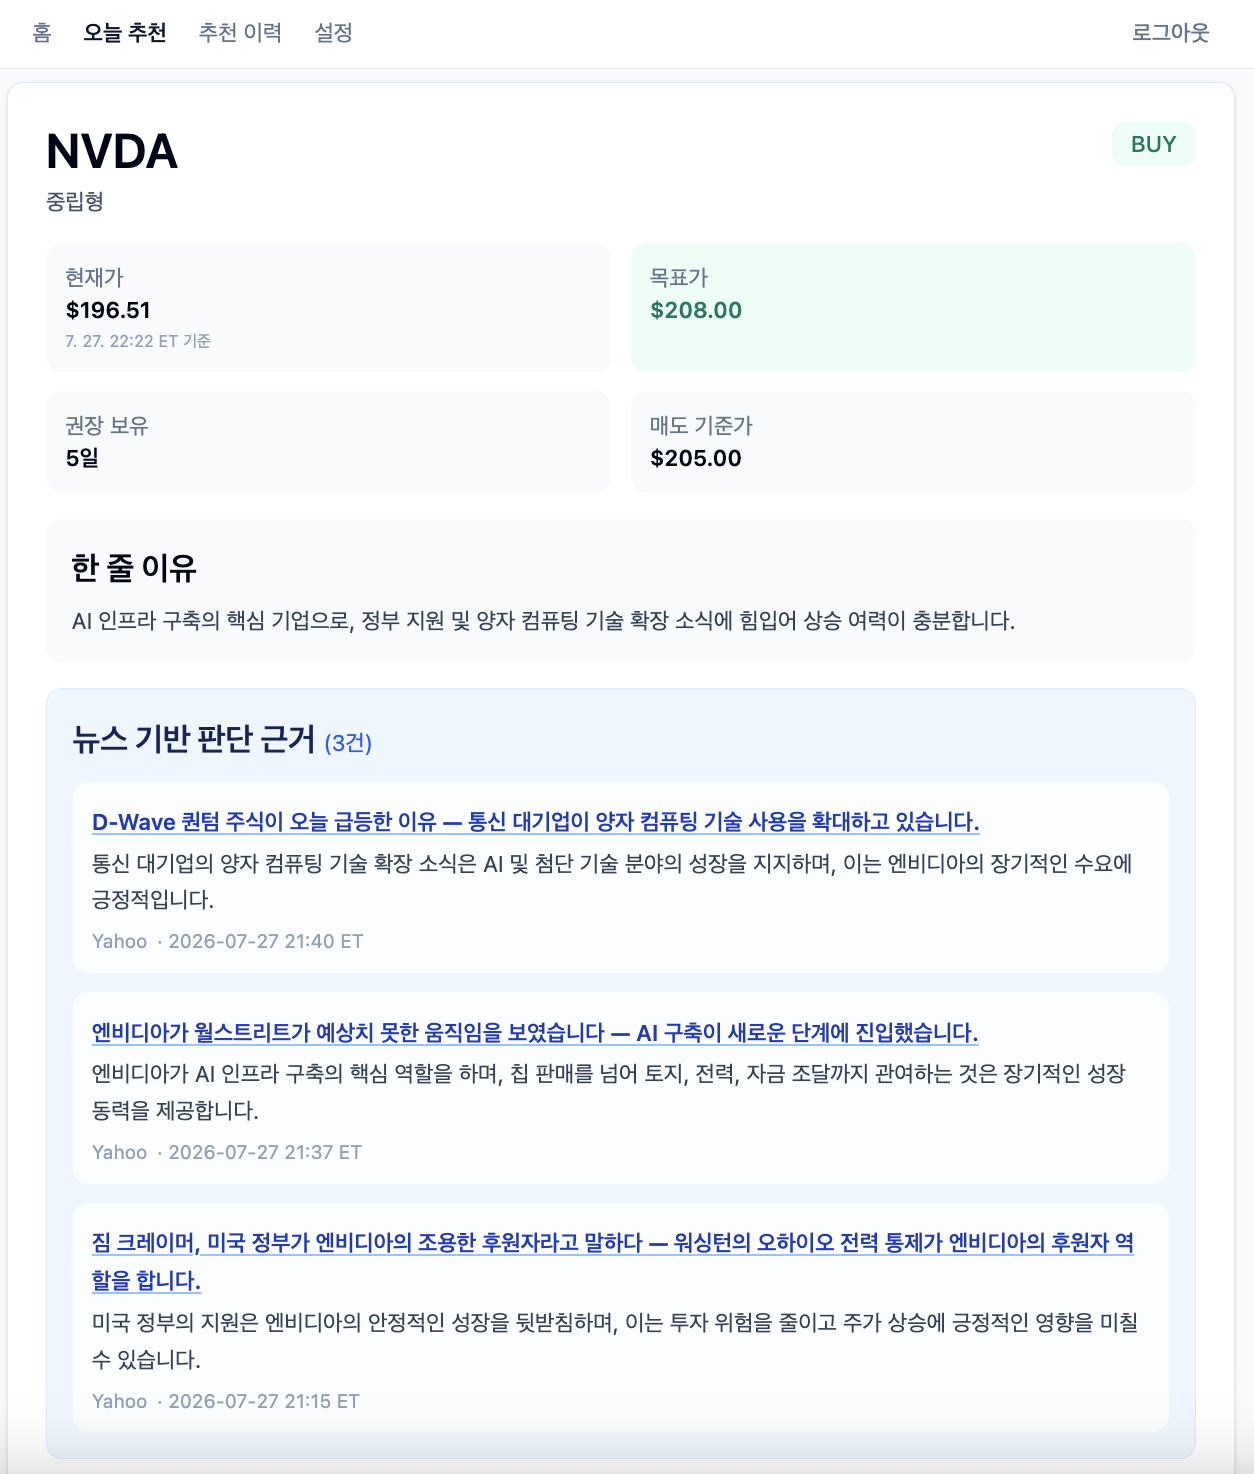
현재는 나 혼자만의 주식웹앱으로 사용 중, 7월 28일에 확인한 엔비디아 ㅎㅎㅎ kimi k3 와 창신메모리로 급락한 엔비디아... 추매를 할까 고민 중 ㅎ
 |
 |
'Side Projects > AI Stock Alarm' 카테고리의 다른 글
| [AI 주식 알람] 개발회고 2편: 배포하고 나서가 진짜 시작이었다 (0) | 2026.07.29 |
|---|---|
| [AI 주식 알람] Claude Code 서브에이전트를 6개로 나눈 기준 (0) | 2026.07.21 |
| [AI 주식 알람] 하나의 규칙, 세 개의 AI 도구: Cursor・Claude Code・Antigravity 동시 운영기 (0) | 2026.07.16 |
| [AI 주식 알람] SRS 한 줄이 커밋 20개가 되기까지: 요구사항을 태스크로 쪼개는 스킬 (0) | 2026.07.14 |
| [AI 주식 알람] PRD를 AI 에이전트가 읽게 만들기: SRS를 따로 쓰는 이유 (0) | 2026.07.13 |


