AI 주식 알람 앱을 만들기 전, 먼저 SRS(Software Requirements Specification)를 작성했다.
SRS를 작성하면 개발 방향이 명확해질 것이라고 생각했다. 그런데 문서를 완성하고 나니 또 다른 문제가 생겼다.
이 요구사항을 실제 개발 태스크로 누가, 어떤 기준으로 나눌 것인가?
예를 들어 REQ-FUNC-001 하나를 통째로 AI 에이전트에게 전달하면 백엔드, 프론트엔드, 데이터베이스, 테스트 코드가 하나의 작업에 뒤섞이기 쉽다.
결과적으로 변경 범위가 지나치게 커지고, 커밋 하나를 검토하기 위해 너무 많은 파일을 확인해야 한다. 문제가 발생했을 때 어느 단계에서 잘못됐는지 찾기도 어려워진다.
그래서 이번 프로젝트에서는 SRS를 태스크로 분해하는 절차 자체를 generate-tasks-from-srs라는 스킬로 만들었다.
목표는 단순했다.
어떤 AI 개발 도구를 사용하더라도 같은 SRS가 비슷한 크기의 태스크와 커밋으로 분해되게 만들기
이번 글에서는 SRS의 요구사항 한 줄이 실제 구현 태스크와 여러 개의 커밋으로 내려가는 과정을 정리한다.
1. 요구사항 하나가 태스크 하나일 필요는 없다
이 스킬을 만들면서 가장 먼저 정한 원칙은 다음과 같다.
SRS의 요구사항 단위와 개발 태스크의 단위는 다르다.
SRS는 기능을 테스트할 수 있고 모호하지 않은 형태로 작성한다. 반면 개발 태스크는 실제로 코드를 작성하고 검토할 수 있는 구현 단위로 나눠야 한다.
따라서 요구사항 하나가 여러 개의 백엔드, 프론트엔드, 데이터베이스, 인프라 태스크로 나뉘는 것은 자연스러운 일이다.
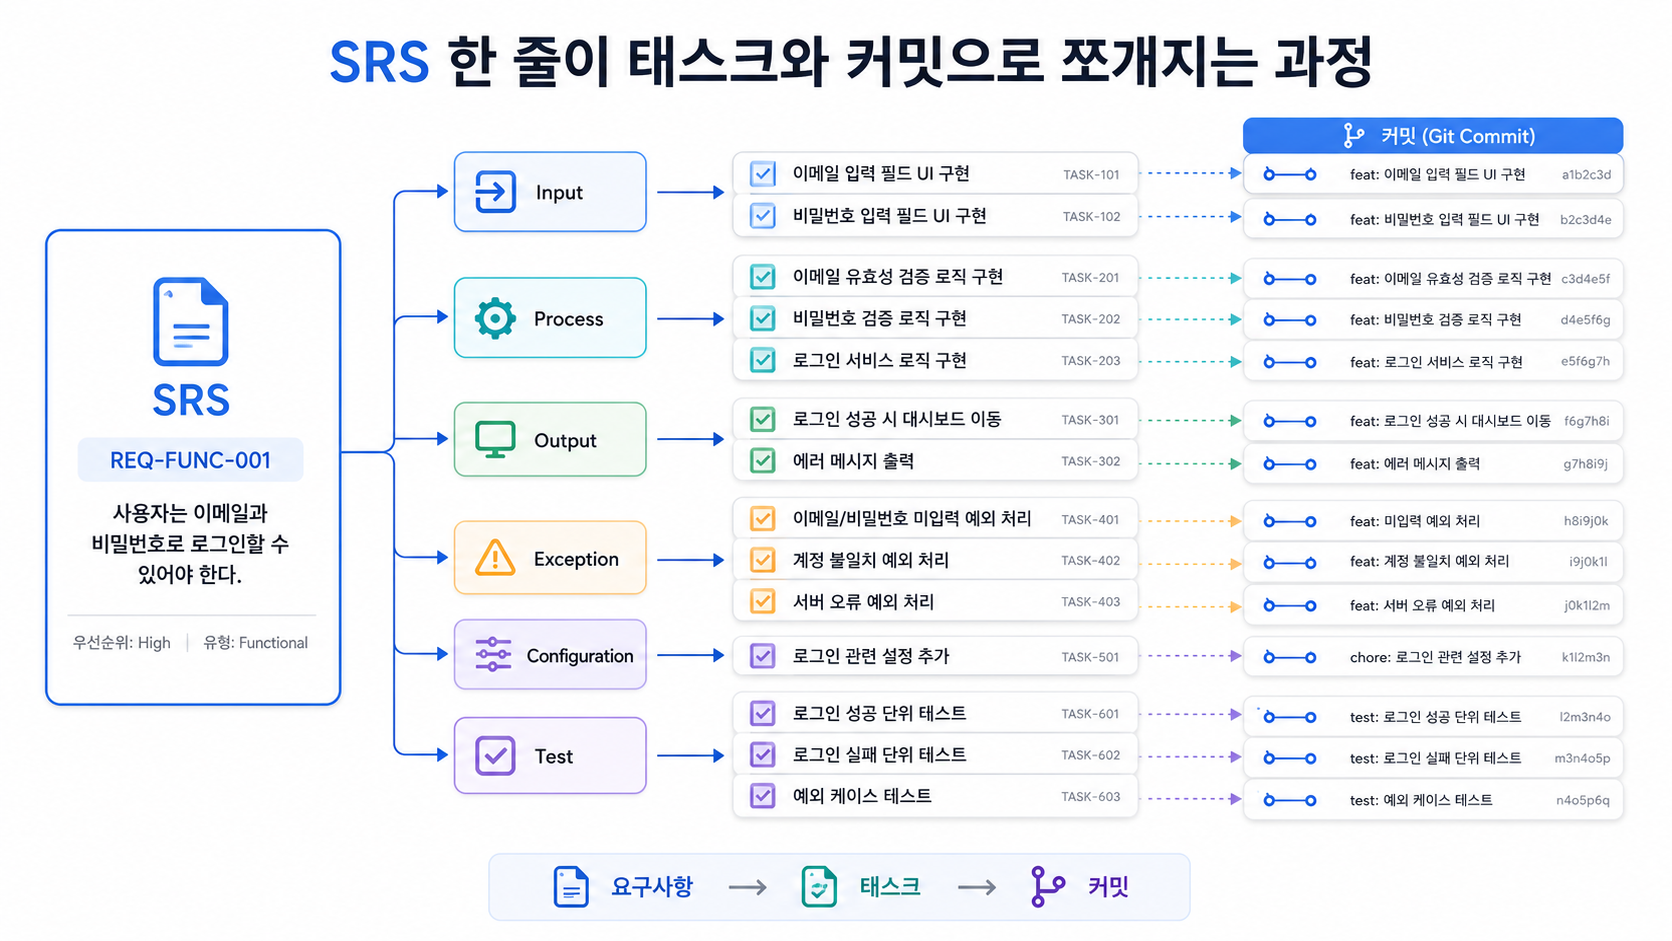
프로젝트에서는 요구사항을 다음 여섯 가지 관점으로 분해했다.
- Input: 어떤 데이터를 입력받는가
- Process: 입력을 어떻게 처리하는가
- Output: 어떤 결과를 반환하거나 표시하는가
- Exception: 실패하거나 데이터가 부족하면 어떻게 처리하는가
- Configuration: 환경변수, 권한, 캐시 등 어떤 설정이 필요한가
- Test: 무엇을 기준으로 정상 동작을 검증하는가
예를 들어 사용자가 관심 종목을 저장하는 요구사항 하나도 실제 구현에서는 다음과 같이 나뉠 수 있다.
관심 종목 입력값 정의
→ Zod 입력 스키마 작성
→ Server Action 구현
→ Prisma 저장 로직 연결
→ 중복 및 잘못된 종목 처리
→ 성공·실패 응답 정의
→ 단위 테스트 및 E2E 테스트 작성
SRS에는 한두 문장으로 적혀 있던 기능이지만, 코드 수준에서는 이미 여러 개의 독립적인 작업이 된다.
2. SRS의 AC가 태스크의 완료 조건이 된다
2편에서는 SRS의 인수 조건인 AC(Acceptance Criteria)를 Given / When / Then 형식으로 작성하는 과정을 다뤘다.
이 AC는 태스크를 생성할 때 다시 작성하지 않는다. 태스크의 완료 조건인 DoD(Definition of Done)로 그대로 옮긴다.
예를 들어 SRS에 다음과 같은 조건이 있다고 가정해 보자.
- 필수 필드 자동 채움률 ≥ 85%
- Validator 응답 속도 p95 ≤ 1.0초
- 누락 또는 형식 오류를 1초 이내 표시
태스크 문서에서는 문장을 체크박스로 바꾸면 된다.
- [ ] 필수 필드 자동 채움률이 85% 이상이다.
- [ ] Validator 응답 속도 p95가 1.0초 이하다.
- [ ] 누락 또는 형식 오류가 1초 이내 표시된다.
AC와 DoD를 각각 따로 작성하면 같은 조건을 여러 문서에서 반복해서 관리하게 된다. 시간이 지나면서 SRS와 태스크의 기준이 달라질 가능성도 커진다.
반대로 AC를 DoD로 직접 연결하면 다음과 같은 흐름이 만들어진다.
SRS 요구사항
→ Acceptance Criteria
→ Task 체크리스트
→ 테스트 코드
→ 구현 완료 검증
스킬을 만들면서 가장 많은 시간을 줄여준 부분도 여기에 있었다.
기존에는 태스크를 만들 때마다 “어디까지 구현해야 완료라고 볼 것인가”를 다시 고민해야 했다. 이제는 SRS에 정의한 AC가 완료 기준이 되기 때문에 별도의 기준을 새로 만들 필요가 없다.
3. 실제 커밋은 어떻게 나뉘었을까
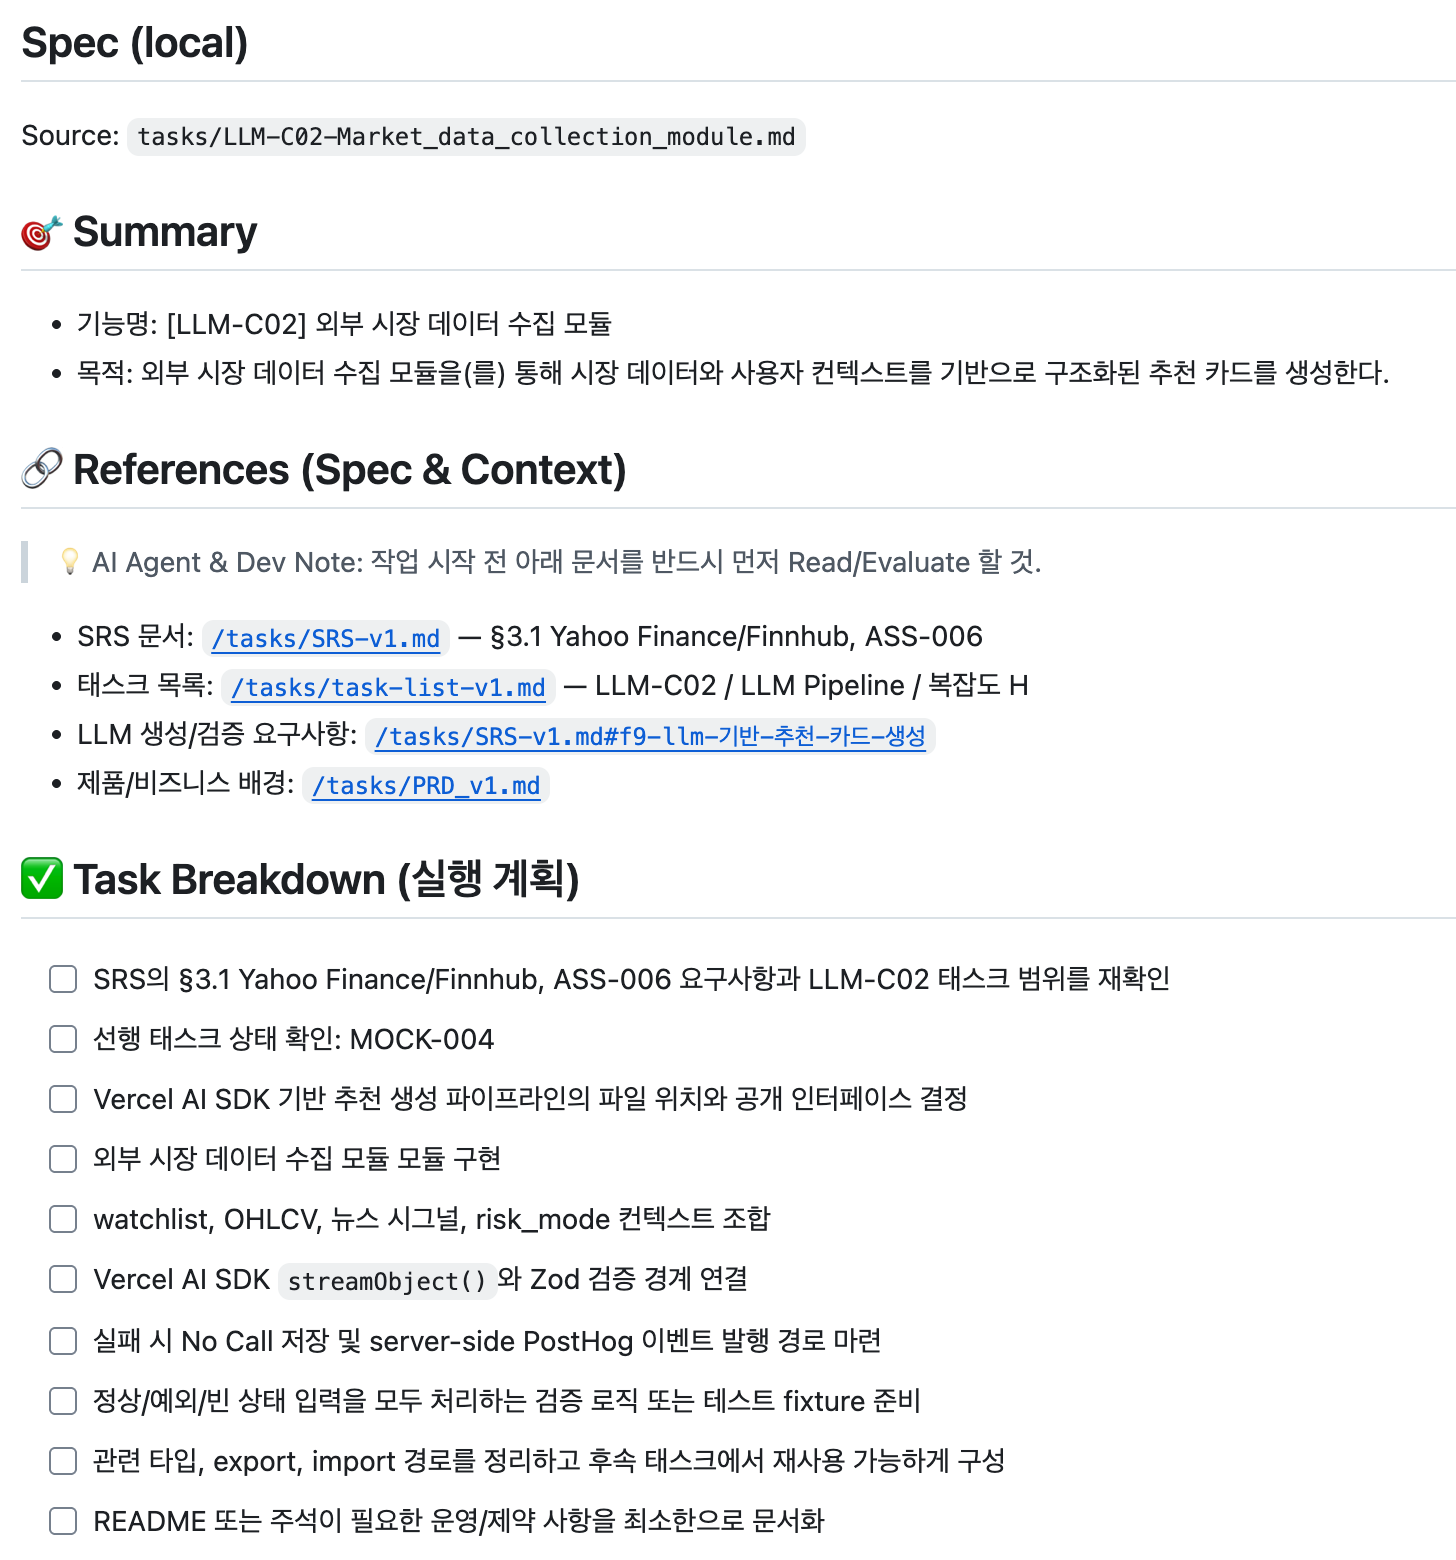
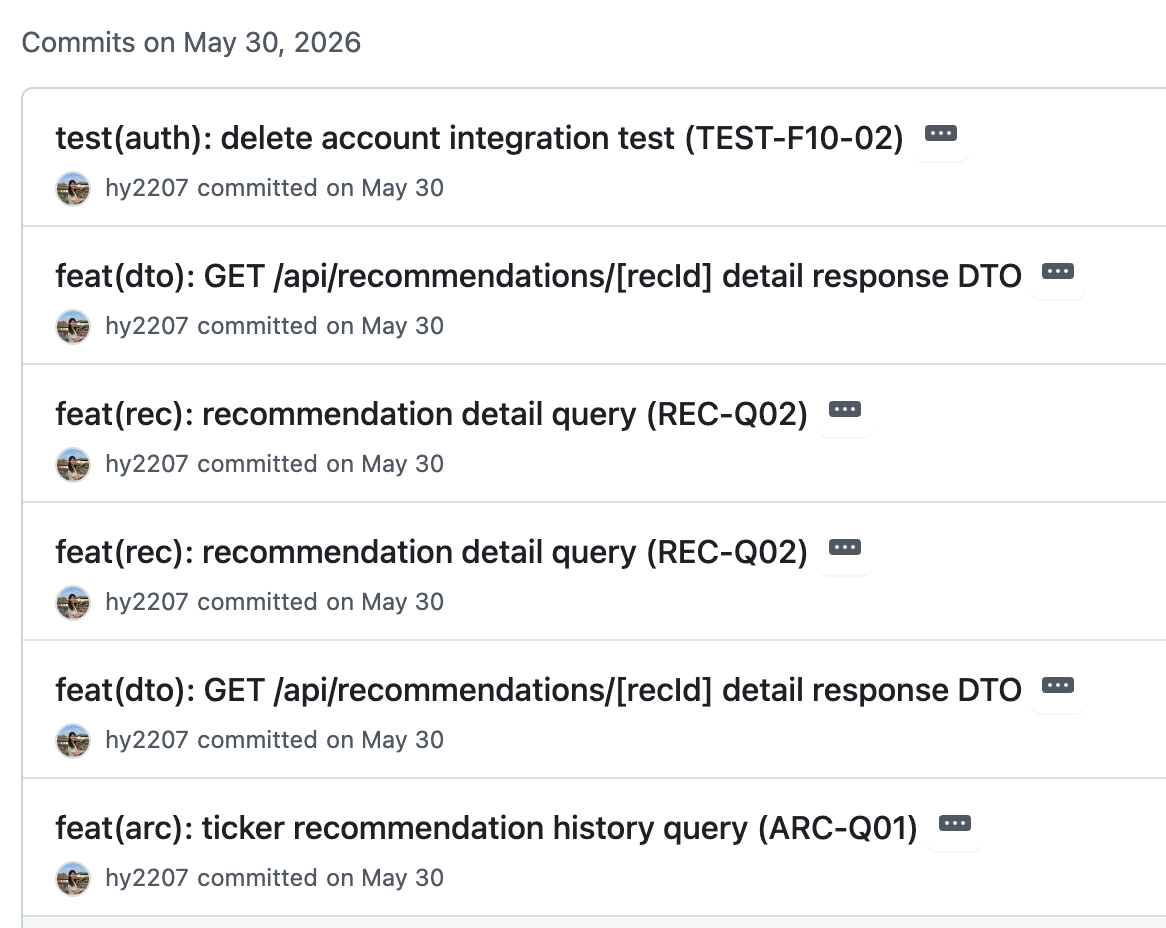
설명만으로는 다소 추상적일 수 있어, 실제 프로젝트의 커밋 로그를 가져왔다.
아래는 RecommendationCard를 비롯한 추천 기능의 데이터 모델과 DTO 기반을 구현한 구간이다.
7b27d7a feat(db): User model Zod validation schema and tests
078d802 feat(db): RiskProfile model Zod validation schema and tests
81ad09b feat(db): Watchlist model Zod validation schema and tests
b8c7bfb feat(db): RecommendationCard model Zod validation schema and tests
3a78200 feat(db): EvidenceSnapshot & PerformanceRecord Zod validation schemas and tests
026ba8e feat(db): Prisma initial migration for all 9 models
48a0452 feat(db): NextAuth.js compatible models (Account, Session, VerificationToken)
d5d4c0e feat(mock): user + riskProfile + watchlist mock data fixtures
861c833 feat(mock): 30-item PerformanceRecord mock data fixture
32ea8fe feat(mock): 3-card recommendation card mock data + no_call
28103c2 feat(dto): saveRiskProfile() Server Action input Zod schema
da9b356 feat(dto): saveWatchlist() Server Action input Zod schema
47e3b79 feat(dto): RecommendationCard output Zod schema (client-facing)
f5c0038 feat(dto): GET /api/recommendations/today response DTO
1cc7294 test(dto): reasonLine validation — length 1-160, whitespace rejection
이 구간만 해도 15개의 커밋으로 나뉘었다.
처음부터 “추천 카드 기능을 구현한다”는 하나의 큰 태스크로 진행했다면 데이터베이스 모델, 마이그레이션, Mock 데이터, Server Action, API 응답, 테스트 코드가 하나의 커밋에 들어갔을 가능성이 높다.
대신 다음과 같은 순서로 작업을 고정했다.
엔터티 정의
→ Zod 스키마
→ 데이터베이스 마이그레이션
→ Mock Fixture
→ Server Action 입력 DTO
→ API 응답 DTO
→ 필드 단위 검증 테스트
각 단계는 이전 단계의 결과를 입력으로 사용한다.
예를 들어 데이터 모델이 정해지기 전에 API 응답부터 만들지 않고, 스키마와 Mock 데이터가 준비된 다음 클라이언트에 전달할 DTO를 정의한다.
이 순서를 유지하면 AI 에이전트가 동시에 너무 많은 결정을 내리는 것을 막을 수 있다.
커밋마다 확인할 내용도 분명해진다.
- 스키마 커밋에서는 필드와 타입을 확인한다.
- Mock 커밋에서는 정상·예외 데이터가 충분한지 확인한다.
- DTO 커밋에서는 서버와 클라이언트의 계약을 확인한다.
- 테스트 커밋에서는 경계값과 실패 조건을 확인한다.
커밋 수는 늘어났지만, 한 번에 확인해야 하는 범위는 오히려 줄어들었다.
4. API도 인터페이스 단위로 분해한다
SRS Appendix에는 프로젝트에서 필요한 API와 Server Action 목록을 정리해 두었다.
generate-tasks-from-srs 스킬은 이 목록을 읽고, 각 인터페이스를 다시 여러 구현 태스크로 나눈다.
| 구분 | 실제 작업 예시 |
| 라우트·액션 시그니처 | app/api/recommendations/today/route.ts, saveWatchlist() |
| 입력·출력 스키마 | SaveWatchlistInput, RecommendationCardSchema |
| 서버 로직 | Prisma 쿼리, 캐시, LLM 호출 오케스트레이션 |
| 인증·권한 | NextAuth 세션, CRON_SECRET, 보호 경로 설정 |
| 예외 처리 | No Call 카드, LLM 실패 이벤트, 오류 응답 정책 |
| 클라이언트 연동 | PostHog 이벤트, 가격 복사, 브로커 이동 |
| 테스트 | 단위 테스트, 스키마 검증, E2E 테스트 |
API 엔드포인트 하나가 최대 일곱 개 정도의 태스크로 나뉘는 셈이다.
처음에는 지나치게 세분화한 것이 아닌가 생각했다. 하지만 실제로 작업해 보니 작은 태스크가 리뷰와 오류 추적에는 더 유리했다.
예를 들어 API 응답에 문제가 생겼을 때 다음 영역을 한꺼번에 살펴볼 필요가 없다.
데이터베이스 쿼리 문제인가?
DTO 변환 문제인가?
인증 문제인가?
클라이언트 렌더링 문제인가?
커밋이 역할별로 나뉘어 있으면 변경 이력과 테스트 결과를 따라가며 문제 지점을 좁힐 수 있다.
또한 AI 에이전트에게도 “추천 API를 전부 구현해”라고 요청하는 대신 다음처럼 범위를 제한할 수 있다.
RecommendationCardSchema를 기준으로
GET /api/recommendations/today 응답 DTO만 구현한다.

이 태스크에서는 Prisma 쿼리와 인증 로직을 수정하지 않는다.
이처럼 수정 가능한 범위와 수정하면 안 되는 범위를 함께 전달하면 예상하지 못한 파일 변경도 줄어든다.
5. NFR도 별도의 개발 태스크로 만든다
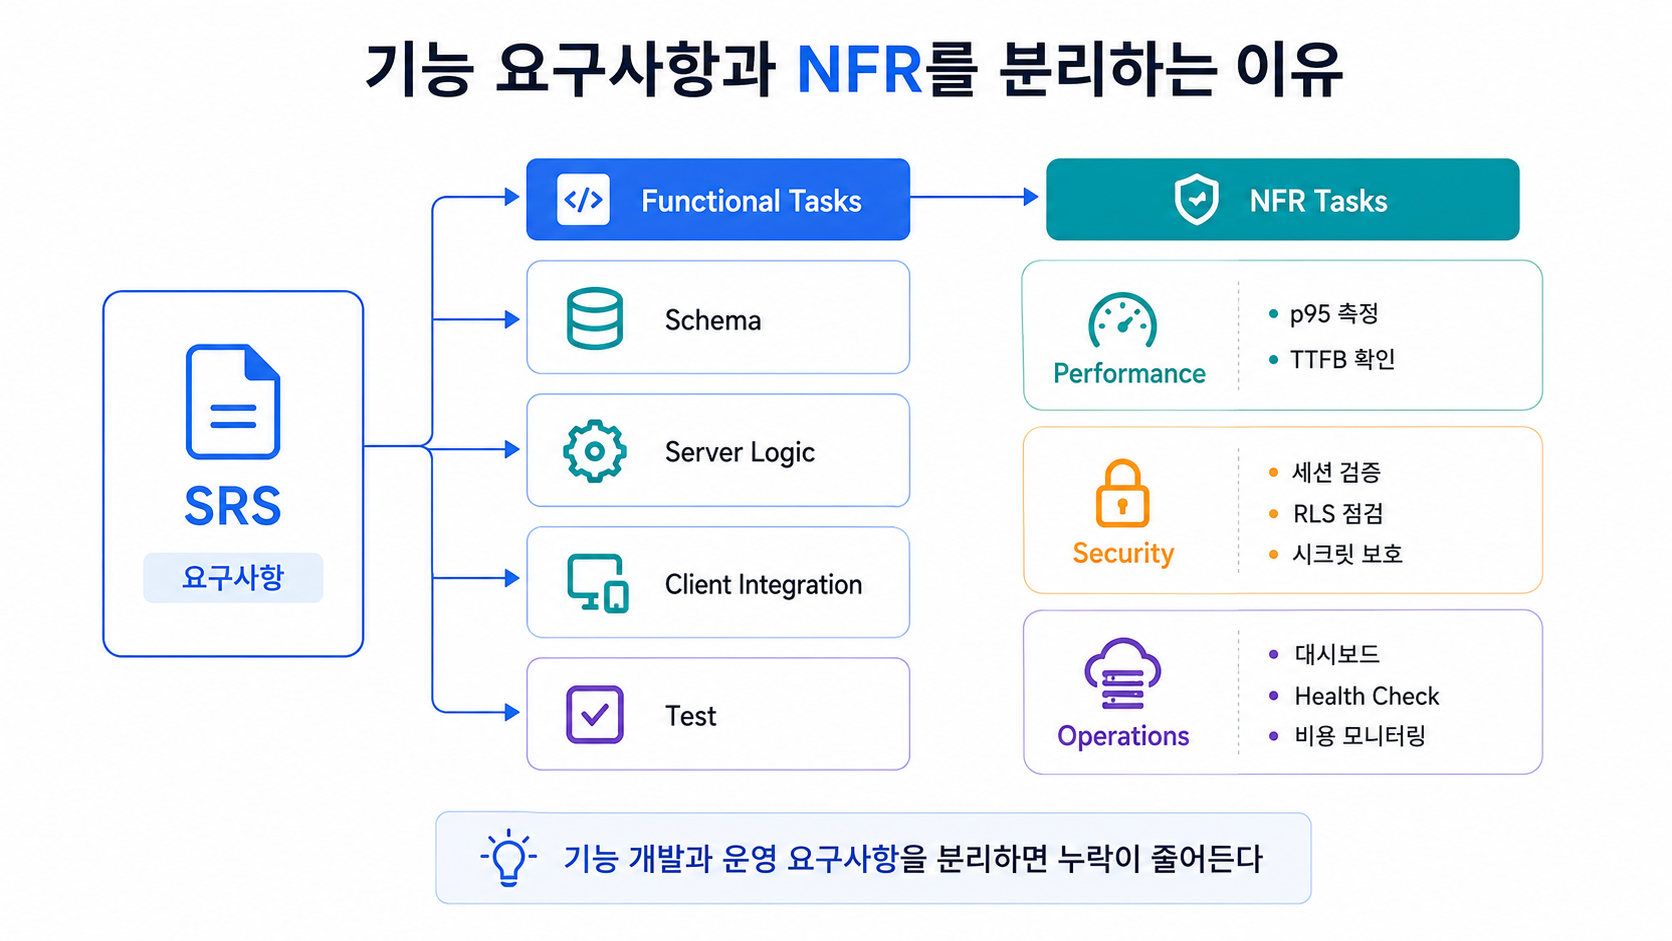
기능 요구사항뿐만 아니라 NFR(Non-Functional Requirement)도 태스크로 변환했다.
성능, 보안, 모니터링과 같은 항목은 기능 구현 태스크 안에 함께 넣으면 우선순위에서 밀리기 쉽다.
예를 들어 다음과 같은 성능 요구사항이 있다고 가정해 보자.
홈 추천 API의 응답 속도 p95는 800ms 이하여야 한다.
이를 단순히 API 구현 태스크의 체크리스트 한 줄로 넣는 대신, 별도의 성능 검증 태스크로 분리한다.
성능
- k6 또는 Playwright로 /api/recommendations/today 응답 속도 측정
- p50, p95, p99 지표 기록
- LLM 응답의 TTFB(Time to First Byte) 측정
- 캐시 적용 전후 결과 비교
- 성능 기준을 초과했을 때 실패하도록 테스트 구성
보안
- NextAuth 세션 검증
- OAuth 스코프 최소화
- Supabase RLS 정책 점검
- 보호가 필요한 API와 페이지 경로 확인
- 로그와 커밋에 시크릿이 포함되지 않는지 검사
운영
- PostHog 이벤트와 대시보드 구성
- /api/admin/health 데이터 최신성 확인
- Gemini API와 OneSignal 사용량 모니터링
- 외부 API 실패 및 재시도 횟수 기록
- 주요 장애 조건에 대한 알림 설정
기능이 동작한다고 해서 서비스가 완성되는 것은 아니다.
응답 시간이 지나치게 길거나, 인증되지 않은 사용자가 데이터에 접근할 수 있거나, 외부 API 장애를 확인할 방법이 없다면 실제 서비스로 운영하기 어렵다. NFR을 별도 트랙으로 분리하면 기능 구현이 끝난 뒤 시간이 남을 때 처리하는 부가 작업이 아니라, 처음부터 완료해야 하는 개발 범위가 된다.
6. 태스크를 작게 나누면서 지킨 기준
태스크를 많이 만드는 것이 항상 좋은 것은 아니다.
파일 한 줄을 수정할 때마다 새로운 태스크를 만드는 식으로 지나치게 세분화하면 작업 흐름을 이해하기 어려워진다.
이번 프로젝트에서는 다음 기준을 사용했다.
- 하나의 태스크는 하나의 목적만 가진다
스키마 정의와 화면 구현처럼 검토 기준이 다른 작업은 분리한다. - 독립적으로 테스트할 수 있어야 한다
태스크를 완료했을 때 단위 테스트, 스키마 파싱, API 응답 등 확인할 수 있는 결과가 있어야 한다. - 커밋 메시지 한 줄로 변경 내용을 설명할 수 있어야 한다
커밋 메시지에 and가 반복된다면 작업 범위가 너무 넓을 가능성이 높다.
feat: add schema and API and UI and tests
이런 커밋보다는 다음과 같이 목적을 나누는 편이 낫다.
feat(dto): add RecommendationCard output schema
feat(api): add today recommendation response
test(dto): validate recommendation reasonLine
- 다음 태스크의 입력이 명확해야 한다
스키마가 Mock 데이터의 입력이 되고, Mock 데이터가 API 구현과 화면 연결의 입력이 되는 식으로 작업 간 의존 관계가 보여야 한다. - 실패했을 때 되돌릴 수 있어야 한다
하나의 커밋을 되돌렸을 때 관련 없는 기능까지 함께 사라지지 않아야 한다.
7. AI 에이전트에게 필요한 것은 더 긴 프롬프트가 아니었다
처음에는 AI 에이전트가 큰 기능을 한 번에 구현하지 못하면 프롬프트가 부족한 것이라고 생각했다.
그래서 배경 설명, 기술 스택, 예외 조건을 계속 추가했다. 하지만 프롬프트가 길어진다고 작업 범위가 자동으로 적절해지는 것은 아니었다.
더 중요했던 것은 에이전트에게 한 번에 맡기는 결정의 수를 줄이는 일이었다.
다음 요청을 비교해 보면 차이가 분명하다.
사용자의 관심 종목을 저장하고
오늘의 추천 카드에 반영하는 기능을 구현해 줘.
이 요청에는 데이터 모델, 입력 검증, 저장 로직, API, UI, 예외 처리 등 여러 결정이 포함된다.
반면 태스크를 나눈 뒤에는 다음처럼 요청할 수 있다.
Watchlist Prisma 모델을 기준으로
saveWatchlist() Server Action의 입력 Zod 스키마를 작성한다.

허용 종목 수와 ticker 형식을 검증하고,
서버 저장 로직과 UI는 수정하지 않는다.

완료 후 정상 입력, 빈 배열, 중복 ticker,
허용 개수 초과에 대한 테스트를 작성한다.
AI 에이전트의 성능이 달라진 것이 아니라, 에이전트가 해결해야 하는 문제의 경계를 먼저 정한 것이다.
결국 중요한 것은 “어떤 모델을 사용할 것인가”보다 “모델이 한 번에 몇 개의 결정을 내리게 할 것인가”에 가까웠다.
8. 마무리
SRS를 작성하는 것만으로 구현이 자동으로 잘게 나뉘지는 않는다.
SRS는 무엇을 만들어야 하는지 설명하지만, 실제 개발을 위해서는 이를 코드, 설정, 테스트, 배포 단위로 다시 분해해야 한다.
이번 프로젝트에서는 그 분해 절차를 generate-tasks-from-srs 스킬로 문서화했다.
덕분에 새로운 요구사항이 추가되더라도 다음과 같은 흐름을 반복할 수 있게 됐다.
SRS 요구사항
→ Acceptance Criteria
→ 구현 영역 분류
→ 엔터티와 인터페이스 정의
→ 스키마
→ Mock 데이터
→ DTO
→ 서버 로직
→ 클라이언트 연동
→ 테스트
→ 커밋
중요한 점은 커밋 수를 늘리는 것 자체가 아니다.
각 커밋의 목적과 완료 기준을 명확하게 만들고, AI 에이전트가 한 번에 처리해야 하는 범위를 통제하는 것이 핵심이다.
결과물이 에이전트의 순간적인 판단이나 “느낌”에 따라 달라지는 것이 아니라, 반복할 수 있는 절차를 따르게 만들고 싶었다.
다음 편에서는 이 태스크와 스킬을 Cursor, Claude Code, Antigravity가 함께 참조할 수 있도록 구성한 공통 하네스 구조를 다룰 예정이다.
프로젝트 저장소
https://github.com/hy2207/ai-stock-alarm-app
GitHub - hy2207/ai-stock-alarm-app
Contribute to hy2207/ai-stock-alarm-app development by creating an account on GitHub.
github.com
'Side Projects > AI Stock Alarm' 카테고리의 다른 글
| [AI 주식 알람] Claude Code 서브에이전트를 6개로 나눈 기준 (0) | 2026.07.21 |
|---|---|
| [AI 주식 알람] 하나의 규칙, 세 개의 AI 도구: Cursor・Claude Code・Antigravity 동시 운영기 (0) | 2026.07.16 |
| [AI 주식 알람] PRD를 AI 에이전트가 읽게 만들기: SRS를 따로 쓰는 이유 (0) | 2026.07.13 |
| [AI 주식 알람] 시장조사 없이 시작한 기능 목록은 왜 산으로 가는가: Pain 지표로 PRD 자르기 (0) | 2026.07.10 |
| [AI 주식 알람] 3개월짜리 개인 프로젝트 시작 (0) | 2026.07.08 |


