Anthropic이 2026년 6월 30일 새로운 모델 Claude Sonnet 5를 공개했다.
이번 모델은 단순히 질문에 더 정확하게 답하는 것을 넘어, 계획을 세우고 브라우저나 터미널 같은 도구를 사용하며 복잡한 작업을 끝까지 수행하는 에이전트 성능에 초점을 맞췄다.
Anthropic은 Sonnet 5를 지금까지 출시한 Sonnet 계열 중 가장 에이전트다운 모델이라고 소개하고 있다.
Sonnet 5의 핵심은 에이전트 성능
기존 Sonnet 모델도 코딩과 도구 사용 능력이 강했지만, 복잡하고 긴 작업에서는 상위 모델인 Opus 계열과 차이가 있었다.
Sonnet 5는 이 차이를 줄이는 것을 목표로 한다. Anthropic에 따르면 Sonnet 4.6보다 다음 영역이 전반적으로 향상됐다.
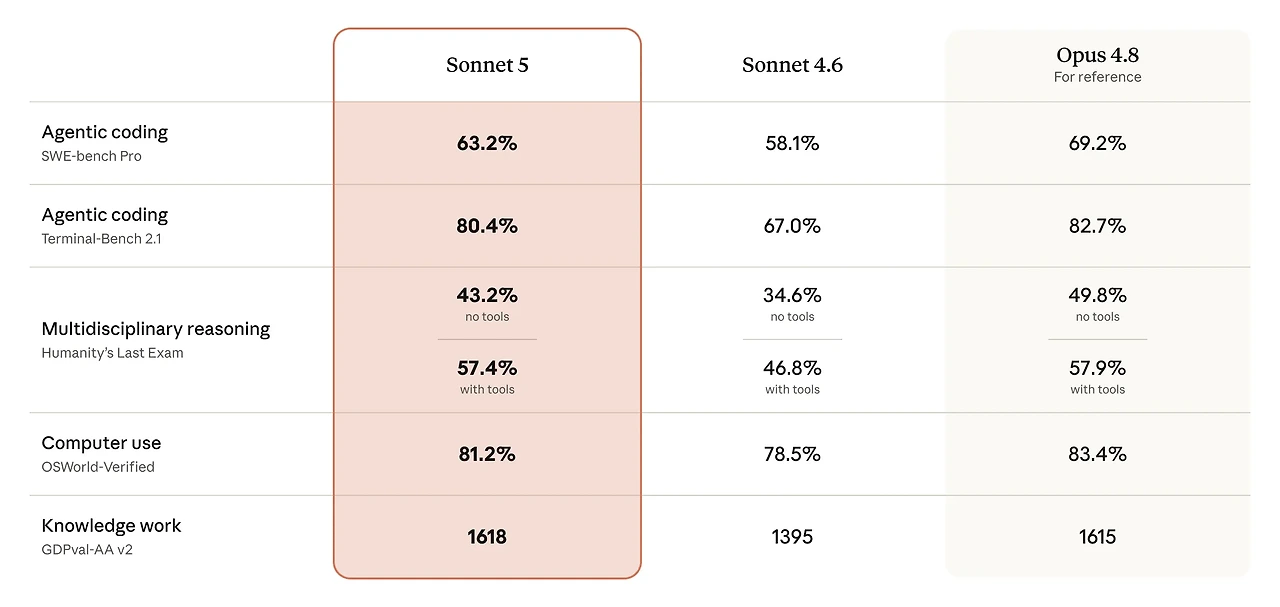
특히 이전 Sonnet 모델이 작업 중간에 멈추던 상황에서도 Sonnet 5는 더 긴 흐름을 유지하고, 별도의 지시가 없어도 스스로 결과를 확인하는 경향을 보였다고 한다.
예를 들어 개발 작업에서는 단순히 코드를 작성하는 데 그치지 않고 다음 과정을 하나의 흐름으로 처리할 수 있다.
문제 분석 → 오류 재현 → 테스트 작성 → 코드 수정 → 테스트 실행 → 결과 검증
결국 Sonnet 5는 코드를 생성하는 모델이라기보다, 실제 작업을 실행하고 마무리하는 모델에 가까워졌다고 볼 수 있다.
일부 작업에서는 Opus 4.8에 근접
Sonnet 5의 또 다른 특징은 상위 모델인 Claude Opus 4.8에 가까운 성능을 더 낮은 비용으로 제공한다는 점이다.
사용자는 작업에 투입할 추론량을 조절하는 effort 설정을 사용할 수 있다. 중간 수준의 effort에서는 비용 효율성을 높일 수 있고, 높은 effort에서는 일부 에이전트 검색과 컴퓨터 사용 작업에서 Opus 4.8과 비슷한 성능을 낼 수 있다고 Anthropic은 설명한다.
모든 영역에서 Opus를 대체한다는 의미는 아니다. 그러나 일상적인 코딩, 자료 조사, 브라우저 자동화, 사내 업무 처리처럼 반복적으로 모델을 사용해야 하는 환경에서는 Sonnet 5가 비용과 성능 사이의 실용적인 선택지가 될 수 있다.
Claude Code에서도 사용할 수 있다
Sonnet 5는 발표와 동시에 다음 서비스에 적용됐다.
- Claude Free 및 Pro의 기본 모델
- Claude Max, Team, Enterprise
- Claude Code
- Claude Platform API
API에서는 다음 모델 ID를 사용한다.
claude-sonnet-5
따라서 Claude Code를 사용하던 개발자라면 모델을 교체해 기존 프로젝트의 분석, 수정, 테스트와 같은 작업에서 성능 변화를 직접 확인할 수 있다.
가격은 얼마일까?
Sonnet 5에는 2026년 8월 31일까지 출시 프로모션 가격이 적용된다.
| 구분 | 프로모션 가격 | 이후 기본 가격 |
| 입력 토큰 100만 개 | 2달러 | 3달러 |
| 출력 토큰 100만 개 | 10달러 | 15달러 |
비교하면 Opus 4.8은 입력 100만 토큰당 5달러, 출력 100만 토큰당 25달러다. Sonnet 5는 Opus보다 낮은 비용으로 일부 작업에서 비슷한 수준의 에이전트 성능을 제공하는 것을 강점으로 내세우고 있다.
다만 Sonnet 5에는 새로운 토크나이저가 적용됐다. 동일한 입력도 콘텐츠에 따라 Sonnet 4.6보다 약 1.0~1.35배 많은 토큰으로 계산될 수 있다. 따라서 모델 비용을 비교할 때는 토큰당 가격뿐 아니라 실제 토큰 사용량과 작업 완료율까지 함께 살펴볼 필요가 있다. Anthropic은 출시 프로모션 가격이 Sonnet 4.6에서 전환할 때의 실질적인 비용 증가를 줄이도록 설정됐다고 설명한다.
안전성도 개선
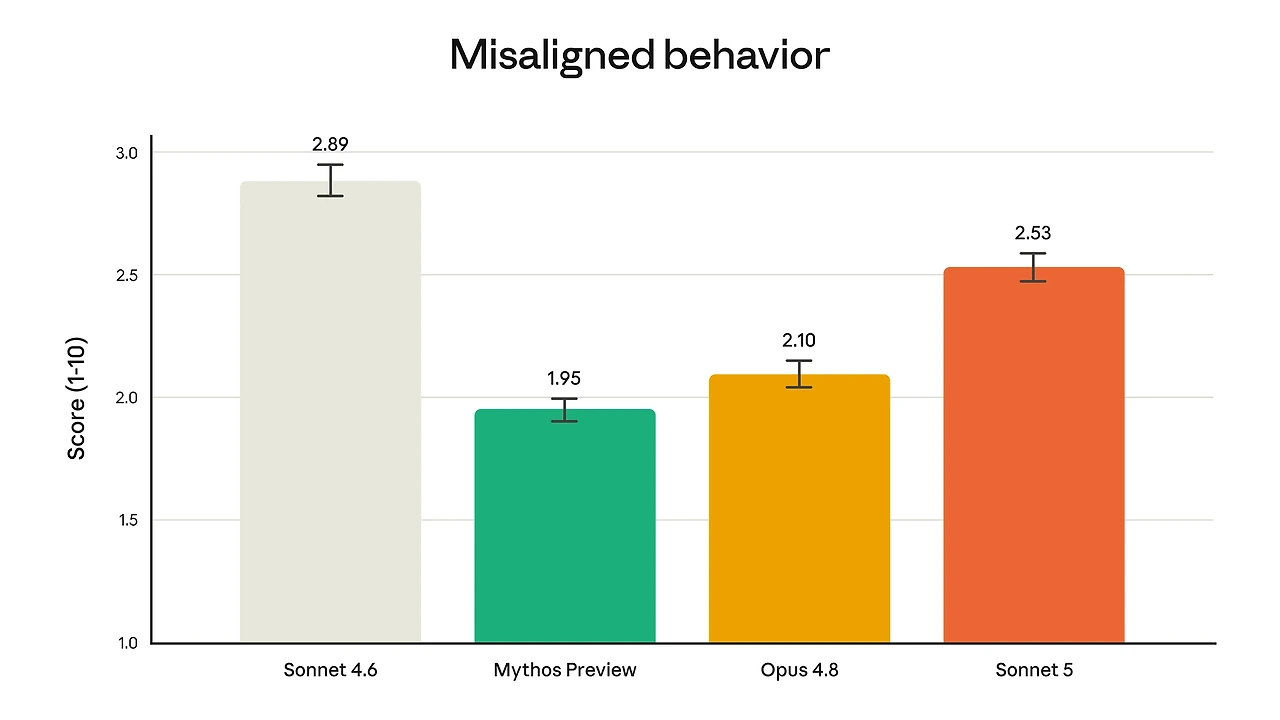
Anthropic의 평가에서 Sonnet 5는 Sonnet 4.6보다 악의적인 요청을 더 잘 거부하고, 프롬프트 인젝션과 에이전트 탈취 시도에 대한 저항성이 향상됐다.
 |
 |
환각과 사용자의 의견에 무조건 동조하는 성향도 감소했으며, 자동화된 행동 평가에서도 Sonnet 4.6보다 전반적으로 안전한 결과를 보였다. 다만 일부 평가에서는 Opus 4.8이나 Mythos Preview보다 부적절한 행동 비율이 높게 나타났다.
사이버보안 능력은 상위 Opus 모델보다 의도적으로 낮게 유지됐으며, 위험한 보안 작업을 실시간으로 탐지하고 차단하는 보호 장치도 기본 적용된다.
마무리
Claude Sonnet 5의 핵심은 다음 한 문장으로 정리할 수 있다.
Sonnet의 가격대에서 Opus에 가까운 에이전트 실행 능력을 제공하는 모델
이번 발표에서 중요한 부분은 단순한 벤치마크 점수 상승이 아니다. 이전에는 개발자가 작업을 작은 단계로 나누어 계속 지시해야 했다면, Sonnet 5는 하나의 목표를 전달받아 계획 수립부터 도구 사용, 실행, 결과 검증까지 더 긴 흐름을 담당하는 방향으로 발전했다.
특히 Claude Code나 업무 자동화 에이전트를 사용하는 입장에서는 모델이 얼마나 좋은 답변을 생성하는지를 넘어, 복잡한 작업을 중간에 멈추지 않고 어디까지 완수할 수 있는지가 중요한 평가 기준이 될 것으로 보인다.
참고자료
- Anthropic, Introducing Claude Sonnet 5 https://www.anthropic.com/news/claude-sonnet-5
'Tech News' 카테고리의 다른 글
| GPT-5.6 Sol, Terra, Luna 공개: OpenAI가 말하는 다음 AI 사용 방식 (0) | 2026.07.10 |
|---|---|
| 마이크로소프트 Frontier Company, 기업의 AI 도입을 현장에서 완성하려는 전략 (1) | 2026.07.06 |
| OpenAI GPT-5.6 Sol 공개: 성능부터 추론 모드, 가격까지 (0) | 2026.06.29 |
| 하나의 모델보다 AI 팀을 만드는 방법: Sakana AI의 Fugu (0) | 2026.06.22 |
| 바이브 코딩 이후의 개발은 어떻게 달라질까: Google이 정리한 새로운 SDLC (0) | 2026.06.22 |


